8.2 非参数检验:卡方拟合优度与KS检验
8.2 非参数检验:卡方拟合优度与 KS 检验
本节摘要:参数检验假设分布族已知,非参数检验对"分布形状本身"做裁决。卡方拟合优度检验把样本分箱后比较观测频数与期望频数,统计量 Σ(O−E)²/E 在 H₀ 下渐近卡方;KS 检验直接度量经验分布函数与理论 CDF 的最大距离,对小样本连续分布更敏锐。本节完整执行"骰子是否均匀"与"数据是否正态"两个案例,给出两检验的适用边界。
当问题变成"这分布对不对"
前两章检验的都是参数(均值、比例、方差),前提是"分布族选对了"。但质检员真正的疑心常是更根本的:这颗骰子均匀吗?这批数据真来自正态吗?——被检验对象从参数升级为分布本身。两个主力工具:
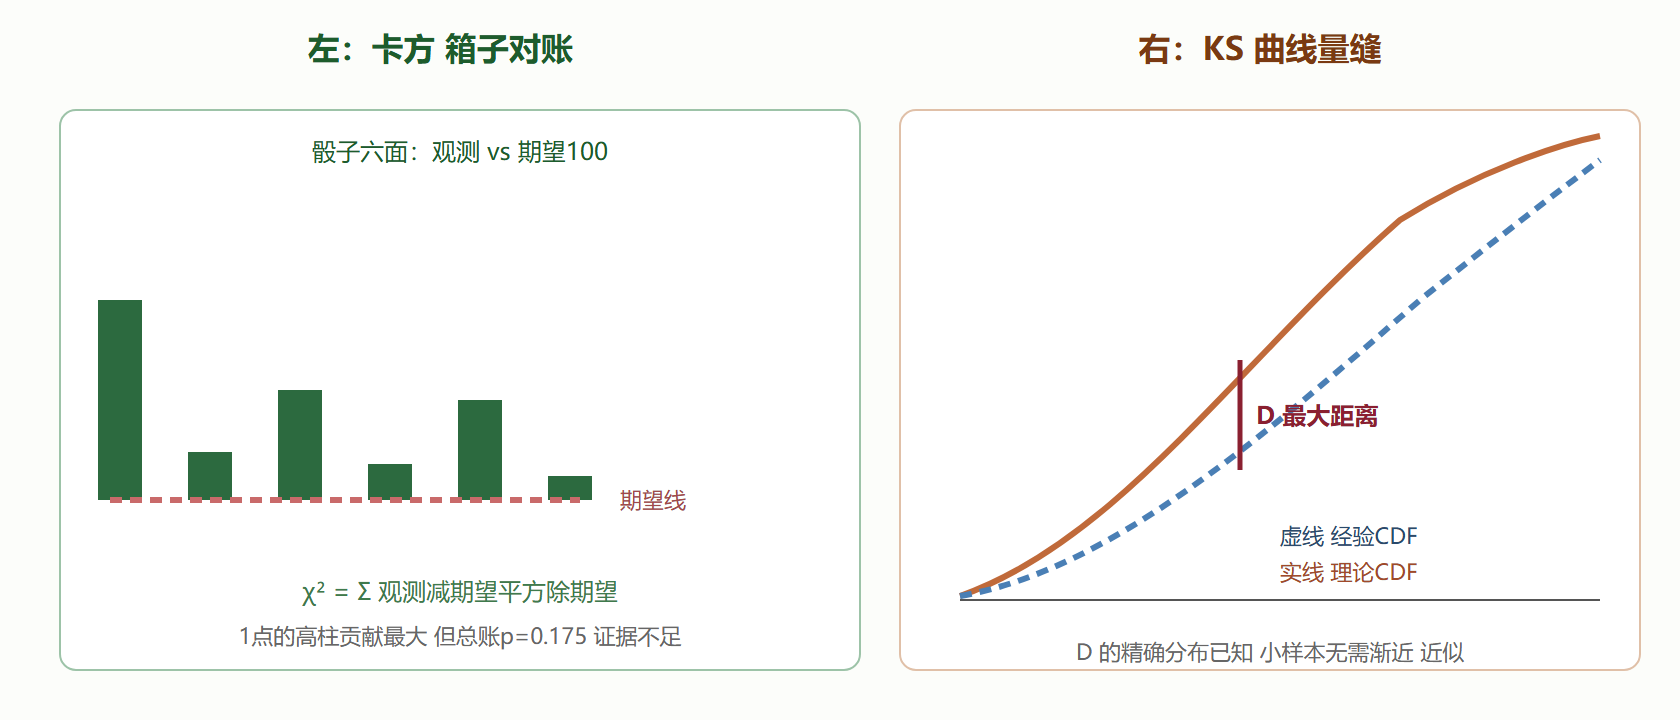
- 卡方拟合优度检验(K. 皮尔逊,1900):分箱,χ² = Σ(Oᵢ−Eᵢ)²/Eᵢ,H₀ 下渐近 χ²(箱数−1−估计参数数)
- KS 检验(Kolmogorov–Smirnov):D = max|Fₙ(x) − F(x)|——经验 CDF 与理论 CDF 的最大竖直距离,精确分布已知(连续情形)
案例一:这颗骰子灌铅了吗
怀疑骰子不均匀,掷 600 次记录各面频数。H₀:pᵢ=1/6。手算 χ² 再交 SciPy 复核:
import numpy as np from scipy import stats obs = np.array([118, 88, 102, 93, 101, 98]) # 六面观测频数 n = obs.sum() exp = np.full(6, n/6) chi2_stat = ((obs - exp)**2 / exp).sum() p_manual = stats.chi2.sf(chi2_stat, df=5) res = stats.chisquare(obs) print(f"手算 χ²={chi2_stat:.3f} p={p_manual:.4f}") print(f"SciPy χ²={res.statistic:.3f} p={res.pvalue:.4f}") # 各面偏差明细:哪个面贡献最大 contrib = (obs - exp)**2 / exp print("各面贡献:", contrib.round(2), " 最大贡献面:", contrib.argmax()+1)
χ²≈7.66、p≈0.175——证据不足以判骰子不均匀(1 点偏多是抽样波动可解释的)。若频数改成 [130,85,105,90,95,95],χ² 跳到 14.9、p<0.01,拒绝 H₀。期望频数不能太小是卡方检验的硬规矩:任一箱期望频数 <5 时渐近失真,须并箱——这条规矩在低频类目(如稀有缺陷类型)的分箱设计时就得提前算好。
案例二:这批数据是正态吗
机器零件长度 120 个,想用 t 检验但需先验证正态性。两条路对照:
import numpy as np from scipy import stats rng = np.random.default_rng(99) x_norm = rng.normal(50, 2, 120) # 真正态 x_skew = rng.chisquare(3, 120)*2 + 44 # 右偏数据 均值接近50 for name, x in [("近正态样本", x_norm), ("右偏样本", x_skew)]: ks_stat, ks_p = stats.kstest((x-x.mean())/x.std(), "norm") # 注意:参数由样本估计时 KS 的标准 p 值偏保守,正态性专用 Lilliefors 版本: lillie = stats.normaltest(x) # D'Agostino 偏度峰度联合检验 sw = stats.shapiro(x) # Shapiro-Wilk 小样本主力 print(f"{name}: KS p={ks_p:.4f} D'Agostino p={lillie.pvalue:.4f}" f" Shapiro p={sw.pvalue:.4f}")
近正态样本三法 p 值都大(不拒绝正态);右偏样本三法齐声拒绝——分布形状检验的任务是"拦住错误模板",而非证明模板正确。"不拒绝正态"只说明偏离未超出检出能力,大样本下 KS 对参数估计的处理要谨慎(Shapiro-Wilk 与 D'Agostino 是正态性检查的实务首选)。
KS 的独门优势:两样本比较与逐点距离
KS 不止能对理论分布,还能两个经验分布互比(两样本 KS)——比较两个版本页面的响应时间分布、两个供应商的尺寸分布,不必假设任何形状。D 统计量有直观读法:两条经验 CDF 曲线的最大竖直缝:
import numpy as np from scipy import stats rng = np.random.default_rng(120) a = rng.normal(100, 5, 200) # 供应商A b = rng.normal(103, 5, 180) # 供应商B 真实中心偏移3 ks2 = stats.ks_2samp(a, b) t2 = stats.ttest_ind(a, b) print(f"两样本 KS: D={ks2.statistic:.3f} p={ks2.pvalue:.2e}") print(f"Welch t : t={t2.statistic:.2f} p={t2.pvalue:.2e}") # 形状相同仅平移时两法结论一致;形状不同时 KS 检出的是分布差异本身 c = rng.exponential(5, 200) print("形状迥异(同均值):", stats.ks_2samp(a, c)[:2])
KS 对"形状差异"敏感而 t 只盯均值——当分布形状本身就重要(可靠性、风控),KS 与分位数比较比均值检验更贴近业务问题。
图 8-2 卡方分箱对比与 KS 最大距离的对偶视角
两检验的适用边界
| 维度 | 卡方拟合优度 | KS |
|---|---|---|
| 数据类型 | 分箱频数(离散天然分箱) | 连续(对离散需修正) |
| 比较对象 | 多项分布 / 分箱后任意分布 | 连续 CDF,含两样本互比 |
| 样本量要求 | 每箱期望 ≥5,大样本渐近 | 小样本可用精确分布 |
| 敏感方向 | 整体频数偏离 | 中部形状(尾部因经验 CDF 饱和不敏感) |
| 参数估计后 | 自由度扣除即可 | 标准版偏保守,正态性用 Lilliefors/ Shapiro |
实务口诀:离散对账用卡方、连续量缝用 KS、专查正态用 Shapiro;期望频数不足先并箱;尾部形状敏感的场合(风控极端值)改用 Anderson–Darling 类加权统计量。
本节要点回顾
- 非参数检验的对象是分布形状本身:不假设分布族,模板错误在前端被拦截
- 卡方统计量 Σ(O−E)²/E 渐近卡方分布,自由度 = 箱数−1−估计参数数
- 期望频数 ≥5 硬规矩:低频类目设计分箱时就算好,不足并箱
- KS 用经验 CDF 的最大距离 D,精确分布已知、小样本可用、支持两样本互比
- 参数由样本估计时 KS 偏保守:正态性检查实务选 Shapiro-Wilk / D'Agostino
- 检验任务是拦截而非证明:"不拒绝"只是未检出偏离,不等于模板正确