8.1 充分统计量与最优无偏估计
8.1 充分统计量与最优无偏估计
本节摘要:充分统计量 T 把样本中关于参数的全部信息无损压缩——给定 T 后样本的条件分布不再依赖参数;Neyman-Fisher 分解定理给出判定:似然能拆成"只含 T 与 θ"乘"不含 θ"即充分。拉奥-布莱克韦尔定理用条件期望机器把任意无偏估计改造成只依赖 T 的更好估计,配合完备性得到 UMVUE。本节全程手推泊松例子并模拟对照方差改善。
为什么要压缩数据
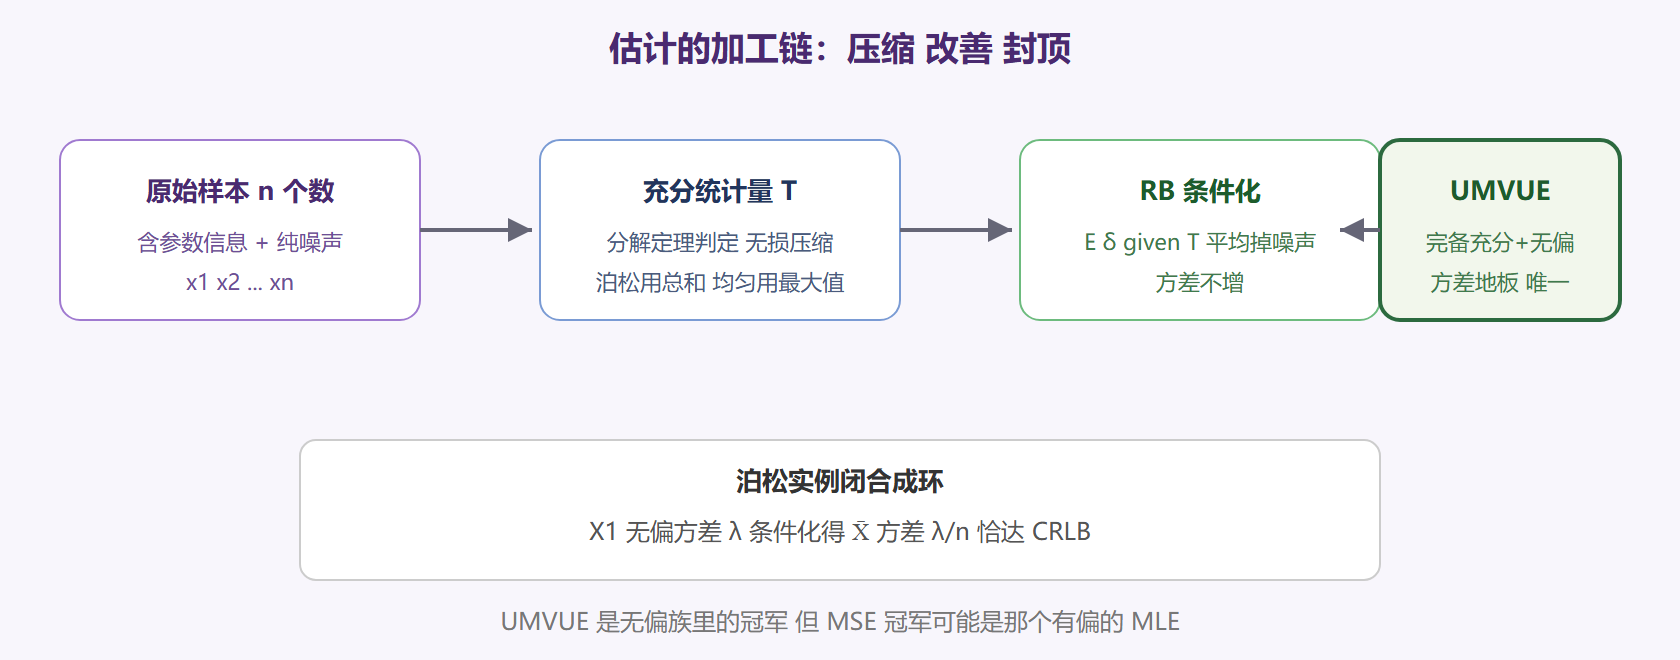
抽 100 个样本估计泊松 λ,原始数据是一百个数,但你只需要一个数:总和 T=ΣXᵢ。扔掉 99 个数不损失任何关于 λ 的信息——这就是充分性的含义。严格定义:给定 T=t 的条件下,样本的条件分布与 θ 无关;换言之,T 之外的数据只剩"随机噪声",对推断毫无增量。数据压缩的极端版本:0/1 伯努利样本压缩成成功次数、正态样本压缩成 (X̄, S²) 二元组、均匀 U(0,θ) 压缩成最大值——6.3 节 MLE 只依赖这些统计量的现象此刻有了理论解释(MLE 总是充分统计量的函数)。
分解定理:判定充分性的一行判据
Neyman-Fisher 分解定理:T 是 θ 的充分统计量,当且仅当似然可分解为
L(θ) = g(T(x), θ) · h(x)
其中 g 只通过 T 与数据挂钩、h 完全不含 θ。手推泊松:L(λ) = Π e^(−λ)λ^{xᵢ}/xᵢ! = e^(−nλ)λ^{Σxᵢ} · (Πxᵢ!)^(−1)。第一项只含 λ 与 T=Σxᵢ,第二项不含 λ——分解成功,**T=总和是充分的**。再推均匀 U(0,θ):L(θ)=θ^(−n)·1{max xᵢ ≤ θ},只通过最大值与 θ 交互——最大值充分,与 MLE 的直觉完全对齐。分解定理的价值是把"条件分布与参数无关"这个难验证的定义,换成"乘积拆分"这个代数动作。
拉奥-布莱克韦尔:条件化改善机器
定理:若 δ 是无偏估计、T 充分,则 δ*(T) = E[δ | T] 仍无偏且方差不增(严格不增,除非 δ 已是 T 的函数)。直觉:对与参数无关的随机性做平均,只会抹掉噪声——给定 T 后样本剩下的扰动是纯噪声,条件期望恰好把它平均掉。配合完备性(T 的函数中只有零函数期望恒为零)得到 Lehmann-Scheffé 定理:无偏 + 只依赖完备充分统计量 = UMVUE(一致最小方差无偏估计),且唯一。
泊松完整走一遍。取朴素无偏估计 δ = X₁(只用第一个观测)。对它做 RB 条件化:
δ*(T) = E[X₁ | ΣXᵢ = T] = T/n = X̄
(对称性:给定总和 T,每个分量条件期望相等,和为 T,故各为 T/n。)于是 X̄ 是 UMVUE,方差 λ/n 精确达到 CRLB(6.3 节模拟已验证过达界)——泊松的例子把整条理论链漂亮闭合。模拟观察 RB 定理的方差改善:
import numpy as np rng = np.random.default_rng(71) lam, n, reps = 3.0, 10, 200_000 xs = rng.poisson(lam, (reps, n)) T = xs.sum(axis=1) delta = xs[:, 0] # 朴素无偏估计 只用第一个观测 delta_star = T / n # RB 条件化后 = 样本均值 print(f"朴素 δ=X1: 均值 {delta.mean():.3f} 方差 {delta.var():.4f} 理论方差 λ={lam}") print(f"RB 后 δ*=X̄: 均值 {delta_star.mean():.3f} 方差 {delta_star.var():.4f} 理论 λ/n={lam/n}")
方差从 λ=3 降到 λ/n=0.3——**十倍改善,且改善完全来自"把纯噪声平均掉"这一个动作**。两个估计都无偏(均值都贴住 3),差别全在效率:这就是 6.2 节"无偏之上再比有效"的定量展示。
再看一个 RB 改善非平凡估计的例子——均匀 U(0,θ):从 δ = 2X₁ 出发(无偏),条件化 E[2X₁ | max=m] 后得到与 m 有关的多段函数;理论终点是 (n+1)/n·max(UMVUE),方差严格小于矩估计 2X̄:
import numpy as np rng = np.random.default_rng(72) theta, n, reps = 5.0, 5, 100_000 xs = rng.uniform(0, theta, (reps, n)) umvue = (n+1)/n * xs.max(axis=1) mom = 2 * xs.mean(axis=1) mle = xs.max(axis=1) for name, e in [("矩估计 2X̄", mom), ("MLE max", mle), ("UMVUE (n+1)/n·max", umvue)]: print(f"{name}: 均值 {e.mean():.3f} 方差 {e.var():.5f} MSE {(e-theta).var()+(e.mean()-theta)**2:.5f}")
UMVUE 无偏且方差最小;MLE 有偏但方差更小、MSE 反而可能占优——无偏金字塔尖端的 UMVUE 不保证 MSE 最优,6.2 节"偏差换方差"的老话题在高级理论里依然成立。工程含义:预测问题看 MSE,无偏性执念更适合科学解释场景。
图 8-1 从原始样本到 UMVUE 的加工链
⚠️ 常见坑:把"充分"误当"样本足够多"。充分统计量说的是信息压缩无损,与样本量大小无关;另一个坑是以为 UMVUE 总比 MLE 好——只在其方差比较里成立,MSE 与预测误差是另一本账。
正态总体的经典答案
把同一套机器套到正态总体 N(μ,σ²),得到教科书的标准结论:二维统计量 (X̄, S²) 是 (μ,σ²) 的充分统计量(分解定理可验证),且完备。于是 μ 的 UMVUE 是 X̄、σ² 的 UMVUE 是 S²(分母 n−1 版本)——第 6 章那个"除以 n−1"的选择,此刻获得最高级理论背书:它不只是无偏,是无偏族里方差最小的那个。小结三总体的答案对照:
| 总体 | 完备充分统计量 | UMVUE |
|---|---|---|
| 泊松 λ | 总和 ΣXᵢ | X̄,方差 λ/n 达 CRLB |
| 正态 μ,σ² | (X̄, S²) | X̄ 与 S² |
| 均匀 U(0,θ) | 最大值 | (n+1)/n · 最大值 |
三个例子覆盖了"达界、精确充分二元组、边界参数特例"三种形态,UMVUE 理论的全貌尽在于此。
本节要点回顾
- 充分统计量 = 无损压缩:给定 T 后样本剩余部分与参数无关
- 分解定理:似然拆成 g(T,θ)·h(x) 即充分——代数动作代替条件分布验证
- MLE 总是充分统计量的函数:解释了 6.3 节"只用到少数汇总量"的现象
- RB 定理是改善机器:条件化平均掉纯噪声,方差不增
- 完备充分 + 无偏 = UMVUE(Lehmann-Scheffé),泊松的 X̄ 精确达 CRLB 闭合全链
- UMVUE 不保证 MSE 最优:均匀例子里有偏 MLE 的 MSE 反而更小