9.1 单因素方差分析
9.1 单因素方差分析
本节摘要:比较 k 组均值,两两 t 检验会 inflate 第一类错误(3 组 3 次比较、6 组 15 次),方差分析(ANOVA)把总变异分解为组间与组内两块,用 F 统计量(组间均方除以组内均方)一次裁决"各组均值是否全等"。本节手算完整方差分解表并用 statsmodels 对照,附前提检查与两两事后比较。
三组以上,两两 t 会怎样
比较 4 条产线的良率,两两 t 检验要 6 次。若真实无差异,6 次独立检验至少一次 p<0.05 的概率 = 1−0.95⁶ ≈ 26.5%——7.2 节多重比较陷阱的成批版本。ANOVA 的方案:把"各组均值是否全等"打包成单一假设 H₀: μ₁=μ₂=…=μₖ,一次检验整体裁决,显著后再做事后两两比较(带校正)。名字里"方差分析"的由来:裁决工具不是比较均值本身,而是**比较方差的两种算法**——组间差异大还是组内噪声大。
方差分解:一笆总账拆两个口袋
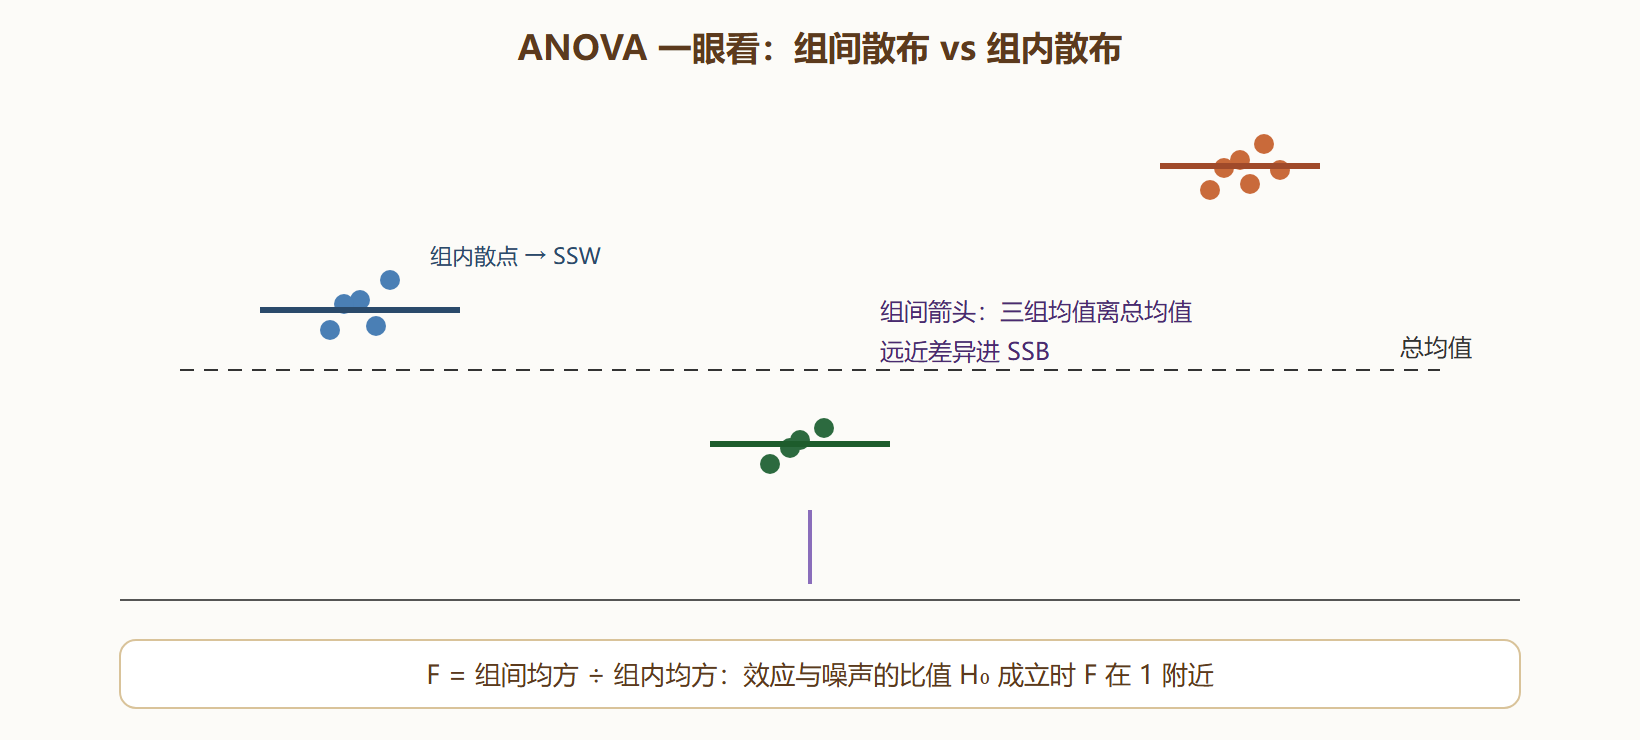
总离差平方和 SST = Σᵢⱼ(yᵢⱼ−ȳ)² 恒等分解为:
SST = SSB(组间,Σnᵢ(ȳᵢ−ȳ)²) + SSW(组内,Σᵢⱼ(yᵢⱼ−ȳᵢ)²)
直觉:每个点离总均值的距离 = 它离自己组均值的距离(噪声)+ 组均值离总均值的距离(效应)。F 统计量 = MSB/MSW = (SSB/(k−1)) / (SSW/(N−k))。H₀ 成立时 F 应在 1 附近晃(两个都是噪声的独立估计);H₀ 不成立时组间口袋被真实差异撑大、F 远大于 1——F 分布正是 6.1 节"两个卡方各除自由度之比",ANOVA 是它的主场。
完整手算案例:三条产线的良率
import numpy as np from scipy import stats A = np.array([92.1, 91.5, 93.0, 92.4, 91.8]) B = np.array([90.2, 89.8, 90.9, 89.5]) C = np.array([94.0, 93.2, 94.8, 93.6, 94.5, 93.9]) groups = [A, B, C] N = sum(map(len, groups)); k = 3 grand = np.concatenate(groups).mean() ssb = sum(len(g)*(g.mean()-grand)**2 for g in groups) ssw = sum(((g-g.mean())**2).sum() for g in groups) sst = ((np.concatenate(groups)-grand)**2).sum() F = (ssb/(k-1)) / (ssw/(N-k)) p = stats.f.sf(F, k-1, N-k) print(f"SST={sst:.3f} = SSB {ssb:.3f} + SSW {ssw:.3f}") print(f"F={F:.3f} df=({k-1},{N-k}) p={p:.2e}")
手工方差分解后,交 statsmodels 的 ANOVA 表对照:
import numpy as np import statsmodels.api as sm from statsmodels.formula.api import ols import pandas as pd df = pd.DataFrame({ "yield": np.concatenate(groups), "line": ["A"]*5 + ["B"]*4 + ["C"]*6}) model = ols("yield ~ C(line)", data=df).fit() anova = sm.stats.anova_lm(model) print(anova.round(4))
手算与软件输出的 SSB、SSW、F、p 逐项一致。p 在 10⁻⁶ 量级——三条产线均值不全相等。ANOVA 显著只说"至少两组不同",不说谁和谁不同;定位差异要做事后比较,且必须用带校正的方法(Tukey HSD),不能事后裸跑 t 检验把 ANOVA 的功劳又吐回去。
前提三件套与模拟验证
ANOVA 的 F 检验依赖三条前提:独立性(最重要也最脆弱,时序数据常违反)、正态性(组内残差近似正态,第 8 章 Shapiro 可查)、方差齐性(各组方差接近,Levene 检验可查)。F 统计量的鲁棒性对轻度违反尚可,但方差不齐 + 样本失衡的组合会重演 7.3 节 pooled t 的假显著事故。模拟看 F 的第一类错误控制:
import numpy as np from scipy import stats rng = np.random.default_rng(303) # H0为真:三组同分布,重复实验数F的假阳性率 reps = 10_000 fp = 0 for _ in range(reps): a, b, c = rng.normal(90, 2, 5), rng.normal(90, 2, 5), rng.normal(90, 2, 5) F, p = stats.f_oneway(a, b, c) fp += (p < 0.05) print(f"H0下假阳性率 {fp/reps:.4f} 名义0.05") # 方差不齐时:重尾组配上大样本会失控 fp2 = 0 for _ in range(reps): a = rng.normal(90, 1.0, 5) b = rng.normal(90, 1.0, 5) c = rng.normal(90, 3.5, 30) # 第三组方差大且样本多 F, p = stats.f_oneway(a, b, c) fp2 += (p < 0.05) print(f"方差不齐失衡下假阳性率 {fp2/reps:.4f} ← 前提被破坏的代价")
第一段模拟假阳性率贴住 0.05;第二段失衡场景涨到 0.10 以上——方差齐性不是教科书装饰,是 F 检验的承重墙。违反时的替代品:Welch ANOVA(statsmodels 的 anova_lm 用 welch=True 或 scipy 手工)。
图 9-1 方差分解:组间口袋与组内口袋
本节要点回顾
- 两两 t 的 α 膨胀:6 次比较假阳性 26.5%——多组比较必须整体裁决
- 方差分解 SST = SSB + SSW:效应与噪声分口袋记账,恒等式不靠假设
- F = MSB/MSW:H₀ 下在 1 附近,两组卡方比的直接应用
- 显著只说"不全等":定位差异用 Tukey HSD 等带校正的事后法
- 前提三件套:独立性最要命、方差齐性是承重墙,违反换 Welch ANOVA
- 手算分解表与 statsmodels 逐项对齐是掌握 ANOVA 的最短路径