9.2 简单线性回归与最小二乘法
9.2 简单线性回归与最小二乘法
本节摘要:线性回归假定 y = β₀ + β₁x + ε、ε 零均值同方差;最小二乘法最小化残差平方和,正规方程给出闭式解。高斯-马尔可夫定理保证 OLS 在线性无偏类中方差最小(BLUE);正态噪声下 OLS 与 MLE 等价,系数的抽样分布是 t,全册理论线在此汇流。本节从正规方程推导到 statsmodels 落地一气呵成。
把第 4 章的最优预测曲线拉直
4.1 节说过条件期望 E(Y|X) 是均方误差意义下的最优预测。回归的全部野心就是估计这条曲线,线性回归把它限定为直线 y = β₀ + β₁x,误差项 ε 吸收"直线之外的一切"。最小二乘法(OLS)选系数使残差平方和最小:
S(β₀,β₁) = Σ(yᵢ−β₀−β₁xᵢ)²
求偏导置零得正规方程,解出闭式:
β̂₁ = Σ(xᵢ−x̄)(yᵢ−ȳ) / Σ(xᵢ−x̄)²,β̂₀ = ȳ − β̂₁x̄
斜率就是"样本协方差除以 x 的样本方差"——第 3 章两个数字特征的一次登场。也可以把 S(β) 写成矩阵形 (y−Xβ)ᵀ(y−Xβ),正规方程 XᵀXβ = Xᵀy,得 β̂ = (XᵀX)⁻¹Xᵀy,矩阵版直接服务多元回归。
import numpy as np rng = np.random.default_rng(15) n = 60 x = rng.uniform(0, 10, n) y = 2.0 + 1.5*x + rng.normal(0, 2.0, n) # 真实 β0=2 β1=1.5 # 手工正规方程 b1 = np.sum((x-x.mean())*(y-y.mean())) / np.sum((x-x.mean())**2) b0 = y.mean() - b1*x.mean() print(f"手算: 截距 {b0:.3f} 斜率 {b1:.3f}") # 矩阵版通用解 X = np.column_stack([np.ones(n), x]) beta = np.linalg.solve(X.T @ X, X.T @ y) print(f"矩阵解: {beta.round(3)}") # statsmodels 完整推断(下一节展开) import statsmodels.api as sm res = sm.OLS(y, X).fit() print(f"OLS: 截距 {res.params[0]:.3f} 斜率 {res.params[1]:.3f} R2 {res.rsquared:.3f}")
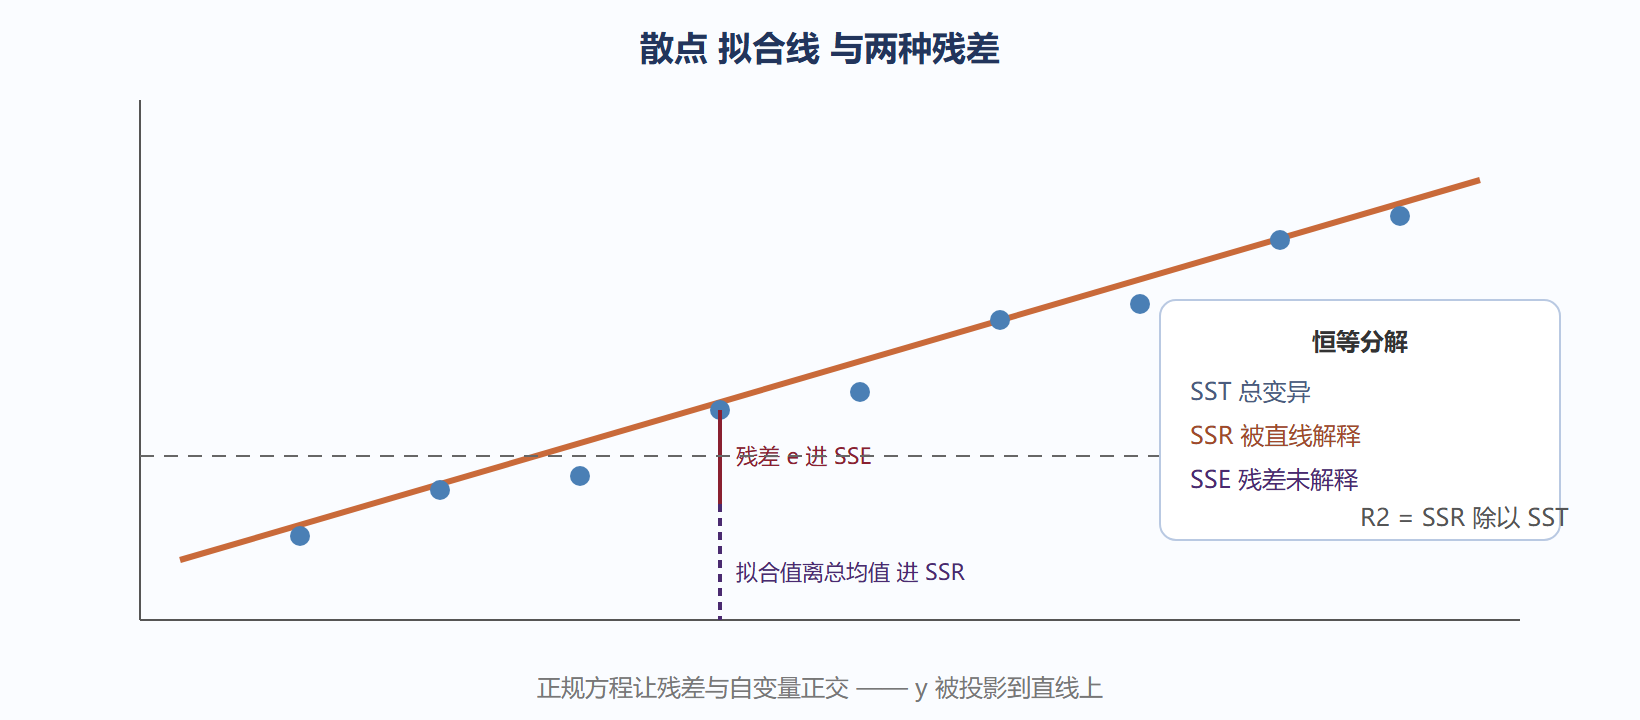
三种算法逐位一致,斜率贴住真实 1.5。残差正交性值得看一眼:正规方程等价于 Xᵀe = 0(拟合值与残差正交),几何上 OLS 是把 y 投影到 X 张成的平面上——"回归"一词的几何本体。
OLS 的统计性质:谁给它撑腰
高斯-马尔可夫定理:误差零均值、同方差、互不相关(不要求正态!)时,OLS 估计量在一切线性无偏估计中方差最小——BLUE。若再加正态误差假设,OLS 与 MLE 等价(对数似然最大化恰为残差平方和最小化),且系数估计量服从正态分布、标准化后服从 t(n−2)。用模拟验证系数的抽样分布与置信区间覆盖率:
import numpy as np rng = np.random.default_rng(105) n, reps = 40, 10_000 b0_true, b1_true, sig = 2.0, 1.5, 2.0 b1s, cover = [], 0 from scipy import stats as st for _ in range(reps): x = rng.uniform(0, 10, n) y = b0_true + b1_true*x + rng.normal(0, sig, n) b1 = np.sum((x-x.mean())*(y-y.mean()))/np.sum((x-x.mean())**2) b1s.append(b1) sxx = np.sum((x-x.mean())**2) s = np.sqrt(np.sum((y - (y.mean()+b1*(x-x.mean())))**2)/(n-2)) se = s/np.sqrt(sxx) tcrit = st.t.ppf(0.975, n-2) if abs(b1 - b1_true) <= tcrit*se: cover += 1 b1s = np.array(b1s) print(f"斜率抽样分布: 均值 {b1s.mean():.3f} 标准差 {b1s.std():.3f}") print(f"95% 区间覆盖率 {cover/reps:.4f}")
斜率估计的抽样分布精确围绕真值、区间覆盖率 95%——OLS 推断机器的每个零件都与理论吻合。斜率的标准误公式 se = S/√Sxx 值得盯三秒:x 的散布越大斜率估得越准,实验设计里"把自变量拉开档位"的统计学理由。
拟合优度与读表
R² = 1 − SSE/SST = SSR/SST,读作"y 的变异中被 x 解释的比例"。它同时等于简单回归里的相关系数平方(4.2 节埋的 ρ² 线收线)。注意 R² 的三个坑:加任何变量都会涨(多元里要看调整 R²)、离群点能虚构高 R²、R² 高不等于因果——时间趋势下的两个无关量也能联袂高 R²。看 statsmodels 摘要的关键行:
import numpy as np import statsmodels.api as sm rng = np.random.default_rng(15) x = rng.uniform(0, 10, 60) y = 2.0 + 1.5*x + rng.normal(0, 2.0, 60) res = sm.OLS(y, sm.add_constant(x)).fit() print(res.summary().tables[1]) # 系数表:估计 标准误 t p 区间 print("R2 =", round(res.rsquared, 3), " 整体F p =", round(res.f_pvalue, 3))
系数表给出每个 β 的估计、标准误、t 值、p 值与置信区间——7 章的检验机器直接挂在回归系数上,全册在此合龙。
图 9-2 回归的几何:投影、残差与分解
本节要点回顾
- OLS 最小化残差平方和,正规方程闭式解,斜率 = 协方差 ÷ x 方差
- 几何本质是投影:残差与拟合值正交(Xᵀe=0)
- 高斯-马尔可夫:BLUE——零均值同方差不相关即可,不要求正态
- 正态误差下 OLS = MLE,系数走 t 分布,检验机器直接挂上
- 斜率标准误 S/√Sxx:自变量拉开档位能提高斜率精度(实验设计依据)
- R² = 相关系数平方,会因加变量而虚涨、被离群点绑架、与因果无关