9.3 回归的统计推断与多元扩展
9.3 回归的统计推断与多元扩展
本节摘要:多元回归 y = Xβ + ε 的 OLS 解仍是 (XᵀX)⁻¹Xᵀy,每个系数检验"控制其他变量后该自变量的净效应";整体 F 检验裁决"模型是否全无解释力";方差膨胀因子 VIF 诊断多重共线,残差四件套检查模型假设。本节完成一个完整的多元回归工作流,并揭示 ANOVA 与回归在矩阵语言下的统一。
多个解释变量:净效应的语言
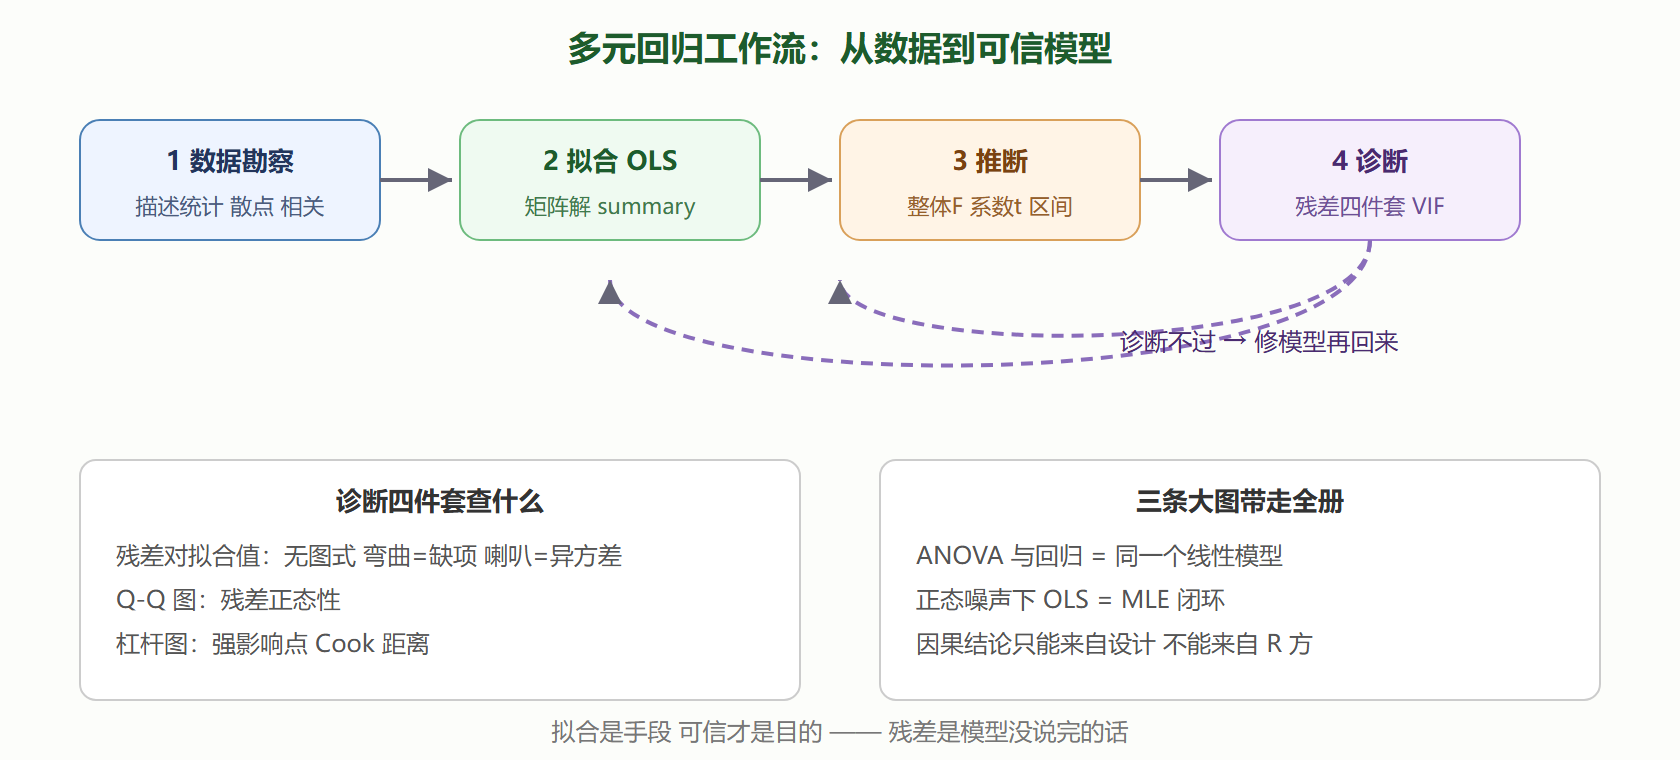
房价对面积、房龄、地铁距离同时回归:y = β₀ + β₁x₁ + β₂x₂ + β₃x₃ + ε。β₁ 的含义精确化为"房龄与地铁距离固定时,面积每增一单位的价格平均变化"——控制变量的语言。OLS 矩阵解与 9.2 节同式,统计推断也同构:每个系数有标准误、t 检验与置信区间;整体 F 检验的 H₀ 是"所有斜率同时为零"(模型毫无解释力),它是 9.1 节 ANOVA 的 F 在回归里的化身——事实上 ANOVA 就是"解释变量只取类别值"的回归,两者在矩阵语言下是同一个线性模型,用哑变量编码即可互换。走一遍完整工作流:
import numpy as np import pandas as pd import statsmodels.api as sm rng = np.random.default_rng(500) n = 200 area = rng.uniform(50, 150, n) age = rng.uniform(1, 30, n) subway = rng.uniform(0.2, 5.0, n) price = 50 + 1.8*area - 0.9*age - 8.0*subway + rng.normal(0, 20, n) df = pd.DataFrame({"price": price, "area": area, "age": age, "subway": subway}) X = sm.add_constant(df[["area", "age", "subway"]]) model = sm.OLS(df["price"], X).fit() print(model.summary().tables[1]) # 系数表: 估计 标准误 t p 区间 print(f"R2 {model.rsquared:.3f} 调整R2 {model.rsquared_adj:.3f}" f" 整体F p {model.f_pvalue:.2e}")
三个系数的符号、量级与 p 值都还原真实生成式(面积正、房龄负、地铁距离负)。读表的纪律:先看整体 F(模型有没有料)、再逐个系数(谁在起作用)、最后看区间宽度(估计有多准)。
多重共线:VIF 诊断与后果
面积与房间数高度相关时,两个系数的估计会剧烈互抢(数据无法区分各自贡献),标准误膨胀、符号翻转。诊断工具方差膨胀因子 VIFⱼ = 1/(1−Rⱼ²),Rⱼ² 是第 j 个自变量对其余自变量回归的 R²。经验线:VIF>10 严重共线。处置:删变量、合并变量或改用岭回归收缩:
import numpy as np import pandas as pd import statsmodels.api as sm from statsmodels.stats.outliers_influence import variance_inflation_factor rng = np.random.default_rng(77) n = 150 x1 = rng.uniform(0, 10, n) x2 = 0.95*x1 + rng.normal(0, 1, n) # 与 x1 高度共线 y = 3*x1 + rng.normal(0, 2, n) # 真实只由 x1 决定 X = sm.add_constant(np.column_stack([x1, x2])) print(sm.OLS(y, X).fit().summary().tables[1]) # 系数互相打架 符号可能翻 vifs = [variance_inflation_factor(X, i) for i in (1, 2)] print("VIF:", np.round(vifs, 1)) # 两者都远超 10
典型输出:两个系数一正一负互相抵消(x2 的 0.95 相关让数据无法分工),VIF 双双破 10——共线不伤预测、专伤解释,要报系数含义的场合必须先处理。
残差诊断四件套
拟合不等于建模完成,残差要过四道检查:残差 vs 拟合值(应无图式,弯曲提示缺高次项、喇叭口提示异方差)、Q-Q 图(残差正态性,8.2 节思想的应用)、Scale-Location(方差齐性)、残差 vs 杠杆(离群与强影响点)。手工跑两道最关键的:
import numpy as np import statsmodels.api as sm from scipy import stats rng = np.random.default_rng(909) x = rng.uniform(0, 10, 120) y = 2 + 1.5*x + 0.12*x**2 + rng.normal(0, 3, 120) # 真实含二次项 res = sm.OLS(y, sm.add_constant(x)).fit() # 检查1:残差对拟合值回归 —— 若仍有系统图式 二次项系数会显著 fitted = res.fittedvalues quad = sm.OLS(res.resid, sm.add_constant(np.column_stack( [fitted, fitted**2]))).fit() print("残差中残留二次结构 p =", round(quad.pvalues[2], 4)) # 检查2:残差正态性 print("残差 Shapiro p =", round(stats.shapiro(res.resid).pvalue, 3)) # 修正:加入二次项重拟合 res2 = sm.OLS(y, sm.add_constant(np.column_stack([x, x**2]))).fit() print("加二次项后 R2: %.3f -> %.3f" % (res.rsquared, res2.rsquared))
漏掉二次项时残差里"残留二次结构"被检出(p 很小);补上后 R² 明显提升——残差是模型没说完的话,诊断环节让第 8 章"对分布形状做检查"的思想落到建模现场。
图 9-3 多元回归工作流全景
预测与外推的边界
回归的预测区间(单点新观测)宽于置信区间(均值线),两者都随 |x−x̄| 增大而展宽——在数据范围之外预测(外推)时区间急剧膨胀甚至荒谬。模型在观测数据的支撑范围内才是有证件的:用 50–150 平米样本训练的房价模型去预测 500 平米,输出的区间宽到失去决策价值,而多数翻车案例在跑模型前就该被这条常识拦住。
本节要点回顾
- 系数含义是控制其他变量后的净效应——读多元回归先重读这句话
- 整体 F 与系数 t 分层裁决:先"模型有没有料"再"谁在起作用"
- ANOVA 与回归是同一个线性模型:类别变量哑变量编码即互换
- VIF>10 重共线:伤解释不伤预测,报系数前必须处理
- 残差四件套是模型的可信度检查:弯曲缺项、喇叭异方差、Q-Q 查正态、杠杆查影响点
- 外推无证件:预测区间随离样本中心距离急剧展宽