2.1 LU 与 Cholesky 分解
2.1 LU 与 Cholesky 分解
本节摘要:高斯消元的数值稳定版本是带部分主元的 LU 分解,成本约 2n³/3 次浮点运算;对称正定矩阵可用 Cholesky 分解减半成本且不需要主元。本节实现并实测两种分解,解释主元选取的稳定机理与"永远不要显式求逆"的工程铁律。
案发现场:一次手工消元的意外
先看一个教科书级事故。对下面这个矩阵做消元时,第一个主元是 1e-20:
import numpy as np A = np.array([[1e-20, 1.0], [1.0, 1.0]]) b = np.array([1.0, 2.0]) # 不选主元,按公式手算:第二行减去 1e20 倍的第一行 factor = 1.0 / 1e-20 row2 = A[1] - factor * A[0] b2 = b[1] - factor * b[0] x2 = b2 / row2[1] x1 = (b[0] - A[0,1] * x2) / A[0,0] print(x1, x2) # x1 含 1e20 量级的灾难性误差
乘数 1e20 把第一行的微小舍入误差放大了二十个数量级。病灶:消元的本质是用主元当除数去除同一列,主元越小,乘数越大,误差放大越猛。药方:部分主元法——每列消元前,把该列绝对值最大的行换到主元位置,使乘数永远不超过 1。
二、LU 分解:把消元装订成册
高斯消元的过程可以记录成一个下三角矩阵 L(乘数)和一个上三角矩阵 U(消元结果),使得 A 等于 P、L、U 的乘积(P 是行置换)。此后换同一个 A、不同的 b 反复求解时,只需做两次 O(n²) 的三角回代,消元的 O(n³) 成本只付一次。
import numpy as np from scipy.linalg import lu_factor, lu_solve rng = np.random.default_rng(7) n = 500 A = rng.standard_normal((n, n)) b = rng.standard_normal(n) lu, piv = lu_factor(A) # 一次性分解,内部带部分主元 x1 = lu_solve((lu, piv), b) b2 = rng.standard_normal(n) x2 = lu_solve((lu, piv), b2) # 新右端只付回代成本 print(np.linalg.norm(A @ x1 - b) / np.linalg.norm(b)) # 残差 ~1e-14,健康
部分主元的稳定机理值得展开一句:选列内最大元做主元后,L 的所有元素绝对值不超过 1,消元过程中的增长因子被压制,除非矩阵本身病态(2.2 节的主题),计算通常是向后稳定的——即算出的解恰好等于"某个被 eps 量级扰动过的 A"的精确解。这句话就是"后退误差"的雏形,下一节正式开庭。
三、Cholesky:对称正定的专属快速通道
当 A 对称正定时(最小二乘正规方程、协方差矩阵、有限元刚度矩阵的常态),可以做 Cholesky 分解:A 等于 R 转置乘 R,R 是上三角。成本降到约 n³/3,内存减半,而且不需要主元——正定性数学上保证了主元恒正且消元不放大。
import numpy as np rng = np.random.default_rng(3) n = 800 M = rng.standard_normal((n, n)) A = M @ M.T + n * np.eye(n) # 对称正定 import time t0 = time.perf_counter() L = np.linalg.cholesky(A) t_chol = time.perf_counter() - t0 t0 = time.perf_counter() x_lu = np.linalg.solve(A, np.ones(n)) # 通用路线(内部 LU + 主元搜索) t_lu = time.perf_counter() - t0 print(f"Cholesky: {t_chol:.3f}s 通用LU: {t_lu:.3f}s") print(np.allclose(L @ L.T, A))
典型结果 Cholesky 快接近一倍——省掉的主元搜索和对另一半矩阵的更新都是白捡的。代价是必须先确认正定:对不定矩阵强行 Cholesky 会在开负数平方根处报错,这个报错其实是免费的对称性/正定性体检。
💡 关键直觉:求解 Ax 等于 b 时,
np.linalg.solve的成本约是inv(A) @ b的一半,且精度更高。显式求逆不仅要付双倍计算,还要把逆矩阵本身的误差再乘进 b。逆矩阵只有在"确实需要矩阵元素本身"(如协方差解释)时才值得算。
四、规模现实与选型决策
图 2.1-1 线性求解器选型决策树
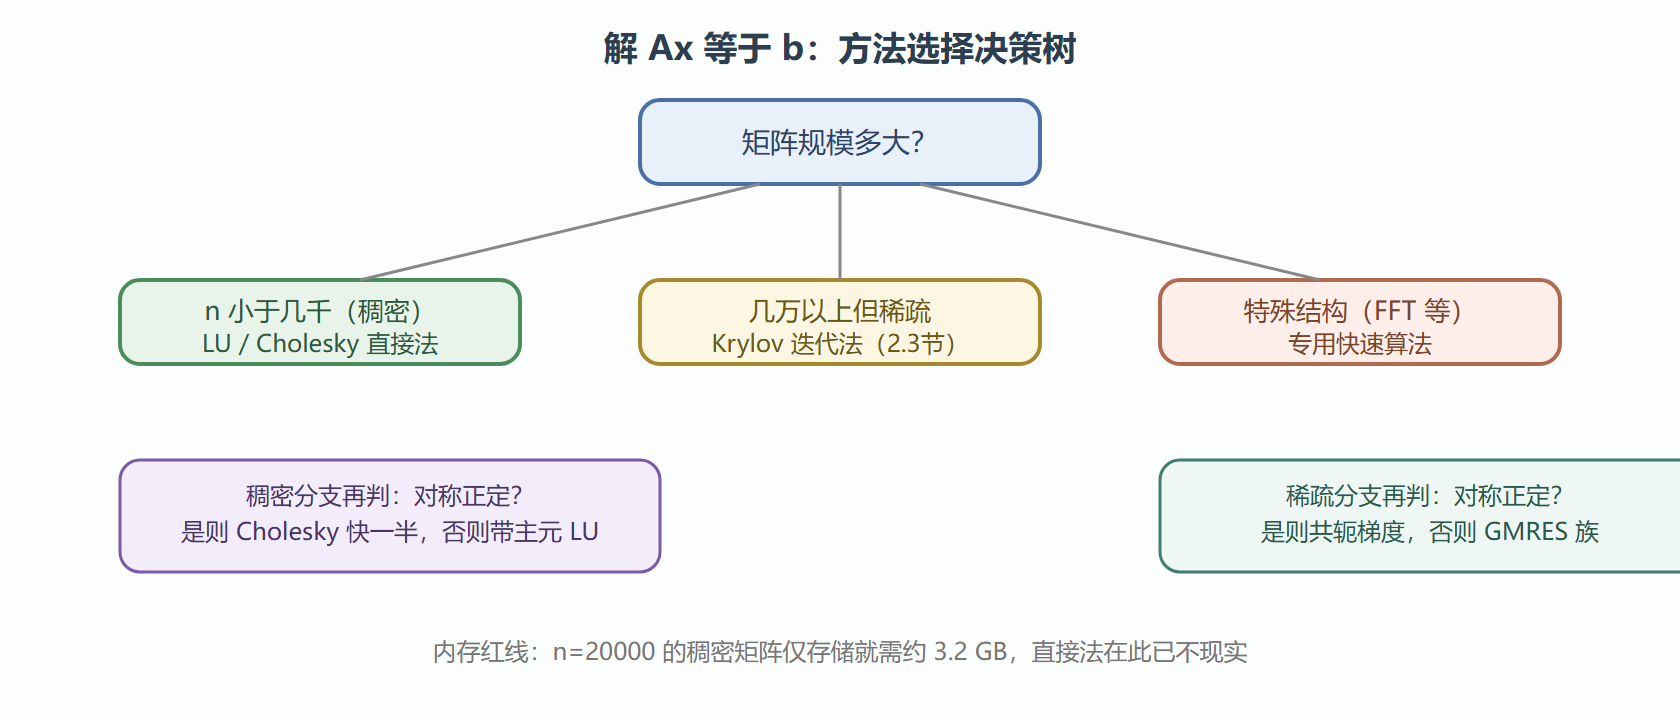
稠密直接法的存储按 n² 增长、计算按 n³ 增长。n 翻倍,内存翻四倍、时间翻八倍——这是选型时的第一道算术题。三维物理仿真离散出百万自由度时矩阵稀疏度极高,直接法分解还会引入大量非零填充,此时必须转向迭代法,这是 2.3 节的舞台。
⚠️ 常见坑:最小二乘问题求解时先算正规方程 A 转置 A 再 Cholesky,会把条件数平方。标准姿势是 QR 分解或 SVD 路线,这一点在第六章排错手册还会作为高频案件重现。
补充一个容易被忽略的细节:库函数返回的分解因子里藏着诊断信息。LU 分解后的 U 矩阵对角线元素若出现接近零的值,说明矩阵接近奇异,此时继续回代得到的结果大概率不可信——比求解后看残差更早一步报警。Cholesky 分解中途报错(负平方根)同样是免费的结构诊断。把"检查分解因子对角线"列入求解流程,成本几乎为零,收益是提前拦下一类最隐蔽的案子。
一个数量级速算也值得带上:n=1000 的稠密 LU 约需 6.7 亿次浮点运算,现代单核不到一秒;n=10000 则要一千倍,秒级变小时级。做规模规划时先拿 2n³/3 这把尺子量一下,能避免很多不现实的方案设计。
结案小结
- 主元即保险:部分主元让消元乘数不超过 1,是 LU 稳定性的核心机制;对称正定则由数学性质免费提供同等级保护
- 分解一次,回代多次:多右端项问题先
lu_factor再lu_solve - Cholesky 是正定问题的专属优惠:省一半成本,且报错本身就是正定性体检
- 显式求逆是反模式:求解永远用 solve 类接口
下一节让条件数出庭,回答"残差这么小,凭什么解还不准"这个高频冤案。