2.2 范数、条件数与残差的证词
2.2 范数、条件数与残差的证词
本节摘要:向量范数给出"多大"的度量,矩阵条件数给出"误差放大倍数"的判决:解的相对误差上限约为条件数乘以输入相对扰动。残差小不等于解准,两者之间隔着条件数这堵墙。本节用希尔伯特矩阵完成一次完整的法庭取证,并演示迭代改进技术。
学习目标
阅读完本节,你应当能够:
- 说出常用三种向量范数各自"偏爱"什么类型的误差
- 用条件数估计解的精度上限,并解释为什么这是"上限"而非"预言"
- 复现"小残差 + 大误差"的希尔伯特矩阵实验
- 实现一步迭代改进并说明其适用条件
一、先有尺子:范数
度量误差前先定义长度。三种常用范数对同一向量的"体重"判读不同:
import numpy as np v = np.array([3.0, -4.0, 0.1]) print(np.linalg.norm(v, 1)) # 7.1,绝对值之和:对离群分量敏感 print(np.linalg.norm(v, 2)) # 5.006,欧氏长度:均匀看待各分量 print(np.linalg.norm(v, np.inf)) # 4.0,最大分量:只看最坏的那个
选范数就是选价值观:电力系统潮流分析关心最坏节点(无穷范数),信号处理习惯能量(二范数),稀疏重建偏爱一范数。矩阵范数中最常用的是由二范数诱导的谱范数(最大奇异值),它让条件数有了干净的几何解释——把单位球拉成椭球的最长轴与最短轴之比。
二、条件数出庭:误差放大的法定上限
核心结论一行:若数据有相对扰动,解的相对误差不超过条件数乘以它:
\kappa(A) 定义为矩阵范数乘以逆矩阵范数,等于最大奇异值除以最小奇异值。它把第一章"病态问题"的定性讨论变成定量判决。实测一个温和案例与一个恶性案例:
import numpy as np from scipy.linalg import hilbert # 案件一:随机良态矩阵 rng = np.random.default_rng(0) A1 = rng.standard_normal((10, 10)) print(np.linalg.cond(A1)) # 典型 1e2 量级:误差放大约百倍,可控 # 案件二:10 阶希尔伯特矩阵,对称正定、看似无害 A2 = hilbert(10) print(np.linalg.cond(A2)) # 约 1.6e13:eps 误差可放大到 10 量级!
希尔伯特矩阵的元素是单位分数,entries 全部介于 0 和 1 之间、对称、正定——所有表面指标完美,条件数却随阶数指数增长(10 阶已 1e13,12 阶破 1e16,达到双精度可解性的天花板)。这就是"条件数是体质而非手术水平"的最佳例证:对它无论用 LU、Cholesky 还是任何未来发明的算法,双精度下都别想得到超过两三位有效数字。
三、冤案剖析:小残差不等于小误差
残差 r = b - A\hat{x} 是求解器唯一能直接观测的量,但它与真误差之间隔着一堵墙。完整实验:
import numpy as np from scipy.linalg import hilbert n = 12 A = hilbert(n) x_true = np.ones(n) b = A @ x_true x_num = np.linalg.solve(A, b) # 带主元 LU,向后稳定的高质量算法 r = np.linalg.norm(b - A @ x_num) / np.linalg.norm(b) e = np.linalg.norm(x_num - x_true) / np.linalg.norm(x_true) print(f"相对残差: {r:.2e}") # 约 1e-16 量级 —— 求解器自认为完美 print(f"相对误差: {e:.2e}") # 约 1e-4 或更差 —— 真解误差大四个数量级以上
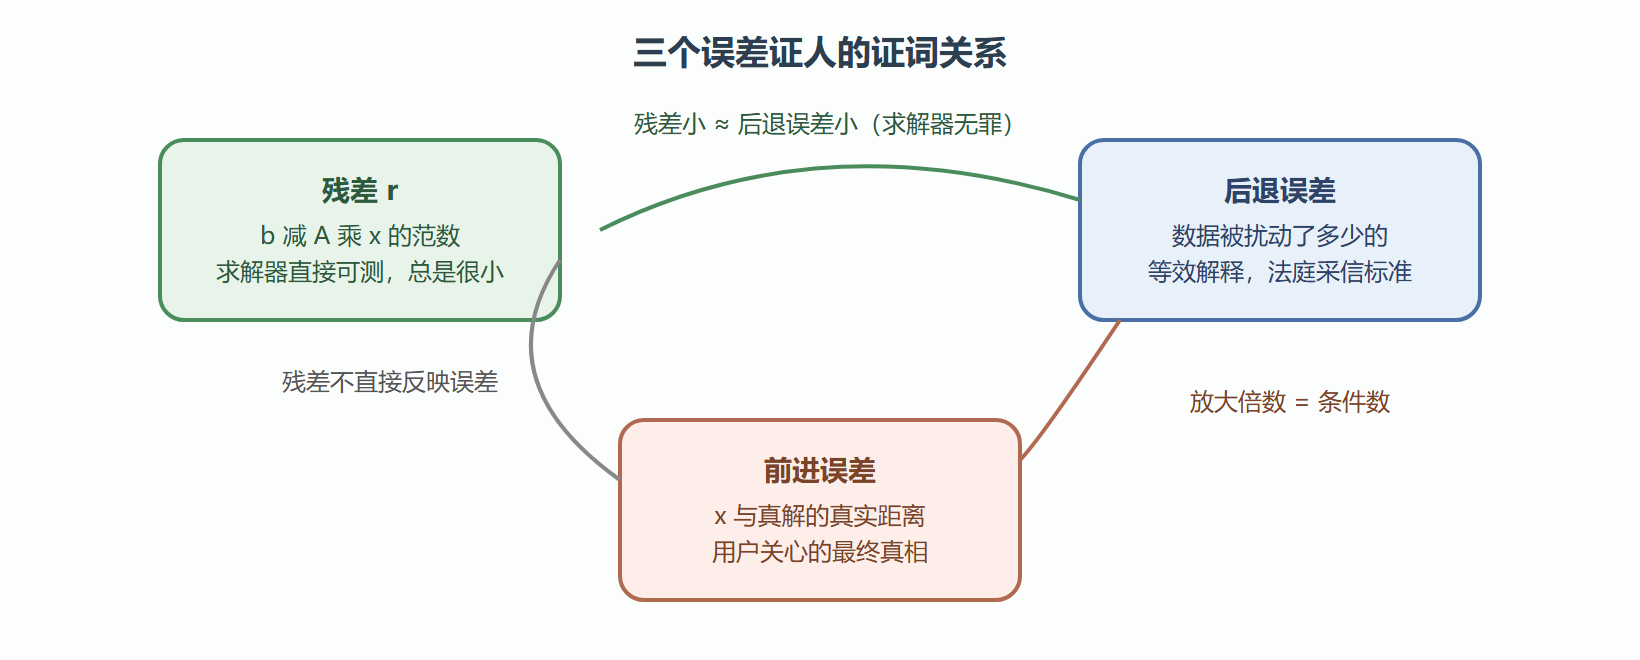
取证结论:求解器没有说谎——残差 1e-16 说明算出的 \hat{x} 是某个"被 eps 量级扰动的 b"的精确解(后退误差极小)。但条件数 1e16 把这份微小扰动放大成解上百分之几十的偏差(前进误差)。残差是被告的"局部口供",误差是"全案真相",条件数是两者之间的换算汇率。
推论(也是工程上最实用的一条):残差上限给出的有效数字约为 16 减去 log10 条件数。条件数 1e8 的系统,解能信 8 位左右;条件数 1e16,一位都别信。
四、救命稻草:迭代改进
即便条件数大,若残差小,还有一个便宜的补救:用更高精度算残差,再解一次修正方程。原理演示:
import numpy as np from scipy.linalg import hilbert n = 10 A = hilbert(n) x_true = np.ones(n) b = A @ x_true x = np.linalg.solve(A, b) for _ in range(3): # 关键:残差必须用比求解更高的精度计算(这里用 float128 模拟) r = (np.float128(b) - np.float128(A) @ np.float128(x)).astype(float) dx = np.linalg.solve(A, r) x = x + dx print(np.linalg.norm(x - x_true) / np.linalg.norm(x_true)) # 误差逐轮显著下降,直到逼近条件数允许的极限
解读:迭代改进的本质是"残差还是能算准的,那就把误差当新的右端项再破一次案"。它在有限元等高精度需求场景是标配技术。适用条件很明确:残差可计算到更高精度、且矩阵未病态到完全没救(条件数超过 1e17 时连残差都算不准了)。
⚠️ 常见坑:看到求解器报告"收敛,残差 1e-14"就直接交付结果。标准动作是同时报告
cond(A),把"有效数字估计 = 16 - log10 条件数"写进结果说明。第六章的验证清单会把它列为必填项。
图 2.2-1 残差、后退误差、前进误差三角关系
本节要点回顾
- 范数即价值观:一范/二范/无穷范各有所长,报告误差时必须注明用了哪种
- 条件数是换算汇率:解的相对误差上限 = 条件数 × 数据相对扰动;有效数字 ≈ 16 减 log10 条件数
- 小残差冤案:向后稳定的求解器给出小残差是本分,不是准确性的证明
- 希尔伯特矩阵:表面完美的病态标本,条件数随阶数指数爆炸,适合做任何求解器的压力测试
- 迭代改进:高精度算残差 + 重复求解修正,是病态但未绝望问题的低成本补救
下一节把战场扩展到百万阶稀疏矩阵,看共轭梯度法如何绕开分解、用矩阵向量乘积破案。