3.1 牛顿法与不动点迭代
3.1 牛顿法与不动点迭代
本节摘要:牛顿法用切线近似逐步逼近根,在根附近具有二次收敛——误差每步平方。不动点迭代理论给出收敛的局部条件:迭代函数导数绝对值小于 1。本节实现并实测这两种方法,量化"收敛阶"的概念,并介绍省去导数的割线法与多维推广。
案件引入:牛顿的原始例题
1669 年前后牛顿手算 x^3 - 2x - 5 = 0,从 x = 2 出发几步锁定真根 2.0945514815。我们完整重演这个案件并保留完整的误差档案:
import numpy as np def newton(f, df, x0, tol=1e-14, maxiter=50): x = x0 for k in range(maxiter): fx = f(x) err = abs(fx) print(f"step {k}: x = {x:.15f}, |f(x)| = {err:.2e}") if err < tol: break x = x - fx / df(x) return x f = lambda x: x**3 - 2*x - 5 df = lambda x: 3*x**2 - 2 root = newton(f, df, 2.0)
典型输出(误差列):1e0 → 3e-1 → 1.6e-2 → 1.5e-4 → 1.3e-8 → 1e-16。看清这个节奏:误差每步自身平方——1e-4 一步变 1e-8,再一步直接触底 1e-16。这就是二次收敛:有效数字每步翻倍。6 步拿到 16 位精度,线性收敛的方法(比如下面不动点迭代的某些格式)要走几十步。
二、取证:二次收敛从哪来
机理一行推导就能看清。在根 r 附近做泰勒展开,牛顿步 x_{k+1} = x_k - f(x_k)/f'(x_k) 满足
误差的递推是平方而非倍乘——前提有两个:f'(r) \neq 0(根是单根)、初值落在收敛球内。这张"二次收敛支票"的兑付条件很苛刻,3.2 节专讲支票跳票的N种方式。
工程上的直接推论:牛顿法最后几步几乎白送精度,前几步步步惊心。所以成熟实现都把牛顿当"末端加速器",而不是全程司机。
三、不动点迭代:换个眼镜看收敛
把方程改写成 x = g(x) 的形式,从 x0 开始反复代入 x_{k+1} = g(x_k)。同一道牛顿例题可以有多种改写,命运截然不同:
import numpy as np def fixed_point(g, x0, maxiter=30): x = x0 for k in range(maxiter): x_new = g(x) if abs(x_new - x) < 1e-13: return k, x_new x = x_new return maxiter, x r = 2.0945514815423265 g1 = lambda x: (2*x + 5)**(1/3) # 改写一 g2 = lambda x: (x**3 - 5) / 2 # 改写二:发散格式 k1, x1 = fixed_point(g1, 2.0) print(f"g1: {k1} 步收敛到 {x1:.12f}") k2, x2 = fixed_point(g2, 2.0) print(f"g2: {k2} 步后 x = {x2:.3e}") # 冲向无穷,发散
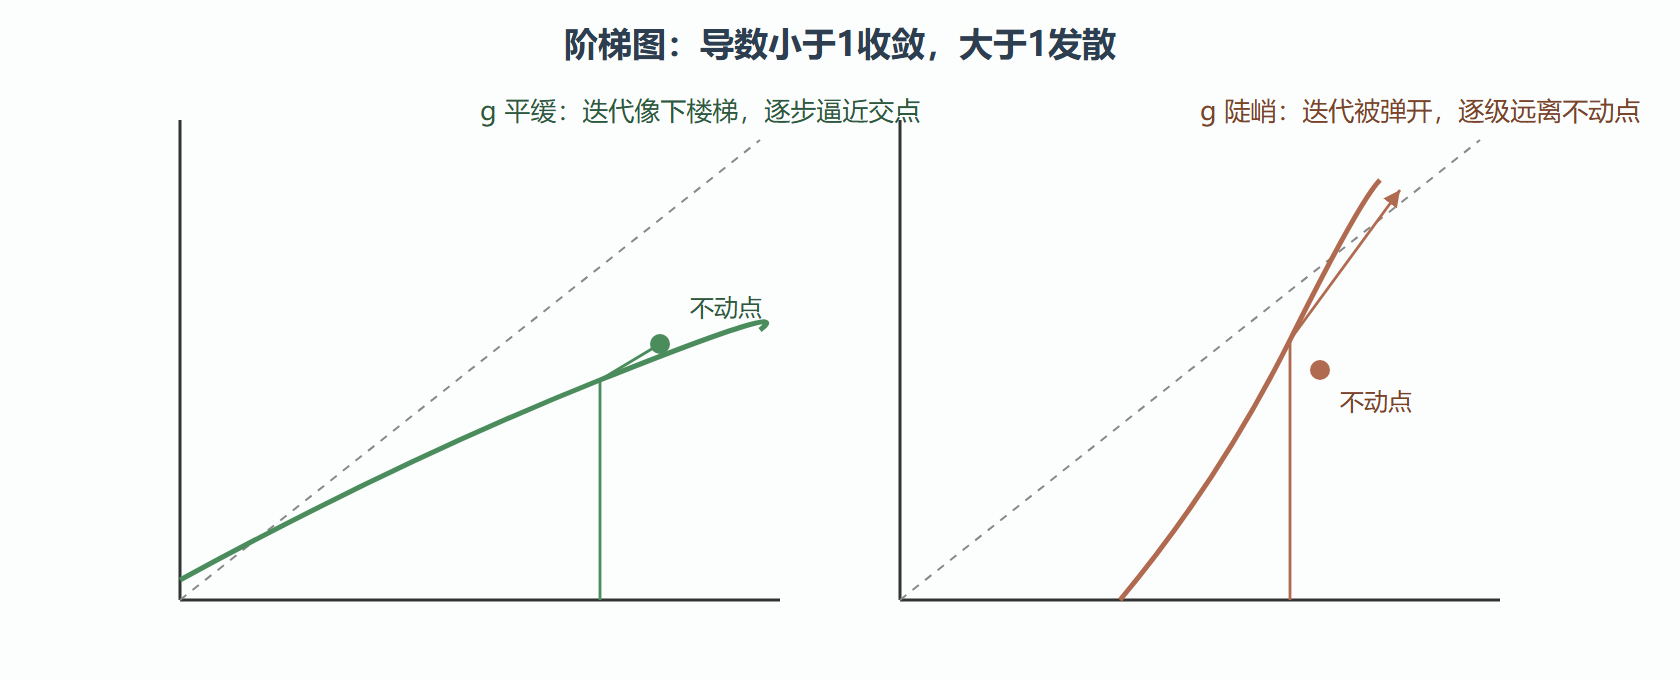
判决依据(收敛的局部定理):若 |g'(r)| < 1,迭代收敛且为线性(速度约 |g'(r)| 倍每步);若 |g'(r)| > 1,不动点排斥迭代序列,必散。验证:
dg1 = lambda x: 2 / (3 * (2*x + 5)**(2/3)) # 在 r 处约 0.15,收敛 dg2 = lambda x: 3 * x**2 / 2 # 在 r 处约 6.6,发散
破案启示:数学上等价的改写式,数值上可以是收敛与发散的天壤之别——这与 1.2 节"代数等价不等于数值等价"一脉相承。设计迭代格式时先把 g' 在疑似根处的值算出来看一眼,是最便宜的事前体检。
图 3.1-1 不动点迭代的收敛与发散几何(示意)
四、省掉导数:割线法与多维推广
牛顿法要算导数,有些场景导数昂贵或不可得。割线法用上两步的差商代替导数,收敛阶降到黄金比例 1.618——仍然是"超线性",且每步成本低:
import numpy as np def secant(f, x0, x1, tol=1e-14, maxiter=50): f0, f1 = f(x0), f(x1) for k in range(maxiter): if abs(f1) < tol: return k, x1 x2 = x1 - f1 * (x1 - x0) / (f1 - f0) x0, f0, x1, f1 = x1, f1, x2, f(x2) return maxiter, x1 f = lambda x: x**3 - 2*x - 5 k, r = secant(f, 2.0, 2.1) print(f"割线法 {k} 步, 根 = {r:.14f}")
多维情形 F(x) = 0 中导数升级为雅可比矩阵,每步解一个线性系统(第二章的工具在这里上场);Broyden 拟牛顿法则用秩一更新维护雅可比的近似,避免每步重算——思想与 3.3 节的 BFGS 同源。数值微分求雅可比时要注意 1.1 节的教训:步长太大截断误差重、太小抵消误差重,最优步长是两者的平衡点,约为 eps 的立方根量级。
💡 关键直觉:收敛阶可以理解为"每步翻几倍有效数字"——线性 1 倍多一点、1.618 阶翻 0.7 倍、二次直接翻倍。但每步成本也在涨(牛顿要导数、多维要解方程),每单位成本的精度才是真正的比较基准。
本节要点回顾
- 二次收敛:牛顿法误差每步平方,最后两步几乎白送全精度;兑付条件是单根 + 初值在收敛球内
- 等价格式不平等:不动点迭代的收敛完全取决于 g 的导数在根处是否小于 1,改写方式决定生死
- 收敛阶谱系:线性 < 割线 1.618 < 牛顿 2,按"每单位成本的有效数字"做工程选择
- 多维衔接:雅可比 + 线性求解器 = 多维牛顿;Broyden 用更新近似雅可比省成本
- 事前体检:算一下导数或斜率的量级再选初值,是最便宜的避坑动作
下一节专门复盘事故现场:同样的牛顿法,在什么条件下跳票、现代求解器装了哪些保险丝。