4.1 数值积分:从梯形到高斯
4.1 数值积分:从梯形到高斯
本节摘要:数值求积用函数采样的加权和逼近定积分:梯形法则二阶精度、辛普森四阶、高斯-勒让德用 n 个节点达到 2n-1 阶。收敛阶可以实验测定,节点位置与权重的选择是精度与代价的交易。本节实现三种求积并实测收敛阶,末尾讨论振荡函数等高阶失效场景。
案件引入:一道没有初等原函数的积分
概率论和统计里到处是这类积分(这个正是正态分布的近亲)。解析法到此为止,数值法三行出场:
import numpy as np f = lambda x: np.exp(-x**2) ref = 0.7468241328124271 def trapezoid(f, a, b, n): x = np.linspace(a, b, n + 1) y = f(x) h = (b - a) / n return h * (y[0]/2 + y[1:-1].sum() + y[-1]/2) def simpson(f, a, b, n): # n 为偶数 x = np.linspace(a, b, n + 1) y = f(x) h = (b - a) / n return h/3 * (y[0] + y[-1] + 4*y[1:-1:2].sum() + 2*y[2:-1:2].sum()) for n in [8, 16, 32, 64]: et = abs(trapezoid(f, 0, 1, n) - ref) es = abs(simpson(f, 0, 1, n) - ref) print(f"n={n:3d} 梯形误差 {et:.2e} 辛普森误差 {es:.2e}")
看输出规律:n 加倍(步长减半)时,梯形误差缩到约 1/4(二阶收敛),辛普森误差缩到约 1/16(四阶收敛)。收敛阶不是宣传语,是可实测的斜率——对数坐标下画误差对步长的曲线,斜率就是阶数。
二、取证:误差从泰勒展开里读出来
梯形法则把每个小区间上的曲线换成直线,误差来自二阶导数项,累积后为 O(h^2);辛普森用抛物线拟合、三点加权(1、4、1)/3,三阶导数项神奇抵消,误差 O(h^4)。这是一个免费教训的样本:巧妙安排权重,能让某阶误差自动消失——高斯把这个思想推到极致。
三、高斯求积:连节点位置也参与设计
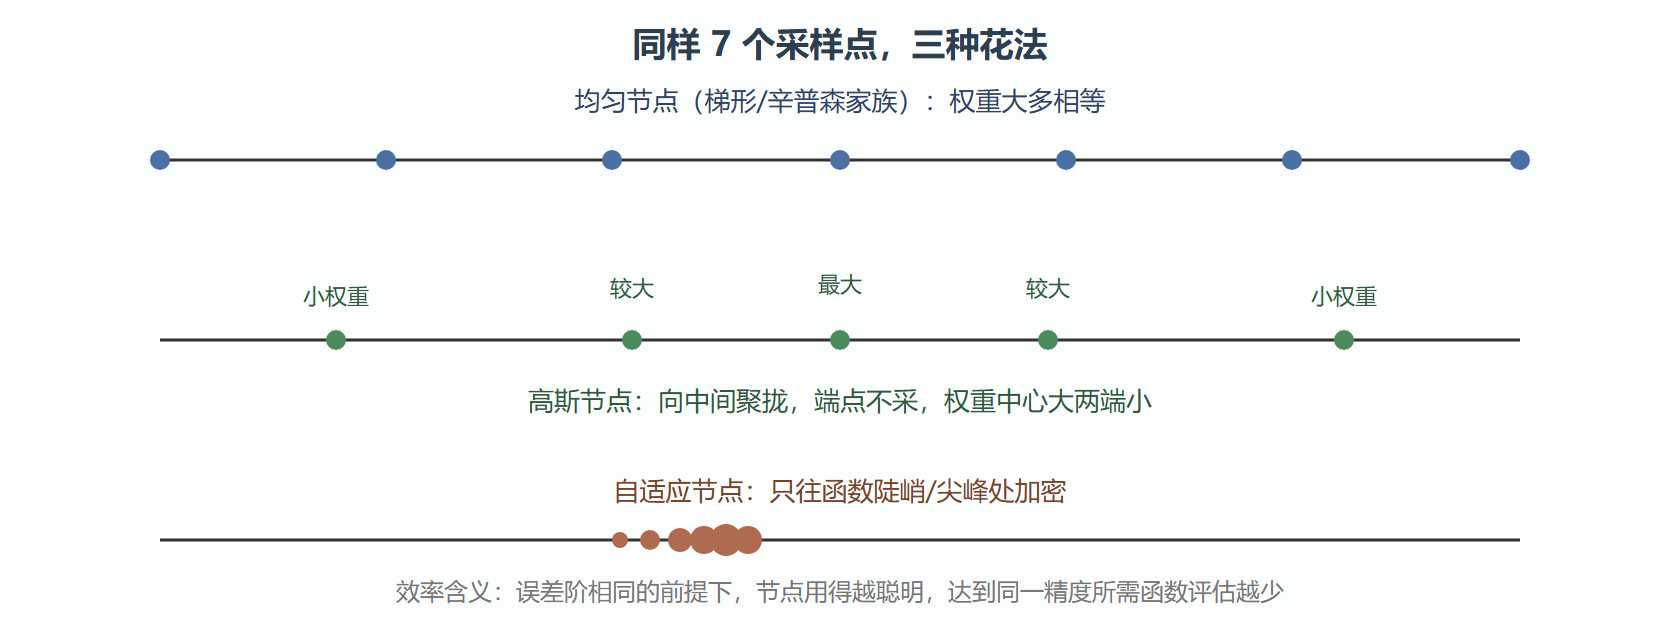
牛顿-柯特斯家族(梯形、辛普森)把节点均匀摆放,只优化权重。高斯-勒让德连节点位置一起优化:n 个节点、2n 个自由度(n 个位置 + n 个权重),可以精确积分 2n-1 次多项式。节点是勒让德多项式的根:
import numpy as np def gauss_legendre(f, a, b, n): x, w = np.polynomial.legendre.leggauss(n) # 标准区间 [-1,1] x_mapped = (b - a)/2 * x + (a + b)/2 # 仿射映射到 [a,b] return (b - a)/2 * np.dot(w, f(x_mapped)) f = lambda x: np.exp(-x**2) ref = 0.7468241328124271 for n in [2, 3, 4, 5]: print(f"n={n}: 误差 {abs(gauss_legendre(f, 0, 1, n) - ref):.2e}") # n=3 时误差已到 1e-7 量级,n=5 直接贴到机器精度附近
性价比对比:梯形法则要几千个函数值达到的精度,高斯 5 个点就够——对每个函数值昂贵的场景(如一次评估要跑完整仿真)是数量级的节省。代价有两条:节点和权重是非均匀的超越数(历史上手算昂贵,如今查表);区间端点不被采样,积分限上的奇点或端点数据无法直接利用。
四、自适应积分:把预算花在刀刃上
被积函数一半平缓一半陡峭时,均匀撒点是浪费。自适应策略递归二分:整段算一次、左右半段各算一次,若两值吻合则接受,否则对差得多的半段继续二分。SciPy 的 quad 即此思想的工程化(QUADPACK):
from scipy.integrate import quad import numpy as np # 尖峰函数:质量集中在极窄区间 g = lambda x: 1 / (1 + 1e4 * (x - 0.4)**2) val, err_est = quad(g, 0, 1, limit=200) print(f"quad 结果 {val:.12f}, 自报误差 {err_est:.2e}") # 对比均匀梯形: n = 1000 x = np.linspace(0, 1, n+1) val_t = np.trapz(g(x), x) print(f"1000 点均匀梯形误差: {abs(val_t - val):.2e}")
quad 还返回自报误差估计——这是它最被低估的证词:数值结果不附带误差估计,按第五章与第六章的标准都算不合格交付。
图 4.1-1 三种求积的节点分布与效率对比(示意)
五、高阶的失效现场
振荡函数是高阶方法的滑铁卢。被积函数在区间内有几十个振荡周期时,任何基于多项式拟合的方法都在做"用低次曲线拟合正弦波"的徒劳之事,收敛阶实测值远低于理论值。对策不是加节点而是换思路:振荡积分的专门算法(Filon、Levin 类)按振荡频率解析处理,或者用自适应把节点对齐振荡周期。类似地,区间内含奇点(如 x 的负零点五次幂)时多项式假设整体崩塌,正确做法是变量替换消奇点或分段切出奇点解析处理。
⚠️ 常见坑:
quad报了收敛警告却直接采用返回值。警告意味着误差估计不可信,至少应换参数重试或分段积分,并报告两条路径的差异。
本节要点回顾
- 收敛阶可实测:步长减半看误差缩到 1/4 还是 1/16,比背公式更能确认方法实现正确
- 高斯求积:n 节点 2n-1 阶精度,节点是勒让德多项式的根;函数评估昂贵时的首选
- 自适应:预算向陡峭区域倾斜,
quad的误差自报是交付的一部分 - 高阶非万能:振荡与奇点让多项式假设失效,先诊断函数形态再选求积
- 与 ODE 的血缘:定积分是"不演化"的微分方程,下一节的步进方法都建立在本节的误差框架上
下一节让函数动起来:Runge-Kutta 家族如何把"每步局部精度"做成体系,又如何在十万步的长跑中暴露慢性病。