5.1 蒙特卡罗积分与方差缩减
5.1 蒙特卡罗积分与方差缩减
本节摘要:蒙特卡罗估计量的误差按样本数平方根分之一衰减、与维度无关,代价是收敛速度天生缓慢。重要性采样、对偶变量、分层抽样三件套能在不增加样本的前提下压缩方差一到几个数量级。本节实现标准估计量与三种缩减技术,并给出正确的报告格式。
一、现场直击:与维度无关的收敛
估计 \pi 的经典实验(单位圆占正方形面积比例)升级为高维版本——估计 10 维单位球体积占比:
import numpy as np rng = np.random.default_rng(42) d = 10 for N in [10_000, 100_000, 1_000_000]: X = rng.uniform(-1, 1, size=(N, d)) inside = (X**2).sum(axis=1) <= 1.0 est = inside.mean() se = inside.std() / np.sqrt(N) # 标准误差 print(f"N={N:9d}: 估计 {est:.5f} ± {se:.5f}") # 估计值稳定在 0.00249 附近,N 扩大 100 倍,误差只缩 10 倍
两个关键观察。维度无关性:把 d 从 10 改成 100,达到同样相对精度需要的样本数不变(被积函数方差不变的前提下)。慢收敛:N 乘 100,精度只多一位有效数字——这就是 1/√N 的含义,也是蒙特卡罗一切加速技术的出发点:与其加样本,不如降方差。
标准误差的来源要交代清楚:样本标准差除以根号 N,是估计量自身的随机波动,不是与真值的偏差。真值偏差还叠加了伪随机数的质量问题与被积函数的可积性,报告时把"± se"理解成"换一批随机数,估计值大概在这个范围内波动"。
二、重要性采样:把样本撒到刀刃上
估计罕见事件概率时标准蒙特卡罗尤其浪费——百万样本里可能只有几十个落在关键区域。重要性采样引入提议分布 q,把"均匀撒点"改成"按 q 撒点再除权重":
实测一个尾部概率估计:
import numpy as np from scipy import stats rng = np.random.default_rng(0) mu, sigma = 2.0, 1.0 target = lambda x: stats.norm.pdf(x, mu, sigma) f = lambda x: (x > 6).astype(float) # 估计 P(X > 6),真值约 3.17e-05 N = 200_000 # 直接采样:绝大多数样本权重为零 x = rng.normal(mu, sigma, N) est1 = f(x).mean() se1 = f(x).std() / np.sqrt(N) # 重要性采样:提议分布搬到尾部 q = stats.norm(7, 1.5) xq = q.rvs(size=N, random_state=1) w = target(xq) / q.pdf(xq) est2 = (f(xq) * w).mean() se2 = (f(xq) * w).std() / np.sqrt(N) print(f"直接: {est1:.3e} ± {se1:.2e}") print(f"重要性: {est2:.3e} ± {se2:.2e}") # 真值 3.17e-05;直接法的标准误差与真值同量级(几乎全是噪声), # 重要性采样的标准误差小一到两个数量级
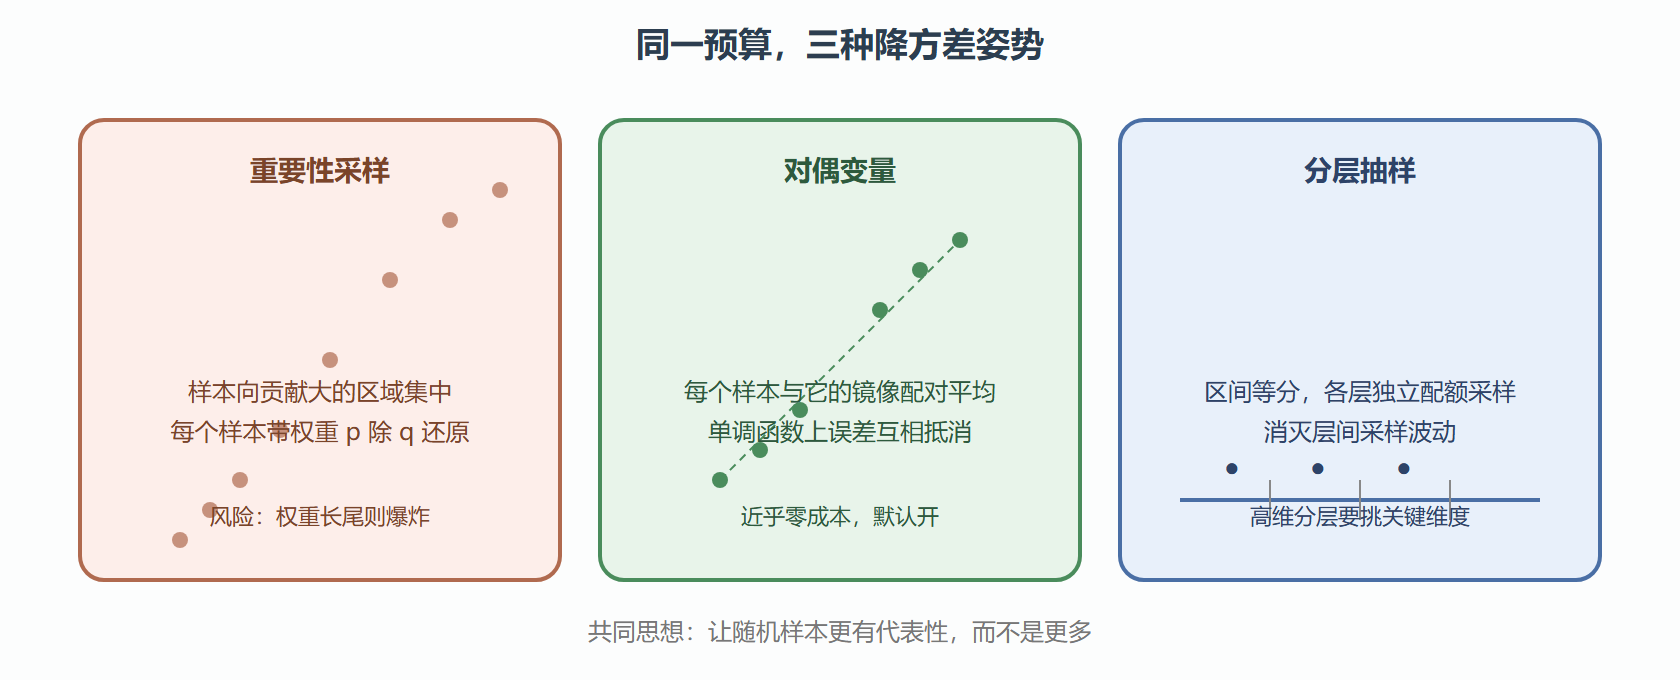
权重机制的直觉:q 把样本搬到关键区域,每个样本再按 p/q 加权"还原分布"。q 选得好(形状接近 |f|·p),方差趋零;q 的尾部比 p 薄(权重无界),方差爆炸——重要性采样的失败模式是权重长尾,工程上必须监控最大权重占比。
三、对偶变量:免费的午餐
许多被积函数关于"中心对称"有单调性,配对使用 x 与它的镜像(如 u 与 1-u)能让两个估计的误差部分抵消:
import numpy as np rng = np.random.default_rng(7) N = 100_000 u1 = rng.random(N) u2 = 1.0 - u1 # 与 u1 完全负相关 f = lambda u: np.exp(u) # 目标:积分 e^u 从 0 到 1 = e-1 est_naive = (f(rng.random(2*N))).mean() est_av = 0.5 * (f(u1) + f(u2)).mean() se_av = (0.5*(f(u1)+f(u2))).std() / np.sqrt(N) se_naive = f(rng.random(2*N)).std() / np.sqrt(2*N) print(f"朴素方差 se: {se_naive:.5f}") print(f"对偶方差 se: {se_av:.5f}") # 显著更小,且未增加任何函数评估
适用判据一句话:f 单调时对偶变量必赚(负相关的两个估计平均后方差下降);f 关于对称点剧烈震荡时收益归零。成本几乎为零,值得默认尝试。
图 5.1-1 三种方差缩减技术的机制对比
四、分层抽样与准蒙特卡罗一瞥
把积分区间切成 L 层,每层内独立采样固定配额,总方差 = 层内方差之和(层间方差被强行消灭)。当各层内部差异小、层间差异大时收益显著——它是"分层"思想在数值积分里的化身,调查统计学的分层抽样同源。
准蒙特卡罗(QMC)则更激进:用低差异序列(Sobol、Halton)代替伪随机数,把收敛率从 1/√N 提升到近似 1/N(对合适的光滑性类)。SciPy 直接可用:
from scipy.stats import qmc import numpy as np d, N = 8, 4096 sobol = qmc.Sobol(d, scramble=True, seed=1) X = 2*sobol.random(N) - 1 val = np.exp(-(X**2).sum(axis=1)).mean() # 8 维高斯型积分 print(f"Sobol QMC 估计: {val:.6f}") # 同样 N 下 QMC 的实际误差通常比伪随机 MC 小一个数量级
边界提示:QMC 的优势随维度衰减、且有效样本量以 2 的幂为佳;金融衍生品定价(维度几十、被积函数较光滑)是它的经典主场。
⚠️ 常见坑:蒙特卡罗结果只报一个数。"估计 0.00249"不是交付物,"0.00249 ± 0.00003(95% 置信)"才是——重跑一次结果变了不知道差多少,等于没做误差分析,这在第六章验证清单里是硬性条目。
本节要点回顾
- 维度无关 + 根号收敛:误差 σ/√N 与 d 无关,但精度每提一位要百倍样本——方差缩减是第一生产力
- 重要性采样:权重 p/q 还原分布,选得好方差骤降,尾部覆盖不足会爆炸,须监控权重
- 对偶变量:单调函数上的免费午餐,默认开启的廉价手段
- 分层与 QMC:分层消灭层间波动;低差异序列把收敛率提到约 1/N,光滑中等维问题首选
- 报告纪律:估计值 ± 标准误差是蒙特卡罗交付的最小完整格式
下一节把视角从"计算积分"升到"理解模型":当输入本身不确定,哪些参数在主导输出的不确定性?