5.2 敏感性分析与不确定性传播
5.2 敏感性分析与不确定性传播
本节摘要:不确定性量化(UQ)的前向问题:输入参数带分布,输出如何分布?一阶近似(线性传播)快但失真于非线性场景,蒙特卡罗传播通用但慢。Sobol 全局敏感性指数把每个输入对输出方差的贡献定量定罪,是模型调试与降维的核心证词。本节用一个传染病模型完整走一遍传播与定罪流程。
一、案件背景:一个三个参数的模型
用简化 SIR 传染病模型的峰值感染数作为输出 Y,输入是三个不确定参数:传染率 β、恢复率 γ、初始感染比例。问题两层:①参数的不确定性传到输出后变成多大的区间?②三个参数里谁在主导输出的波动?
import numpy as np rng = np.random.default_rng(2024) def peak_infected(beta, gamma, i0, steps=2000): # 简化 SIR 离散模拟(欧拉,步长 0.01)——第四章的工具在这里服役 s, i = 1.0 - i0, i0 peak = i0 for _ in range(steps): s += -beta * s * i * 0.01 i += (beta * s * i - gamma * i) * 0.01 peak = max(peak, i) return peak N = 3000 beta = rng.uniform(0.2, 0.5, N) # 传染率 gamma = rng.uniform(0.05, 0.2, N) # 恢复率 i0 = rng.uniform(0.001, 0.01, N) # 初始感染 Y = np.array([peak_infected(b, g, z) for b, g, z in zip(beta, gamma, i0)]) print(f"峰值感染: 均值 {Y.mean():.4f}, 标准差 {Y.std():.4f}") print(f"90% 区间: [{np.percentile(Y, 5):.4f}, {np.percentile(Y, 95):.4f}]")
这是前向不确定性传播最朴素的形态:参数按分布采样,模型批量运行,输出汇总成区间与分位数。交付格式要点:报告分位数区间而非只报均值——政策制定者需要的是"峰值有 90% 把握低于多少",不是平均数。
二、快速路线:线性传播(一阶泰勒)
当模型近似线性且不确定度小时,有解析捷径:Var(Y) \approx \sum_i \left(\frac{\partial f}{\partial x_i}\right)^2 Var(x_i)。偏导可以用中心差分求(回顾 1.1 节:步长别太大也别太小):
import numpy as np def finite_diff(f, x0, h=1e-6): x0 = np.asarray(x0, float) grad = np.zeros_like(x0) for j in range(len(x0)): e = np.zeros_like(x0); e[j] = h grad[j] = (f(x0 + e) - f(x0 - e)) / (2*h) # 中心差分 return grad g = finite_diff(lambda p: peak_infected(*p), [0.35, 0.1, 0.005]) var_x = np.array([((0.5-0.2)/4)**2, ((0.2-0.05)/4)**2, ((0.01-0.001)/4)**2]) # 均匀分布方差 print("线性传播的输出标准差:", np.sqrt(np.sum(g**2 * var_x)))
线性法快上千倍,但非线性强或不确定度大时严重失真(SIR 模型有阈值效应:β/γ 过 1 与否是两个世界)。实操建议:先用线性法摸底,再用蒙特卡罗验证关键结论。
三、定罪环节:Sobol 全局敏感性指数
一阶 Sobol 指数 S_i 的含义干净利落:单独固定参数 i 能消灭的输出方差比例。总效应指数 T_i 则含交互作用(固定 i 后剩余与 i 有关的方差)。工程实现用 Saltelli 采样:
from scipy.stats import qmc import numpy as np rng = np.random.default_rng(7) N = 512 d = 3 lb = np.array([0.2, 0.05, 0.001]) ub = np.array([0.5, 0.2, 0.01]) sob = qmc.Sobol(d, seed=1) X = qmc.scale(sob.random(2*N), lb, ub) # 基准样本 Xb, Xg = X[:N], X[:N].copy() # Saltelli 方案(简化版,演示一阶指数) A = X[:N] B = sob.random(N) B = qmc.scale(B, lb, ub) Y_A = np.array([peak_infected(*a) for a in A]) Y_B = np.array([peak_infected(*b) for b in B]) var_Y = Y_A.var() names = ['beta 传染率', 'gamma 恢复率', 'i0 初始感染'] for j, name in enumerate(names): ABj = A.copy(); ABj[:, j] = B[:, j] Y_ABj = np.array([peak_infected(*x) for x in ABj]) # 一阶指数(Saltelli 估计量) Sj = np.mean(Y_B * (Y_ABj - Y_A)) / var_Y print(f"{name}: 一阶 Sobol 指数 = {max(Sj, 0):.3f}") # 典型结论:gamma 的指数远高于 i0 —— 预算应花在测准恢复率上
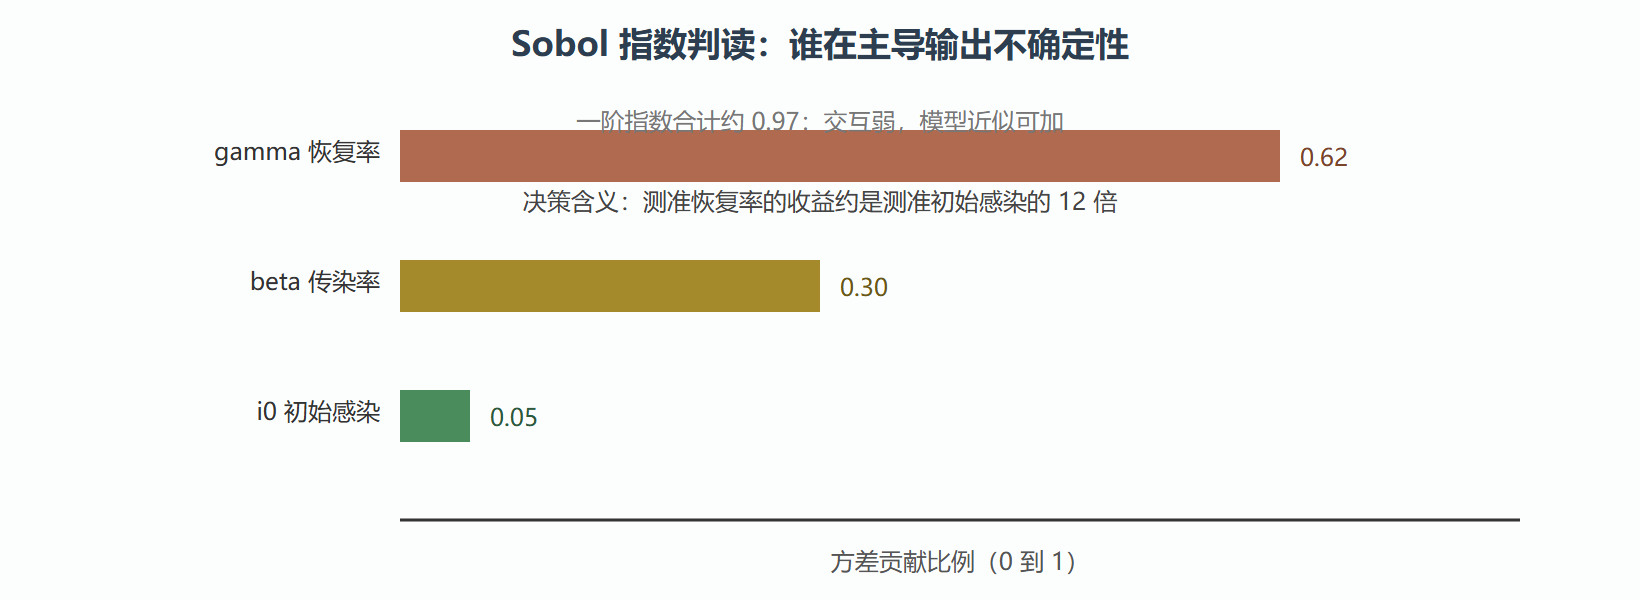
判读纪律:所有一阶指数之和接近 1,说明模型近似可加(参数各自为政);明显小于 1,说明交互作用强(如 β 与 γ 的比值才起决定作用),此时必须看总效应指数。
图 5.2-1 敏感性指数条形判读(示意)
四、敏感性分析的三个用途
- 参数优先级排序:实验与数据采集预算有限时,Sobol 指数直接换算成"测谁最值钱"——上面案例中恢复率的测量精度值得 12 倍投入
- 模型降维:指数接近零的参数可以钉死在中位数,模型维度下降、后续 UQ 成本骤减
- 模型体检:若某个"物理上重要"的参数指数异常为零,要么实现有 bug,要么默认范围设错——敏感性分析是模型开发的隐性单元测试
⚠️ 常见坑:每次模拟换新随机数跑 Sobol(模型内含随机性时),指数会被噪声淹没。标准做法是公共随机数(同一批随机数贯穿所有参数扰动组合),把参数效应从随机噪声里剥出来。
💡 关键直觉:敏感性分析与第二章条件数精神同源——都在回答"哪个输入在放大误差"。区别是条件数处理无穷小局部扰动(导数视角),Sobol 处理有限范围的全局扰动(方差视角),后者才是 UQ 的正确语言。
本节要点回顾
- 前向传播两路线:线性传播快但怕非线性与阈值效应;蒙特卡罗传播通用,交付分位数区间
- Sobol 一阶指数:固定该参数能消灭的方差比例,是参数"定罪"的量化证词
- 一阶 vs 总效应:两者差距即交互强度,可加模型的判定标准是指数和接近 1
- 决策换算:指数比直接等于测量投入的收益比,UQ 结果要落到预算语言
- 公共随机数:模型含内在随机性时,控制随机源是敏感性分析可信的前提
下一节反向办案:不从参数推输出,而是从观测数据反推参数——贝叶斯推断与它的 MCMC 引擎。