5.3 贝叶斯推断与 MCMC
5.3 贝叶斯推断与 MCMC
本节摘要:贝叶斯推断把参数当随机变量,用后验分布整合先验与数据似然;后验的无解析积分由 MCMC 数值求解。Metropolis-Hastings 算法只需未归一化的后验密度即可采样,但收敛与混合质量必须用迹图和自相关时间诊断。本节实现完整的 MH 采样器完成一个拟合案件。
一、案件设定:从观测数据反推参数
前两节都是"参数推输出"的正向办案。反向案件更贴近实际:观测到一批带噪声的数据,要反推生成它们的参数。贝叶斯的办案逻辑是把参数 θ 当随机变量,计算后验:
为什么反向案件天然难:分母(证据)需要对 θ 做高维积分——第五章开头说的那个维度诅咒问题绕了一圈又回来了。MCMC 的聪明之处:采样不需要归一化常数,而归一化常数恰恰是那个算不动的积分。比例符号里的推断,就是全部技巧所在。
设定具体案件:观测 y = a·x + b 加噪声,反推 (a, b):
import numpy as np rng = np.random.default_rng(5) x = np.linspace(0, 10, 40) a_true, b_true, sigma = 2.5, 1.0, 0.8 y = a_true * x + b_true + rng.normal(0, sigma, x.size) def log_prior(theta): a, b = theta return 0.0 if (0 < a < 5 and -5 < b < 5) else -np.inf # 均匀先验 def log_likelihood(theta): a, b = theta resid = y - (a * x + b) return -0.5 * np.sum((resid / sigma)**2) def log_posterior(theta): lp = log_prior(theta) return lp + log_likelihood(theta) if np.isfinite(lp) else -np.inf
注意:整个推断只需要未归一化的对数后验——先验加似然,没有分母。对数域计算同时规避了 1.3 节讲的下溢问题(四十个概率密度连乘早已下溢)。
二、Metropolis-Hastings:猜-审-纳的采样协议
MH 的循环三步:从当前点提出候选(提议分布)→ 按后验概率比决定接受或拒绝 → 被拒就原地复制。完整实现:
import numpy as np def metropolis_hastings(log_post, x0, n_samples, prop_std): d = len(x0) chain = np.zeros((n_samples, d)) theta = np.array(x0, float) logp = log_post(theta) n_acc = 0 for i in range(n_samples): prop = theta + np.random.default_rng().normal(0, prop_std, d) logp_prop = log_post(prop) # 对数域的接受比:避免下溢,且对称提议下比值即后验差 if np.log(np.random.default_rng().random()) < logp_prop - logp: theta, logp = prop, logp_prop n_acc += 1 chain[i] = theta return chain, n_acc / n_samples chain, acc_rate = metropolis_hastings(log_posterior, [1.0, 0.0], 12000, 0.05) print(f"接受率: {acc_rate:.2f}") burn = 2000 post = chain[burn:] print(f"a 后验均值 {post[:,0].mean():.3f}(真值 {a_true})," f"95% 区间 [{np.percentile(post[:,0],2.5):.3f}, {np.percentile(post[:,0],97.5):.3f}]") print(f"b 后验均值 {post[:,1].mean():.3f}(真值 {b_true})")
为什么这么简单就能行:接受规则保证链的平稳分布恰是后验——直觉是"链在概率高的地方停留久、概率低的地方快走"。真值落在 95% 区间内,说明推断合同兑现。
接受率的调参窗口:目标 0.2 到 0.5。提议步子太大,处处被拒,链原地踏步;步子太小,几乎全接受,链挪不动窝。这本质上是 3.2 节信赖域思想在采样里的重演——步长由命中率反馈调节。
三、取证:MCMC 结果的质检清单
MCMC 的结果没有"收敛成功"的机器印章,必须人证物证齐全才能交付:
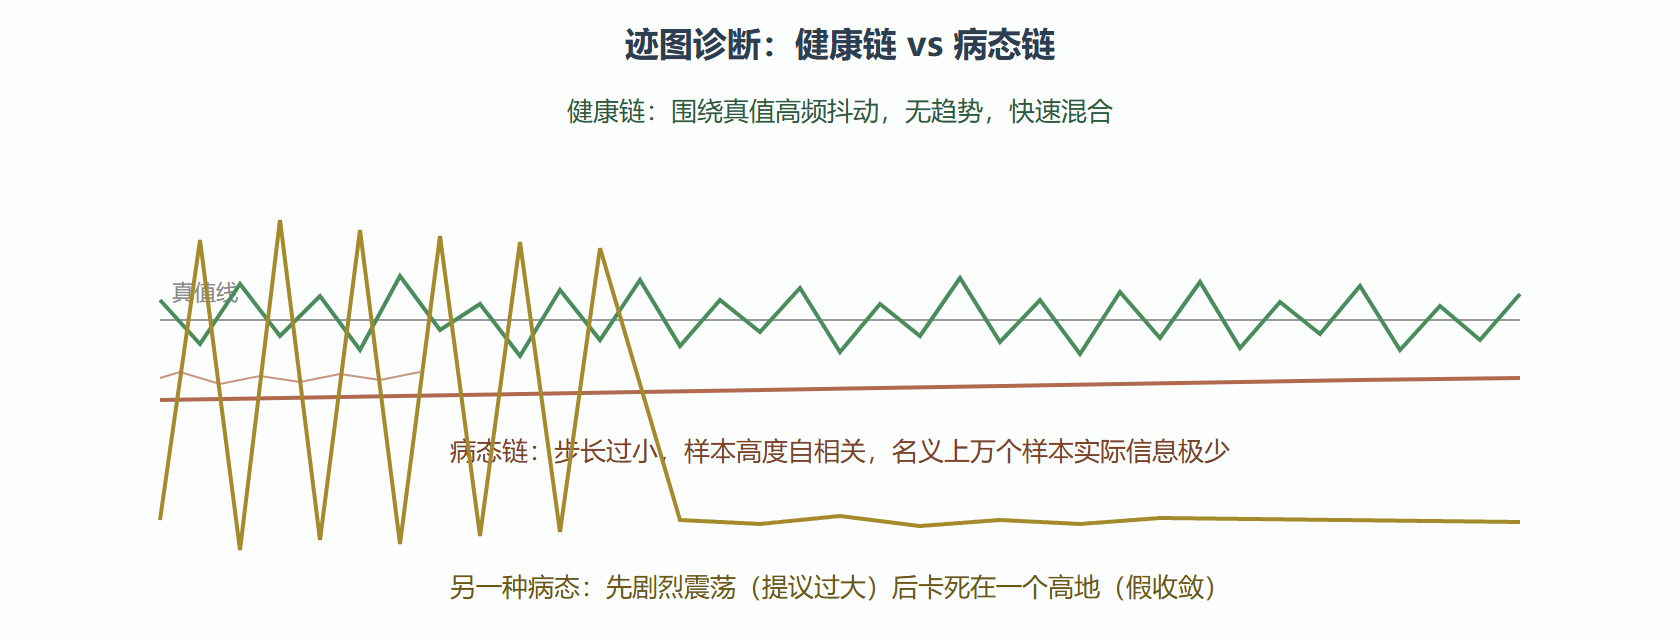
物证一:迹图。把链的每个分量按迭代次序画折线,健康样本是"毛茸茸的毛毛虫"——无趋势、充满抖动;病态样本是长时间水平线(卡在某处)或缓慢漂移(未混合)。
物证二:自相关时间。相邻样本相关,有效样本量远小于表面数量:
def autocorr_time(x, max_lag=500): x = x - x.mean() acf = np.correlate(x, x, 'full')[len(x)-1:] / (x*x).sum() # 截断求和估计(Geyer 初始正序列法的简化版) tau = 1.0 for k in range(1, max_lag): if acf[k] < 0 or k > 2*tau: break tau += 2 * acf[k] return tau tau_a = autocorr_time(post[:,0]) print(f"a 的自相关时间约 {tau_a:.1f}," f"12000 个样本的有效样本量约 {len(post)/tau_a:.0f}")
有效样本量除以自相关时间才是真实信息量——表面 1 万个样本,自相关时间 20 的话实际只有 500 个独立信息。区间估计、均值估计的误差都要按有效样本量算。
图 5.3-1 MCMC 链健康状况对比(示意)
物证三:多链一致性。从不同初值跑四条链,用 Gelman-Rubin 统计量(R-hat)检验链间差异——R-hat 明显大于 1 说明有链困在局部模式,后验可能多峰。这是多峰后验(如 3.2 节多根问题在统计里的化身)唯一可靠的发现手段。
⚠️ 常见坑一:不烧样本直接用全链。初期的样本反映初值位置而非后验,前一段(burn-in)必须丢弃,丢弃长度应大于数倍自相关时间。
⚠️ 常见坑二:报告后验均值时不附区间。贝叶斯的交付物是分布,至少给出中位数与 95% 可信区间;"均值 2.48 ± 0.07"比单点 2.48 多了全部的误差信息。
四、工具升级路线
手写 MH 的价值在于看穿机制;生产环境按问题特征升级:共轭结构用 Gibbs;高维光滑后验用 HMC(把 3.3 节的哈密顿动力学搬进采样,借助梯度信息把有效样本量提升一个量级,背后引擎正是第四章的 ODE 积分器);PyMC、Stan 等库把诊断(R-hat、发散报告)自动化。但无论工具多自动,迹图与自相关的判读能力不能外包——库也会产出看似成功实则未混合的链。
本节要点回顾
- 贝叶斯 = 反向案件 + 积分困难:后验正比于似然乘先验,MCMC 靠"只需比例"绕开算不动的归一化积分
- MH 三步协议:提议、按概率比裁决、拒绝则原地复制;接受率目标 0.2 到 0.5
- 对数域计算:似然连乘必下溢,log 后验差即接受比
- 质检三物证:迹图看混合、自相关时间算有效样本量、多链 R-hat 查多峰
- 交付纪律:后验以区间形式交付,burn-in 必烧,诊断不可省略
第五章结卷。最后一章回到工程现场:工具边界、验证清单与排错手册,把五章的方法论装配成可交付的生产线。