4.1 随机规划与鲁棒优化
4.1 随机规划与鲁棒优化
本节摘要:随机规划用概率分布刻画不确定参数,鲁棒优化只用"参数落在某集合内"的弱假设。本节以应急物资预置为战例,演示期望模型、两阶段 recourse 结构、机会约束与鲁棒对应物四种建模态度的差异,并给出按"分布已知度 + 风险偏好"选型的决策表。
台风来之前,仓库该囤多少
应急部门要在台风登陆前决定预置物资量:囤多了占用预算并可能浪费,囤少了灾区断供的代价极高。需求是什么?气象部门只给一个情景分布:弱台风概率 0.5(需求 1000 件)、中台风 0.3(需求 3000)、强台风 0.2(需求 6000)。
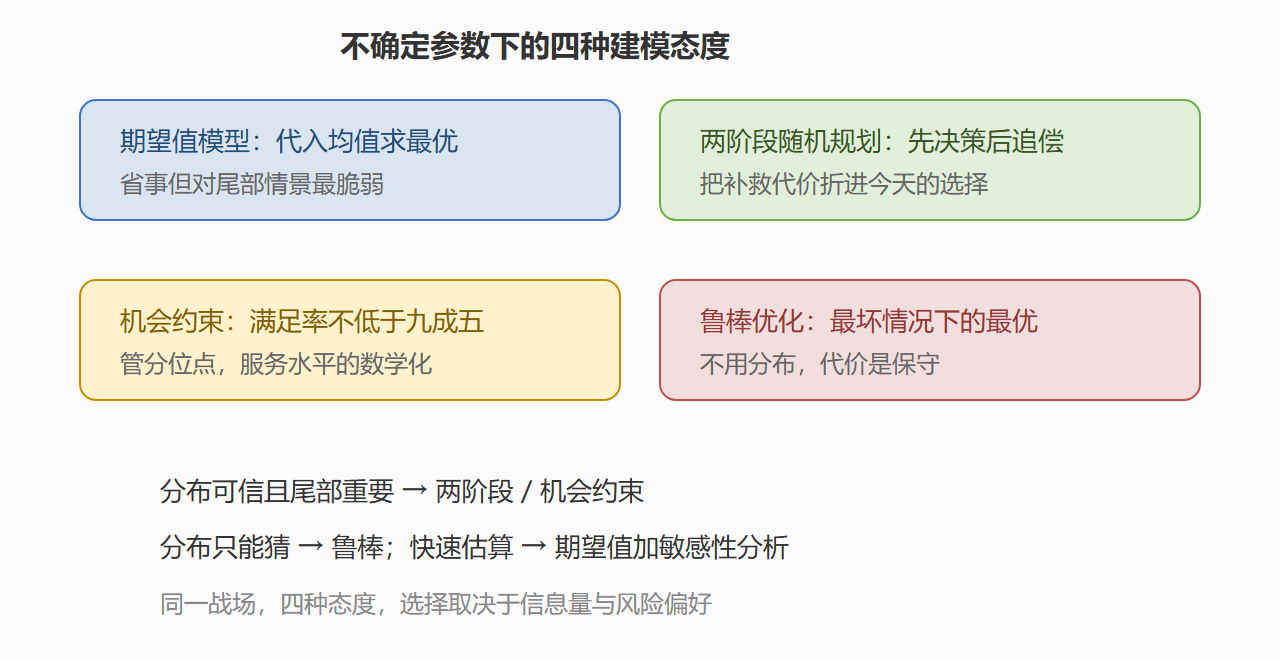
第一种最朴素的处理是期望值模型:把需求换成期望值 0.5×1000+0.3×3000+0.2×6000 = 2500,按确定性规划求解。它的问题一眼可见:2500 的备货在强台风情景下缺口 3500 件,而这正是代价最高的情景。均值最优在尾部情景里常常是最差的选择——期望值抹平了分布的形状,而决策的疼痛恰恰长在尾部。
两阶段:先决策,看到情景再追偿
标准的随机规划结构是两阶段:第一阶段在雾中决定预置量 x;台风强度揭晓后,第二阶段按实际缺口做补救(紧急空运,单价更贵)。目标是最小化"预置成本 + 各情景补救成本的期望":
import numpy as np scen_req = np.array([1000.0, 3000.0, 6000.0]) # 三种情景的需求 probs = np.array([0.5, 0.3, 0.2]) c_pre, c_emerg = 2.0, 8.0 # 预置与紧急单价 def total_cost(x): shortage = np.maximum(scen_req - x, 0) # 各情景缺口 return c_pre * x + np.sum(probs * c_emerg * shortage) best = min((total_cost(x), x) for x in range(0, 8000, 100)) print(f"两阶段最优预置量 {best[1]} 件,期望总成本 {best[0]:.0f} 元") # 期望模型预置 2500 件 cost = 2*2500 + 8*期望缺口 2200 = 22600 # 两阶段最优预置 6000 件 cost = 12000,全情景无缺口
结果颇有戏剧性:考虑追偿成本后,最优预置量直接顶到最高情景——因为紧急单价是预置的 4 倍,赌不起。这正是两阶段模型的价值:它把"事后补救的代价"折算进今天的决策,管理者看到的不再是单一数字,而是"现在多花 1 元能否省下未来的 4 元"。
机会约束与鲁棒:另外两种态度
机会约束换一个问法:不追求期望最优,而是要求"需求被满足"这一事件以至少 95% 的概率成立。本例中按概率排序,覆盖 0.5+0.3 = 0.8 不到 95%,必须覆盖到强台风情景,预置量同样是 6000。它对应的风险语言是分位数(VaR 的表亲):约束的是损失分布的分位点,而不是均值。
鲁棒优化更悲观也更省事:它干脆不假设知道概率,只说"需求落在区间 [1000, 6000] 里",然后求最坏情况下的最优——本例最坏需求 6000,解还是 6000。三种态度何时分野?看一个需求更平缓的变体就清楚了:
def robust_cost(x, lo, hi): # 只知道需求在区间内,按最坏情况计 worst_short = max(hi - x, 0) return c_pre * x + c_emerg * worst_short for label, req in [("分布集中", np.array([2800.0, 3000.0, 3200.0])), ("分布分散", np.array([1000.0, 3000.0, 9000.0]))]: sp = min((total_cost(x), x) for x in range(0, 12000, 100)) rb = min((robust_cost(x, req.min(), req.max()), x) for x in range(0, 12000, 100)) print(f"{label}: 随机规划囤 {sp[1]},鲁棒囤 {rb[1]}")
分布集中时两者几乎一致;分布分散且低概率尾部巨大时,鲁棒解显著更保守(可能为 1% 的极端情景付出双倍囤货)。随机规划用分布换精度,鲁棒优化用保守换免疫——分布信息可信就选前者,分布本身是猜的就选后者。
四种建模态度对比
⚠️ 常见坑:情景树爆炸。两阶段模型要遍历情景组合,情景数随阶段数指数增长;实战常用样本平均近似(SAA)抽样几十上百个情景代替全空间,再用置信区间评估解的质量。
样本平均近似:分布未知时的落地术
实战中常常连概率分布都没有,只有历史数据。此时两阶段随机规划的主流落地术是样本平均近似:从历史数据里抽若干情景当作"经验分布",在样本上求解,再换一批样本验证解的稳健性。样本量的选择有个实用的经验区间:情景数取决策变量数的五到十倍时,解的质量通常进入平台期;继续加情景,求解时间线性涨而解几乎不再变。另一个要点是解的验证要与求解分开——用第二批样本评估第一批样本得出的解,避免"用训练数据考自己"的乐观偏差。样本平均近似与机器学习的训练验证分割在思想上完全一致,这也是运筹与学习在方法论层早已互通的又一处证据。当历史数据也稀薄时(新产品、新政策场景),退回鲁棒优化用区间说话,是更诚实的姿势。
还要澄清一个常见误会:随机规划与鲁棒优化不是二选一的教条,而是同一谱系上的两端,中间还有一族混合方法。分布鲁棒优化取两者之长——不假设确切分布,只假设分布属于某个以经验分布为中心的模糊集合,然后在最坏分布下求最优。它的解介于随机规划的进取与纯鲁棒的保守之间,近年在电力与金融的风险管理里迅速铺开。入门阶段不必追新,先把两端的直觉打牢,谱系中间的一切方法都只是这两端态度的配比调整。
本节要点回顾
- 期望值模型抹平分布形状,尾部代价高的场景下不可用;
- 两阶段结构:雾中先决策,情景揭晓后追偿,补救单价决定保守程度;
- 机会约束管分位点,是服务水平协议(SLA)的直接数学对应物;
- 鲁棒优化不依赖分布,用保守换免疫,分布信息越少越值得选;
- 选型两问:分布可信吗?尾部有多疼?答案组合直接指向四种态度之一。
下一节把镜头对准排队的服务台:顾客随机到达、服务随机耗时,等待的队列自己会说话。