4.2 排队论:服务系统的兵力测算
4.2 排队论:服务系统的兵力测算
本节摘要:排队论研究随机到达与服务容量匹配的数学,核心模型 M/M/1 与 M/M/c,核心公式是 Little 公式 L = λW。本节以客服中心为例推演利用率、队长、等待时间的计算,揭示"利用率越接近 1,等待时间爆炸"的非线性规律,并演示多服务台与仿真两条验证路径。
为什么周五下午的客服永远占线
客服中心的数据:平均每分钟来 8 个电话(泊松到达),每个坐席平均 6 分钟处理一个(指数服务)。主管的算术是:一个坐席每分钟处理 1/6 个电话,8 ÷ (1/6) = 48 个坐席就"刚好够用"。于是排 48 人,结果周五下午平均等待仍然逼近一小时,投诉激增。问题出在哪?
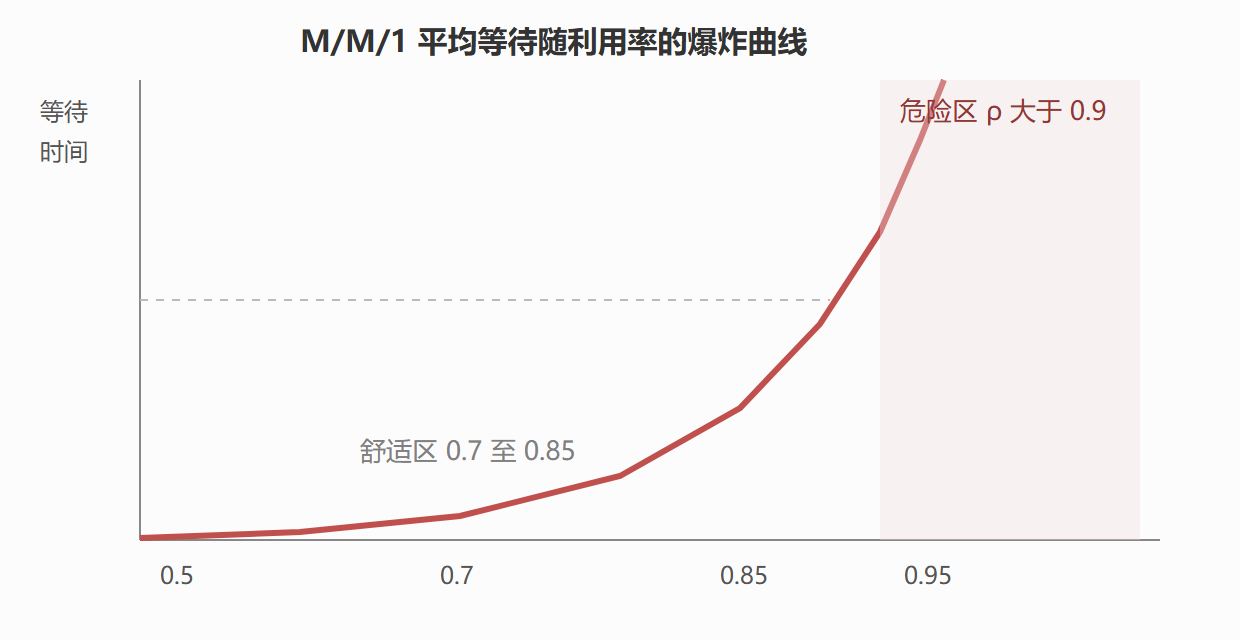
出在均值思维的盲区。到达是随机的:有时一分钟来 14 个,有时来 3 个。利用率 ρ = λ/(cμ) 恰好等于 1 时,系统在到达快的时候积压、慢的时候消化不掉,队列随时间只会越积越长。排队论的 M/M/1 等待时间公式(ρ 为利用率、μ 为单台服务率)形如 Wq = ρ/(μ−λ):当 ρ 趋近 1,分母趋近 0,等待时间不是线性增长而是爆炸。
import numpy as np import math lam, mu = 8.0, 1/6 # 每分钟到达8个,单坐席每分钟服务 1/6 个 for c in [48, 50, 52, 56, 64]: rho = lam / (c * mu) # 利用率 if rho >= 1: print(f"c={c}: 利用率 {rho:.2f} 系统不稳定,队列无限增长") continue # M/M/c 的 Erlang-C 近似:先算 Erlang C 概率 a = lam / mu # 总业务量(Erlang) s = 0.0 for k in range(c): s += a**k / math.factorial(k) last = a**c / math.factorial(c) * (1 / (1 - rho)) P_wait = last / (s + last) # 到达者需要等待的概率 Wq = P_wait / (c * mu - lam) # 平均等待(分钟) print(f"c={c}: 利用率 {rho:.2f} 需等待概率 {P_wait:.2f} 平均等待 {Wq:.1f} 分钟")
跑出来会看到陡峭的非线性:48 坐席不稳定;52 坐席等待几十分钟;64 坐席(利用率 0.75)等待骤降到一分钟以内。容量的边际收益在利用率 0.8 到 0.95 区间被"等待悬崖"吃掉——这就是为什么呼叫中心、急诊室、收费站都不敢按"刚好够用"排班。
Little 公式:一条守恒律
利用率与等待的悬崖曲线
排队论最优雅的结论是 Little 公式:L = λW——系统里的平均人数,等于到达率乘以平均逗留时间。它不依赖到达与服务分布、不依赖服务规则(先来先到还是优先级),是排队系统里的能量守恒。它的用处在于"算出一个、免费得到另一个":已知平均等待 5 分钟、每分钟来 8 人,立刻知道系统里平均滞留 40 个顾客——这在容量规划(等候区座位、队列内存)时极其顺手。三个变体同样成立:排队人数 Lq = λWq(等待队列)、服务台内人数 = λ×服务时间。
💡 关键直觉:利用率是排队系统的油门,等待时间是刹车距离。油门踩到 0.9 以上,刹车距离以不可思议的速度变长。稳妥的系统(急诊、应急)常年运行在 0.7 到 0.85;成本敏感的系统(呼叫中心错峰)可以到 0.9 以上,但必须用排队公式而非均值算过。
公式之外:仿真的价值
M/M/c 公式要求泊松到达、指数服务两个强假设。现实里服务时间往往不是指数(处理一个工单有最短时限),到达有高峰时段。此时退而用离散事件仿真:模拟每个顾客的到达时刻与服务时长,直接统计等待分布。它慢,但能吃下任何分布假设:
import numpy as np import math def simulate(c, minutes=600, seed=7): rng = np.random.default_rng(seed) arrivals = np.cumsum(rng.exponential(1/lam, int(lam*minutes*1.2))) arrivals = arrivals[arrivals < minutes] free_at = np.zeros(c) # 每个坐席的空闲时刻 waits = [] for t in arrivals: i = np.argmin(free_at) # 最早空闲的坐席 start = max(free_at[i], t) waits.append(start - t) free_at[i] = start + rng.exponential(mu**-1) return np.array(waits) for c in [52, 64]: w = simulate(c) print(f"c={c}: 平均等待 {w.mean():.1f} 分钟,90分位 {np.percentile(w, 90):.1f} 分钟")
注意 90 分位数这个指标:管理者真正关心的往往不是平均,而是"九成顾客等多久"。公式给分位数很费劲,仿真一 行 np.percentile 就交卷——这是仿真在实战里永远有一席之地的原因。第 9 章会把离散事件仿真与优化求解器拼成完整的推演流水线。
排队系统的三条运营杠杆
排队公式不只是算命工具,它指向三条可操作的运营杠杆。杠杆一,削峰:到达率是公式的分子,把周五下午的批量需求分流到平峰(预约制、错峰折扣、弹性截止时间),比加坐席便宜得多——电话客服的回调机制(不留在线排队,留号码回拨)本质就是把在线等待转化为离线等待,体验成本骤降。杠杆二,压缩波动:服务时间的方差直接进入等待公式,把服务流程标准化、把复杂工单分流给专人,缩小方差就是在不加人的情况下缩短队伍。杠杆三,分级:快慢分离让短任务不被长任务阻塞,全系统的平均等待显著下降——超市快速通道、工单优先级队列都是这个原理。三条杠杆都不动到达率与服务率本身,动的是分布的形状——这正是排队论比均值算术高明的地方。
本节要点回顾
- 均值算容量必然撞上等待悬崖:ρ → 1 时等待时间按 1/(1−ρ) 量级爆炸;
- M/M/c 三件套:Erlang-C 算等待概率,Wq 算等待时间,ρ 判稳定(ρ < 1);
- Little 公式 L = λW 是分布无关的守恒律,队长与逗留时间知一得一;
- 关键运营指标看分位数:90 分位等待比平均等待更能代表顾客体感;
- 公式管稳态、仿真管现实:分布假设破灭时,离散事件仿真是最后的裁判。
排队的数学管"人等多久",下一节管"货备多少"——库存论把本章的随机需求落到每一天的补货单上。