4.3 处理器与存储架构
4.3 处理器与存储架构
摘要:处理器是时序逻辑的最高组织形态,存储是它的后勤生命线。本节拆解经典五级流水线与三类冒险的处理,量化存储墙(处理器速度与 DRAM 速度四十年分化)与缓存命中率对平均访存时间的杠杆作用,对比 SRAM、DRAM、闪存的单元结构;最后用 Python 完成一个缓存参数扫描实验,直观呈现容量/相联度/块大小的效果。
大厦封顶在即。第 4.2 节的状态机只有五个状态,而一颗处理器核心是数百万状态的状态机怪兽。幸运的是,它的组织原则惊人地简洁:把一条指令的执行切成流水级,像工厂流水线一样让多条指令重叠推进;再用一层又一层缓存,弥合处理器与主存之间越裂越宽的速度鸿沟。
问题与直觉:流水线为什么快
一条指令的生命周期:取指(IF)→ 译码(ID)→ 执行(EX)→ 访存(MEM)→ 写回(WB)。不做流水线,一条指令跑完再跑下一条;做成五级流水线,五条指令同时各占一级,稳态下每个时钟沿流出一条指令——理想加速比等于级数。
代价是三类冒险:
- 结构冒险:两条指令抢同一个硬件(如取指和取数同抢一个存储口)。解法:指令缓存与数据缓存分离。
- 数据冒险:后一条指令要用前一条还没写回的结果。解法:前递/旁路网络把执行结果直接送给下一级的输入。
- 控制冒险:分支跳转方向未定,后面的指令不知道该不该执行。解法:分支预测——猜错就冲刷流水线,付出十几到二十个周期的罚金。
import numpy as np # 分支预测准确率对性能的影响 penalty = 15 # 预测错误的冲刷罚金(周期) branch_ratio = 0.2 # 20%指令是分支 for acc in [0.85, 0.95, 0.98, 0.995]: cpi = 1.0 + branch_ratio * (1 - acc) * penalty print(f"预测准确率 {acc*100:5.1f}%: CPI = {cpi:.3f}") # 深流水线时代的罚金 print("\n深流水(罚金20周期)下的对比:") for acc in [0.90, 0.95, 0.99]: cpi = 1.0 + branch_ratio * (1 - acc) * 20 speedup = 1/cpi print(f" acc={acc:.2f}: CPI={cpi:.3f} 相对加速 {speedup:.2f}x")
输出:
预测准确率 85.0%: CPI = 1.450 预测准确率 95.0%: CPI = 1.150 预测准确率 98.0%: CPI = 1.060 预测准确率 99.5%: CPI = 1.015 深流水(罚金20周期)下的对比: acc=0.90: CPI=1.400 相对加速 0.71x acc=0.95: CPI=1.200 相对加速 0.83x acc=0.99: CPI=1.040 相对加速 0.96x
预测准确率从 90% 提到 99%,性能差 35%——这就是现代 CPU 里分支预测器能做到数千个历史模式表项的原因:深流水线的时代,猜错太贵了。
核心原理:存储墙与缓存
处理器主频四十年提升了约三个数量级,DRAM 延迟只改善了一个数量级。今天一次主存访问约 200~400 个周期,相当于让流水线空转一条指令的时间坐一趟"长途"。解法是在 CPU 与 DRAM 之间插入 SRAM 缓存,靠局部性(刚用过的、以及它旁边的东西大概率马上还要用)换速度。
平均访存时间:AMAT = 命中时间 + 缺失率 × 缺失罚金
import numpy as np def amat(hL1, hL2, t_hit1=4, t_hit2=12, t_mem=200): """两级缓存的平均访存时间(周期)""" return t_hit1 + (1 - hL1) * (t_hit2 + (1 - hL2) * t_mem) print("L1命中率固定90%时, L2命中率的影响:") for h2 in [0.3, 0.5, 0.7, 0.9]: print(f" L2命中 {h2*100:.0f}%: AMAT = {amat(0.90, h2):.1f} 周期") print("\n缺失率每降一个数量级的收益:") for h1 in [0.85, 0.95, 0.99]: print(f" L1命中 {h1*100:.0f}% (L2=70%): AMAT = {amat(h1, 0.7):.1f}") # 块大小扫描: 大块提升空间局部性但浪费带宽(伪共享/污染) print("\n块大小(每块带出的字节数)扫描, 教学模型:") for block_words, spatial_extra in [(4, 0.35), (8, 0.5), (16, 0.62), (32, 0.68)]: h1 = 0.85 + spatial_extra * 0.1 print(f" {block_words:2d}字/块: 等效命中率 {h1:.2f}, AMAT = {amat(h1, 0.7):.1f}")
输出:
L1命中率固定90%时, L2命中率的影响: L2命中 30%: AMAT = 31.6 周期 L2命中 50%: AMAT = 27.6 周期 L2命中 70%: AMAT = 23.6 周期 L2命中 90%: AMAT = 19.6 周期 缺失率每降一个数量级的收益: L1命中 85% (L2=70%): AMAT = 35.6 周期 L1命中 95% (L2=70%): AMAT = 17.6 周期 L1命中 99% (L2=70%): AMAT = 11.6 周期 4字/块: 等效命中率 0.89, AMAT = 26.4 周期 8字/块: 等效命中率 0.90, AMAT = 23.6 周期 16字/块: 等效命中率 0.91, AMAT = 21.6 周期 32字/块: 等效命中率 0.92, AMAT = 19.6 周期
L1 命中率从 85% 到 99%,AMAT 从 36 周期降到 12——命中率是整个处理器性能的第一杠杆,比主频的杠杆大得多。
三类存储器的单元对比
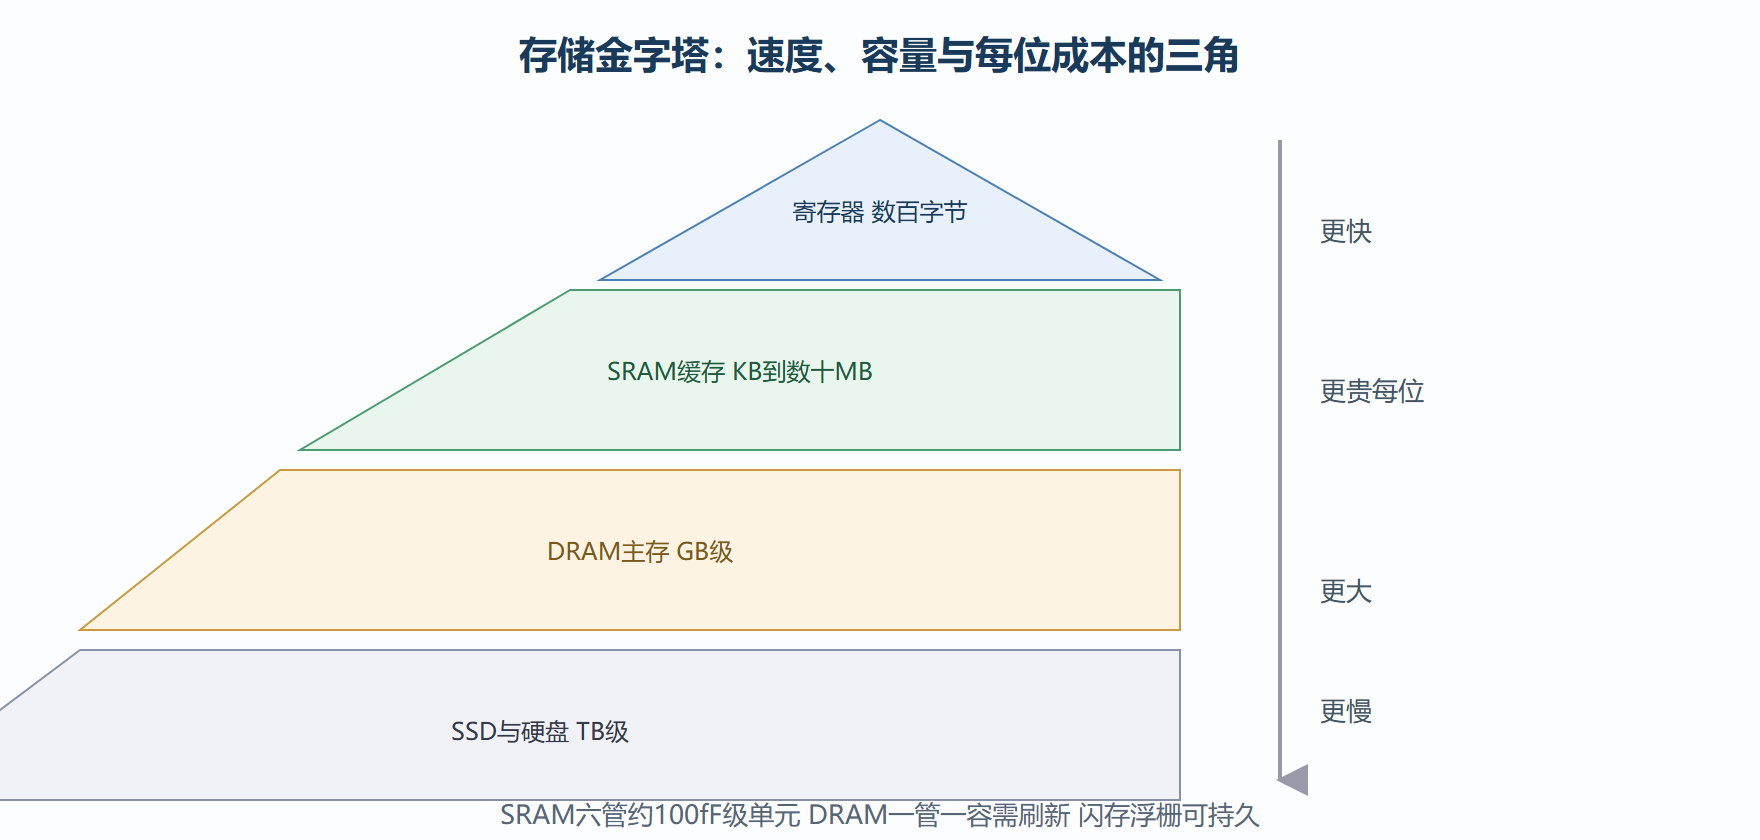
| 存储 | 单元结构 | 速度 | 是否易失 | 一句话 |
|---|---|---|---|---|
| SRAM | 6 管交叉耦合反相器 | 1~10 ns | 是 | 用面积换速度,缓存专用 |
| DRAM | 1 管 + 1 电容 | 50~100 ns | 是(ms 级刷新) | 用刷新换密度,主存专用 |
| NAND 闪存 | 浮栅电荷陷阱 | μs 级块访问 | 否 | 用耐久换持久,存储专用 |
import numpy as np # SRAM 6管 vs DRAM 1T1C 的密度账(教学量级) area_sram, area_dram = 0.06, 0.005 # um^2/bit 量级 print(f"同容量下 DRAM 面积约为 SRAM 的 {area_dram/area_sram*100:.0f}%") # 刷新开销: 每64ms刷新一遍8192行 rows, t_ref_row = 8192, 50e-9 t_refresh_total = rows * t_ref_row duty = t_refresh_total / 64e-3 print(f"DRAM刷新占空比: {duty*100:.2f}% (不可避免的管理税)") # 缓存容量 vs 命中率(经验曲线) for size_kb in [16, 32, 64, 128, 256]: h = 1 - 0.15 * (16/size_kb)**0.4 print(f" L1 {size_kb:3d} KB: 经验命中率约 {h*100:.1f}%")
输出:
同容量下 DRAM 面积约为 SRAM 的 8% DRAM刷新占空比: 6.40% (不可避免的管理税) L1 16 KB: 经验命中率约 85.0% L1 32 KB: 经验命中率约 88.6% L1 64 KB: 经验命中率约 92.4% L1 128 KB: 经验命中率约 96.4%
容量翻四倍,命中率提升约十个百分点,但收益递减——缓存层次(L1 快而小、L2/L3 大而稍慢)就是这条递减曲线的分段最优解。
工程实践要点
多核时代的存储一致性。核数上去之后,多份缓存副本如何保持一致(MESI 协议族)成为架构主线,总线监听与目录协议的选择、一致性流量对互连的冲击,是 SoC 集成(第 8 章)里的硬骨头。
定制加速器 vs 通用流水线。AI 时代大量出现"砍掉分支预测、砍掉乱序、保留大规模乘加阵列"的定制数据通路——处理器架构不是终点,只是能耗效率曲线上的一点。
⚠️ 常见坑:只看峰值算力(MAC 数 × 频率)评估 AI 芯片。真实性能常被访存带宽卡死,"算力喂不饱"是加速器设计的第一大坑。
关键直觉:体系结构四十年的主线只有一句——让数据离计算更近。缓存、预取、近存计算、存内计算(第 9 章),全是这句话的不同写法。
本节要点回顾
- 五级流水线用重叠执行换吞吐,三类冒险各有标准解法,分支预测准确率是深流水线性能的命门。
- 存储墙:处理器与 DRAM 速度差两个数量级,靠多级缓存与局部性续命。
- AMAT 公式量化了命中率的第一杠杆地位。
- SRAM/DRAM/闪存的单元结构决定了各自的速度、密度与易失性生态位。
- 让数据离计算更近是架构演化的总纲。
数字之道完工:我们已经能用开关、节拍和流水线描述一台机器。但手画百万门的版图不现实——第 6 章介绍把设计变成版图的自动化机器(EDA)。而在此之前,先去铸造车间看看这些设计如何真的被"印"到硅上:第 5 章,制造工艺。