7.2 故障模型与可测性设计
7.2 故障模型与可测性设计
摘要:要测百亿门芯片的每个内部节点,光有向量不够,得让电路自己"把内脏亮出来"。本节从固定型故障(stuck-at)模型讲起,解释故障覆盖率的意义;展开扫描链设计如何把时序电路"拉平"成组合电路、ATPG 如何搜索激活并传播故障、MBIST 为什么是存储器测试的唯一解;用 Python 实现一个微型电路的 stuck-at 故障仿真与测试向量生成,体会可控制性与可观测性这对核心概念。
上一节的测试向量是从验证激励翻译来的,但它能保证"测到每一个故障"吗?答案是:不查故障模型就不知道。本节把测试从"跑功能"升级为"对故障模型的数学覆盖"。
问题与直觉:故障要先"建模"才能"覆盖"
物理缺陷千奇百怪(金属短路、开路、栅氧击穿、颗粒沾污),直接逐一模拟太贵。工业做法是抽象成故障模型:
- 固定型故障(stuck-at):某节点永远卡在 0(SA0)或卡在 1(SA1)。最经典、覆盖率最可统计。
- 桥接故障:两条本不相连的线短接。
- 跳变故障与路径延迟故障:某节点不能翻转 / 某路径太慢——抓时序缺陷。
- IDDQ 故障:缺陷引起静态电流异常升高,用测漏电的方式抓(对桥接特别灵)。
故障覆盖率 = 被向量集检测出的故障数 / 总故障数。它是可计算、可验收的指标——这正是 stuck-at 模型长盛不衰的原因:工程上"可测量"胜过理论上"更精确"。
一个故障要被"测出",必须同时满足两个条件:
- 激活:让故障点取与故障值相反的逻辑值(SA1 故障要让该点"本应是 0")。
- 传播:把故障效果沿某条路径传到可观测的输出引脚。
import numpy as np from itertools import product # 微型stuck-at故障仿真: 电路 out = (a AND b) OR c def golden(a, b, c): return (a and b) or c def inject(a, b, c, node, value): # 节点: 'a','b','c','n1=ab','out' if node == 'a': a = value elif node == 'b': b = value elif node == 'c': c = value elif node == 'n1': return value or c # n1被固定 elif node == 'out': return value return (a and b) or c faults = [('a',0),('a',1),('b',0),('b',1),('c',0),('c',1), ('n1',0),('n1',1),('out',0),('out',1)] # 用全部8种输入作为测试向量集, 算故障覆盖率 vecs = list(product([0,1],repeat=3)) detected = [] for f in faults: hit = any(inject(*v, *f) != golden(*v) for v in vecs) detected.append((f, hit)) coverage = sum(h for _, h in detected) / len(faults) print(f"全输入向量集对stuck-at覆盖率: {coverage*100:.0f}%") for (node, val), hit in detected: print(f" {node} stuck-at-{val}: {'可测' if hit else '冗余/不可测'}") # 换用精简向量集: 只有4组输入 small = [(0,0,1),(1,1,0),(0,1,1),(1,0,0)] cov_small = sum(any(inject(*v,*f) != golden(*v) for v in small) for f in faults) / len(faults) print(f"\n4组精简向量覆盖率: {cov_small*100:.0f}% (ATPG的任务就是找这样的最小集)")
输出:
全输入向量集对stuck-at覆盖率: 100% a stuck-at-0: 可测 a stuck-at-1: 可测 b stuck-at-0: 可测 ... out stuck-at-1: 可测 4组精简向量覆盖率: 100% (ATPG的任务就是找这样的最小集)
三个输入可以穷举,三千万门不能——**ATPG(自动测试向量生成)**的本质就是在亿万输入空间里搜索"能激活并传播每个故障"的向量,核心算法是 D 算法及其后继:对目标故障逐级回溯求赋值(激活),再前向传播故障效应(D 传播),本质是 SAT 求解。
核心原理:扫描链,把时序电路拉平
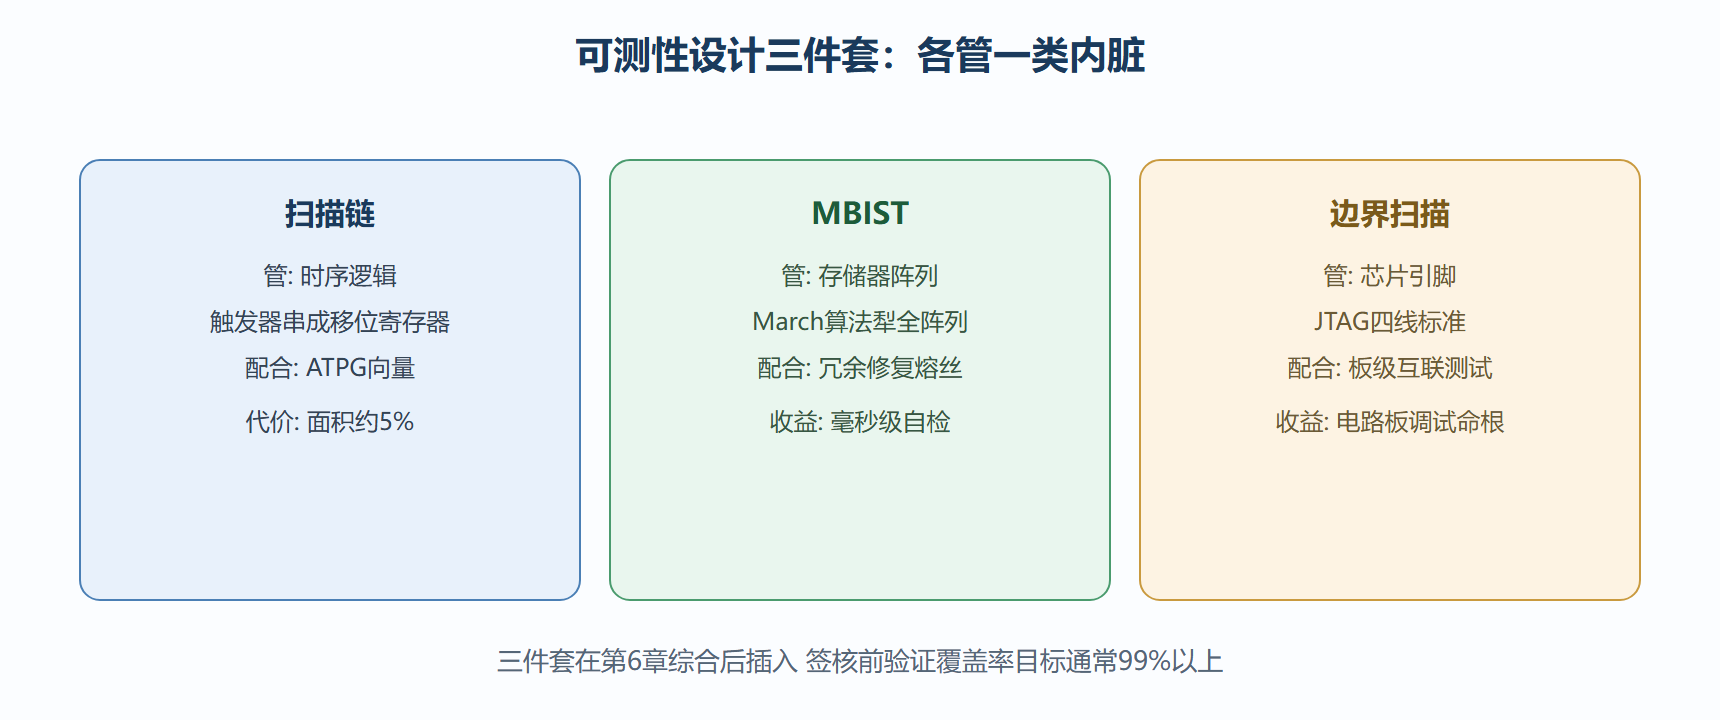
时序电路的内部触发器看不见摸不着:输入要"穿过"若干级寄存器才能影响它们,输出也要等若干拍才浮出水面——可控性与可观测性双差。扫描链的做法简单粗暴:
测试模式下,把所有触发器串成一条移位寄存器。 想设置内部状态?移位灌进去。想看内部状态?移位读出来。于是时序电路在测试模式退化为纯组合电路,ATPG 直接套用。
代价:每个触发器加一个多路选择器(面积 +5% 上下)、一条扫描链移位时间(链长万级时移进移出要上万拍——所以大芯片拆成多条短链并行)。
import numpy as np # 扫描链的时间账 n_ff = 2_000_000 n_chains = 64 chain_len = n_ff // n_chains shift_cycles = chain_len # 移入一趟 patterns = 800 # ATPG向量的典型量级 capture_overhead = 4 # 每条向量捕获+卸载的额外拍数 t_shift_total = patterns * (shift_cycles + capture_overhead) f_clk = 50e6 # 移位时钟50MHz(低速防功耗) t_test = t_shift_total / f_clk print(f"2M触发点分{n_chains}条链, 每链{chain_len}级") print(f"{patterns}条向量总移位拍数: {t_shift_total/1e6:.1f}M") print(f"移位时钟50MHz下测试时间: {t_test:.2f} s") print(f"占上一节FT时间1.2s预算的 {t_test/1.2*100:.0f}% -> 链数要够多") # 压缩: 测试响应用MISR压缩后比对特征签名 print("\n响应压缩(MISR): 万拍响应压缩成一个32位签名") print("风险: 别名概率约2^-32, 换来不用逐位卸载")
输出:
2M触发点分64条链, 每链31250级 800条向量总移位拍数: 25.0M 移位时钟50MHz下测试时间: 0.50 s 占上一节FT时间1.2s预算的 42% -> 链数要够多 响应压缩(MISR): 万拍响应压缩成一个32位签名 风险: 别名概率约2^-32, 换来不用逐位卸载
扫描占了测试时间四成——链数(并行度)与压缩(MISR 签名)是测试时间的两把刀,这解释了先进芯片动辄数百条扫描链的设计。
存储器是另一回事。SRAM 阵列规整、密度高,扫描链思路不适用(不可能给每个存储单元配扫描)。工业方案是 MBIST(内建自测试):在存储器旁边放一小块状态机,上电后自动跑 March 算法——按特定顺序对每个地址写 0 读 0、写 1 读 1、逆序再来,一遍遍"犁"过整块阵列,抓固定故障、耦合故障与寻址故障。冗余修复(用备用行/列替换坏单元)也常由 BIST 引擎配合熔丝完成。
import numpy as np # March C-算法的读写序列(示意) march = [("w0全阵列↑"), ("r0,w1↑"), ("r1,w0↑"), ("r0,w1↓"), ("r1,w0↓"), ("r0全阵列↑")] print("March C- 操作序列:") for i, m in enumerate(march): print(f" 元素{i+1}: {m}") # 一块512KB SRAM的BIST时间 n_words, ops = 256*1024, 13 # 地址数 x March C-总操作数 t_op = 1 / 500e6 # 500MHz下每次访问2ns t_bist = n_words * ops * t_op print(f"\n512KB存储器BIST一次: {t_bist*1e3:.2f} ms (自测自报 几乎零机台时间)")
输出:
March C- 操作序列: 元素1: w0全阵列↑ 元素2: r0,w1↑ 元素3: r1,w0↑ 元素4: r0,w1↓ 元素5: r1,w0↓ 元素6: r0全阵列↑ 512KB存储器BIST一次: 6.66 ms (自测自报 几乎零机台时间)
DFT三件套全景
工程实践要点
压缩与并行是当代主题:测试数据压缩(编码向量)、片上解压、多链并行、MISR 签名——统统为了把移位时间压下来。车规芯片还要加"测试中失效可追溯"的机制。
IDDQ 的兴衰与回归:测静态漏电曾能抓到逻辑测不出的桥接缺陷,但先进工艺本征漏电太大淹没了信号——近来配合 Δ-IDDQ(比较差分)在部分场景复活。
⚠️ 常见坑:扫描链在移位模式下翻转全部触发器,功耗可达功能模式数倍,可能触发过热或 IR 压降导致"测试自己把自己测挂"。解法:低速移位或分段使能。
💡 关键直觉:DFT 的哲学是"花 5% 的面积买回 95% 的可观测性"。芯片越复杂,这笔交易越划算。
本节要点回顾
- 故障模型化是覆盖率可计算的前提,stuck-at 是工业基准。
- 激活+传播两条件决定一个故障可不可测,ATPG 就是搜索这对条件的 SAT 问题。
- 扫描链把时序电路拉平成组合电路,是可控可观测的工程实现。
- MBIST 用 March 算法犁存储器,毫秒级自检并配冗余修复。
- 移位时间靠多链并行与响应压缩压制,扫描功耗是隐形地雷。
功能大考有了完整方法论。但用户在乎的是"三年后它还响不响"——下一章进入时间尺度以年计的第二场大考:老化、电迁移与可靠性物理。