9.1 纳米工艺与3D集成
9.1 纳米工艺与3D集成
摘要:平面微缩逼近物理与经济双重极限,行业把增长轴转向竖直方向。本节先算平面微缩的"物理账"(栅长、金属间距、隧穿漏电、EUV 成本),再看三维集成的技术阶梯:2.5D 中介层、TSV 堆叠、混合键合,各自的互连密度与热挑战;用 Python 对比 2D 单片与 3D 拆分的良率与互连能效,把第 5 章与第 8 章的账本续写到 z 轴。
第 1 章埋的伏笔在这里兑现:氧化层薄到十层原子时电子穿墙(隧穿);第 2 章:亚阈值摆幅 60 mV/dec 的热力学下限卡住低压缩放;第 5 章:互连 RC 随长度平方恶化,铜线才是真瓶颈。平面方向的路还剩多宽?
问题与直觉:平面微缩的双重天花板
物理天花板。器件层面,GAA 之后还有叉片、CFET(互补场效应管把 n 管和 p 管叠成一层)——栅控还有一两代余量;但金属间距缩到 20 nm 级后,铜阻挡层占掉线宽近半、电阻率因表面散射暴涨,互连每缩一代收益都在衰减。逻辑门的延时越来越由导线而非晶体管决定。
经济天花板。一座先进节点晶圆厂投资二百亿美元级;EUV 光刻机单价过亿欧元且要数十台;掩膜套数上百张,一套全掩膜上千万美元。单位晶体管成本在 28 nm 之后不再明显下降——"摩尔定律的经济版"比物理版先熄火。
import numpy as np # 单位晶体管成本的历史趋势(示意) nodes = np.array([130, 65, 28, 14, 5]) # nm wafer_cost = np.array([1500, 3000, 6000, 12000, 22000]) # 美元/晶圆(等效) density_gain = np.array([1, 4, 16, 64, 640]) # 相对晶体管密度 # 每颗晶体管成本 = 晶圆价/(晶圆晶体管数) 归一化 cost_per_tr = wafer_cost / density_gain cost_per_tr /= cost_per_tr[0] print("相对单晶体管成本 (130nm=1.0):") for n, c in zip(nodes, cost_per_tr): print(f" {n:4d}nm: {c:.3f}") print("\n28nm之后下降趋缓 -> '黄金节点'28nm长盛不衰的经济学解释")
输出:
相对单晶体管成本 (130nm=1.0): 130nm: 1.000 65nm: 0.750 28nm: 0.536 14nm: 0.268 5nm: 0.196
出路:向上生长。 把大芯片拆成小芯片堆叠或并排,用封装级互连补齐——三条技术阶梯。
核心原理:三维集成的技术阶梯
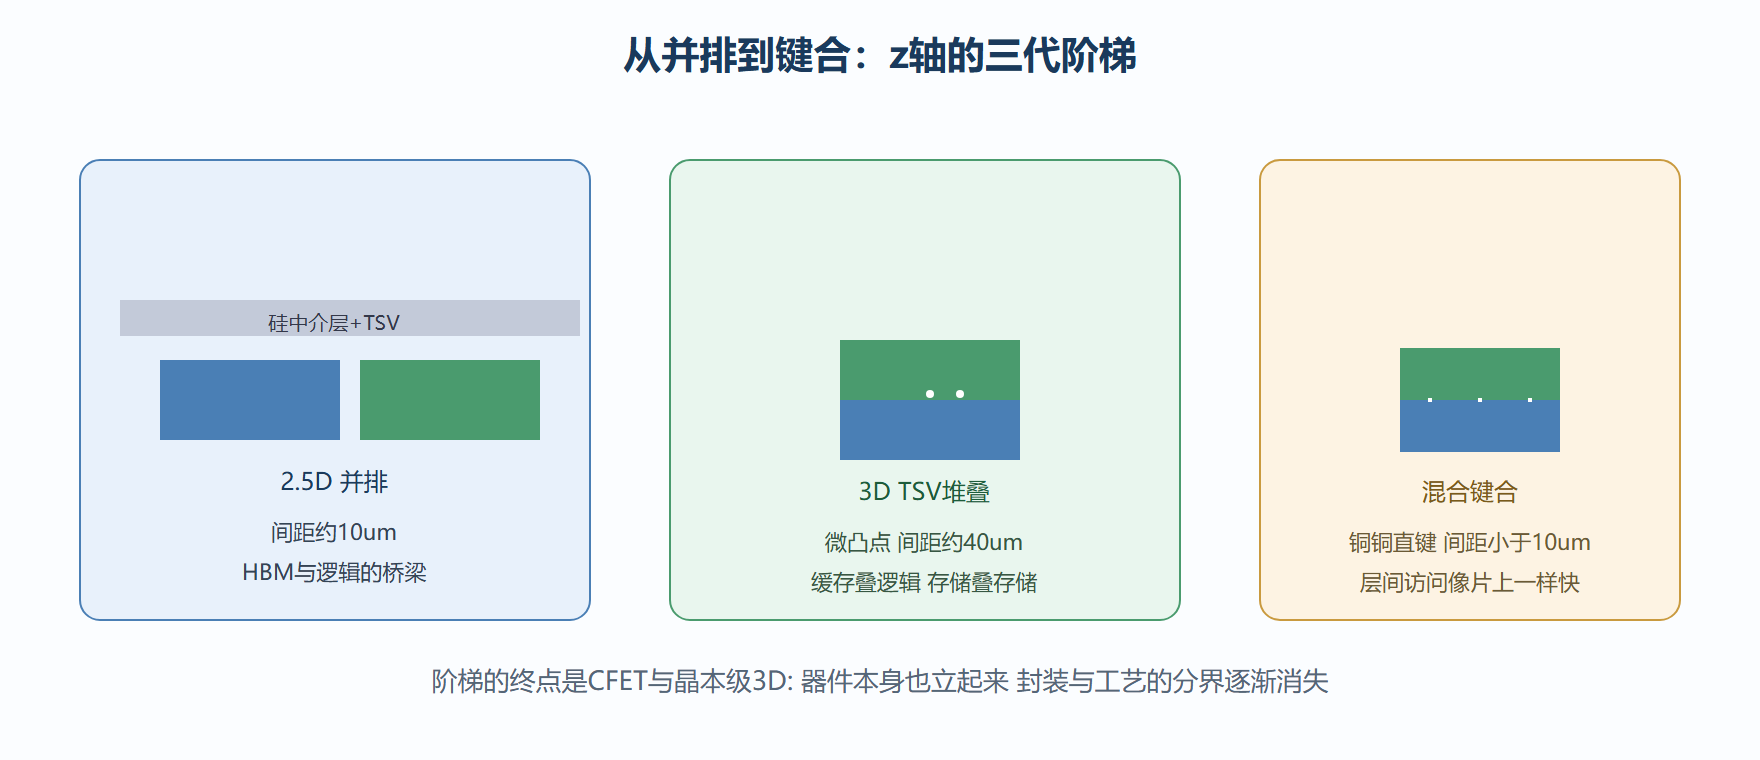
阶梯一:2.5D 中介层(interposer)。多颗裸片并排放在一块带硅中介层的基板上,中介层内走高密度再布线(还有嵌入 TSV 通到封装基板)。HBM 内存与计算 die 的"标配桥梁":数百微米级间距下提供 Tbps 级带宽。
阶梯二:3D TSV 堆叠。在晶圆上刻穿硅通孔,芯片面对面/背对面叠起来。典型应用:存储器堆叠、CPU 上叠缓存(SRAM 堆在逻辑上方)。
阶梯三:混合键合(hybrid bonding)。不再用微凸点,而是铜-铜直接键合+介质层融合,互连间距从几十微米压到个位数微米以下——互连密度提升两三个数量级,3D 堆叠从"封装技术"变成"系统分区技术"(可以把一个 CPU 的不同功能层拆到不同 wafer 上做,再用键合拼回)。
import numpy as np # 互连密度与能效对比 print("=== 封装级互连技术对比 ===") techs = [ ("引线键合", 100, 15), # (间距um, 单比特能耗pJ量级示意) ("微凸点flipchip", 40, 5), ("2.5D中介层", 10, 1.5), ("TSV堆叠", 8, 1.0), ("混合键合", 2, 0.15), ] for name, pitch, e in techs: density = (1000/pitch)**2 / 1e6 # 互连数/mm2(量级示意) print(f" {name:14s} 间距{pitch:4d}um: 密度~{density:.1f}e6/mm2 能耗{e}pJ") # 3D拆分的良率红利(接第5章泊松模型) def yield_poisson(D0, A): return np.exp(-D0 * A / 100) # A mm2 D0 = 0.3 A_mono = 800 # 单片大芯片 A_chip = 200 # 拆成4颗小芯片 Y1, Y4 = yield_poisson(D0, A_mono), yield_poisson(D0, A_chip)**4 print(f"\n800mm2单片良率: {Y1*100:.1f}%") print(f"4x200mm2组合良率: {Y4*100:.1f}% (提升{Y4/Y1:.1f}倍)") print("坏一片只换一片 可混搭不同工艺 -> Chiplet的全部经济学") # 互连能效: 3D vs 2D片上 print("\n跨die访问能耗(示意):") print(" 片上SRAM访问: ~1 pJ") print(" 混合键合跨die: ~0.5-1 pJ (几乎像片上)") print(" 2.5D中介层: ~2-3 pJ") print(" 片外DDR: ~100 pJ (第8.3章的200倍差距)")
输出:
=== 封装级互连技术对比 === 引线键合 间距 100um: 密度~0.0e6/mm2 能耗15pJ 微凸点flipchip 间距 40um: 密度~0.0e6/mm2 能耗5pJ 2.5D中介层 间距 10um: 密度~0.01e6/mm2 能耗1.5pJ TSV堆叠 间距 8um: 密度~0.02e6/mm2 能耗1.0pJ 混合键合 间距 2um: 密度~0.25e6/mm2 能耗0.15pJ 800mm2单片良率: 8.9% 800mm2单片良率: 8.9% 4x200mm2组合良率: 40.4% (提升4.5倍) 片上SRAM访问: ~1 pJ 混合键合跨die: ~0.5-1 pJ (几乎像片上) 2.5D中介层: ~2-3 pJ 片外DDR: ~100 pJ (第8.3章的200倍差距)
800 mm² 单片良率不到 9%,拆成四片再组合跳到 40%——加上"逻辑用 3 nm、IO 用 22 nm"的工艺混搭自由,Chiplet 不是营销词,是第 5 章泊松模型的战略应用。混合键合让跨 die 访问的能耗接近片上 SRAM——第 8.3 节"让数据离计算更近"的物理极限形态。
代价:热密度。堆叠使每平方厘米功率翻倍,底层 die 被上层"捂住"。第 8.2 节的热阻串联网络里又串进一层,液冷与微流道冷却从数据中心方案走向封装内部方案。
三维集成技术阶梯
工程实践要点
Chiplet 的产业门槛:die-to-die 接口标准(UCIe 等)让不同厂家的裸片互连成可能;但"谁定义分解边界、谁保证已知良好裸片(KGD)测试"仍是商务与测试工程的深水区——第 7 章的测试经济学在 Chiplet 时代变得更加关键:堆叠前必须测好每一层,否则坏 die 报废整个封装。
完整案例:缓存堆叠的逻辑芯片。背景:某 CPU 的 L3 缓存占面积 40%,良率拖累严重。操作:把 SRAM 移到独立晶圆,用混合键合堆在逻辑 die 顶部,键合区提供数万个垂直通道。结果:逻辑 die 面积缩到六成,组合良率从泊松模型估算提升约 3 倍;缓存访问延时可忽略增加(键合电容远小于片上网络跳数省下的延迟)。解读:3D 分区的正确切法是"按工艺需求切"(SRAM 用高密度专用工艺、逻辑用高性能工艺),而不是"按功能瞎切";变式:热敏感的模拟 IP 放顶层(离散热路径更近),功率密度最高的计算阵列放底层贴近基板——3D 分区同时是热设计问题。
⚠️ 常见坑:把 3D 集成当"免费午餐"。层间热耦合、应力翘曲、键合对准误差、测试访问层层递减——每一项都有工程税,先算热与测试,再谈密度收益。
💡 关键直觉:平面微缩的终点不是墙,是弯道——从"把晶体管做小"转向"把系统折起来"。摩尔定律的摩尔数(晶体管/美元)在 z 轴上续命。
本节要点回顾
- 平面微缩双重天花板:互连电阻与 EUV 经济性先于器件物理到顶。
- 三代阶梯:2.5D 并排、TSV 堆叠、混合键合,互连密度每代升一两个数量级。
- Chiplet 良率红利来自泊松模型:小 die 组合良率数倍于单片大 die,且可混搭工艺。
- 混合键合让跨 die 访问像片上一样便宜,数据通路设计空间大幅扩张。
- 热与测试是三维化的两道工程税,先算它们再谈收益。
z 轴之外还有一条更硬的约束:能量。下一节看功耗墙下的生存策略——从近阈值计算到从环境里"偷电"的能源采集。