1.2 RAG 范式与 LlamaIndex 的定位
1.2 RAG 范式与 LlamaIndex 的定位
本节摘要:RAG(检索增强生成)= 先检索后生成:把用户问题匹配到相关知识片段,塞进提示词再让模型作答。本节讲清 RAG 的因果起源、最小闭环里每个环节的职责与失败模式,并把 LlamaIndex 放进"模型层 / 编排层 / 存储层"三层版图中,明确它住在编排层、向下兼容各家存储、向上服务各类应用。
为什么会有 RAG
大模型的参数化知识有三个先天缺陷:训练截止后世界继续变化;私有数据(合同、内部 wiki、客户工单)永远不在训练集里;且它按概率生成,缺证据时倾向编。补知识有三条路线——加长上下文、微调、检索增强。加长上下文贵且慢,而且长上下文里模型对中段信息利用率明显下降;微调不擅长记忆事实细节,知识更新还要重训;只有 RAG 把"知识"外置成可随时增删的库,模型每次答题前先"查资料"。因果链就是:知识时效与私有性矛盾 → 知识必须外置 → 外置就必须检索 → 检索结果必须注入生成。四步连起来就是 RAG。
最小闭环与各环节的失败模式
一个最小 RAG 闭环分五站:加载 → 分块 → 嵌入与索引 → 检索 → 合成。每一站都有典型的塌方方式:加载站丢元数据(找不到出处)、分块站斩断语义(表格被腰斩)、索引站选错嵌入模型(中文query配英文模型)、检索站只做向量召回(精确术语匹配不上)、合成站上下文堆太多(模型开始和稀泥)。后面各章就是对这五站逐一开膛。
# 用最朴素的代码手搓一个"裸 RAG",理解框架出现前的世界 import openai, numpy as np chunks = [ "退货政策:自签收日起 7 天内可无理由退货,30 天内可质量问题退货。", "配送范围:全国除港澳台外均可达,偏远地区加收 10 元运费。", "会员等级:累计消费满 1000 元升级金卡,享受 95 折优惠。", ] # 嵌入并索引(裸写法:自己管向量、自己算相似度) resp = openai.embeddings.create(model="text-embedding-3-small", input=chunks + ["退货最长能拖多久?"]) vecs = np.array([d.embedding for d in resp.data]) query_vec = vecs[-1] sims = vecs[:-3] @ query_vec # 余弦相似度(未归一化时只是近似) top = int(np.argmax(sims)) # 合成:把最像的片段塞进提示词 answer = openai.chat.completions.create( model="gpt-4o-mini", messages=[{"role": "user", "content": f"仅依据以下材料回答:\n{chunks[top]}\n问题:退货最长能拖多久?"}], ) print(answer.choices[0].message.content)
这段代码能跑,但脆:三篇文档时没问题,三千篇时你要处理分块、增量更新、混合检索、重排、引用标注——每一项都是新工程。框架的存在意义就是把"能跑的演示"和"能上线的系统"之间的鸿沟填平。
三层版图里的位置
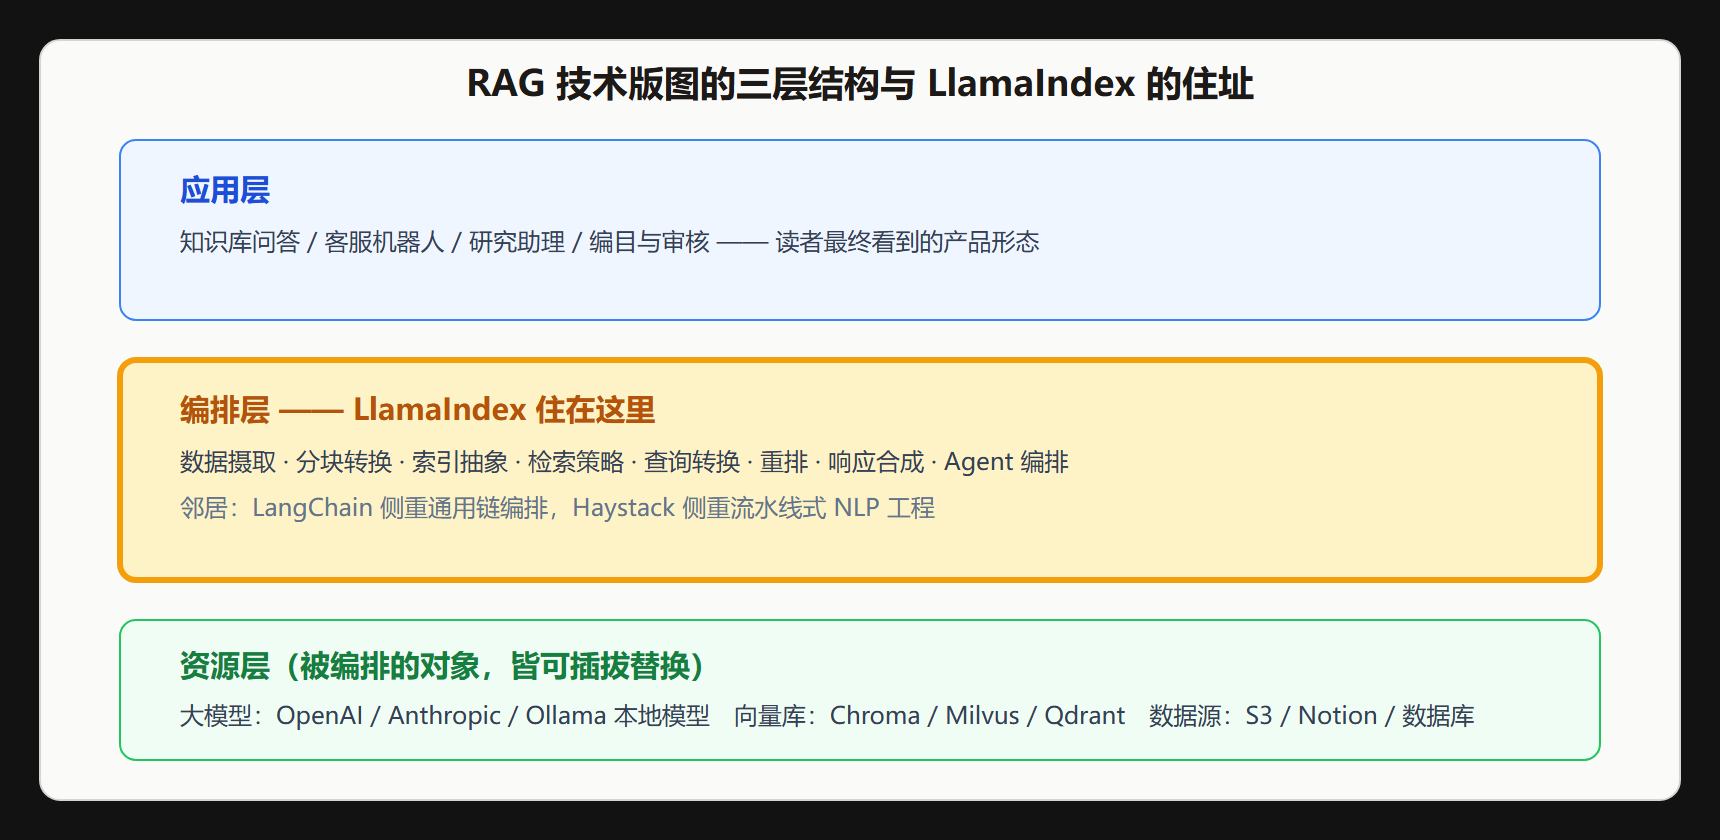
这张图也回答了一个高频选型困惑:"我用 Milvus 了还要 LlamaIndex 吗?"要。向量库只解决"存向量、算相似度",它不负责文档怎么读、怎么切、查询怎么改写、多段材料怎么合成。反过来"我用了 LlamaIndex 还要向量库吗?"看规模——数据量小可以先用框架内置的默认存储,规模上来再外接。
本节要点回顾
- RAG 因果链:知识时效与私有性矛盾 → 知识外置 → 必须检索 → 检索注入生成。
- 五站闭环:加载、分块、嵌入索引、检索、合成,各站有各自典型失败模式,是后续各章的目录。
- 框架的填沟角色:把"能跑的演示"升级为"能上线的系统",覆盖增量更新、混合检索、引用标注等工程需求。
- 三层版图:LlamaIndex 住编排层,与通用编排框架、专用检索框架互为邻居,资源层全部可插拔。
- 选型速答:向量库不替代框架,框架小规模时也可暂不需要向量库。
深入一步:RAG 与微调的配合
三条补知识路线不是单选题。成熟的落地系统常常是"RAG 打底、微调补风格":事实类知识(制度条款、产品参数)全部走 RAG,保证可更新可溯源;而回答风格、领域话术、固定格式输出这类"行为模式"用少量数据微调小模型获得。把事实塞进微调是最常见的反模式——知识更新一次就要重训一次,而且模型记不准还会编。
另一个值得建立的认知:RAG 的每个环节都可能成为新的优化点,这也是这个领域论文与工具爆发的原因。切块策略、查询改写、重排模型、上下文压缩,每一站都有专门的研究方向。本册不追新,只把每一站的原理与调优杠杆讲透——新方法层出不穷,但它们都挂在这条不变的链路上。
一个自测问题:如果你的系统"答案总是对但慢",该优化链路哪一段?如果"快但经常答错"呢?前者看合成与缓存(第 4、6 章),后者先看摄取与检索(第 2、3、4 章)——能用这个问题做初步归因,说明 RAG 的链路思维已经建立。
另一个高频疑问是:检索错了怎么办?这正是 RAG 工程化的核心焦虑,也是本册后半部分的主题。答案分两层:机制层靠"引用可溯源"——每个回答标注出处,用户能自行核实;工程层靠评估与观测——第 5.4 节的评估集让召回质量可量化,第 4 章的各种检索手段让质量可干预。RAG 不是一次性搭好的静态系统,而是持续演进的数据资产,这个认知差异往往决定项目的成败。
最后给一个阅读建议:不要试图一次记住五站闭环的所有细节。记住"加载、切分、索引、检索、合成"五个词与它们的大致职责即可,后面每章展开一站时回来对照,结构感会随章节推进自然生长。
给这一节做个收束:RAG 不是一个框架功能,而是一种系统结构——知识外置、按需检索、注入生成。LlamaIndex 是这种结构的一种成熟工程化,理解了结构的因果,框架的每个组件都有了存在的理由;反过来,只会调框架接口而不懂结构的人,遇到问题的第一反应只能是搜索报错信息。前者才是本册想培养的读者。