- 文集信息
- 目录大纲
- 最新文档
- 知识宇宙
文集详情
文集导读
LlamaIndex 教程导读:把一条检索链路放上解剖台
本册主题:LlamaIndex 是一个用于构建上下文增强大模型应用的数据框架,覆盖数据摄取、索引构建、查询检索、响应合成到智能体编排的完整链路。本教程以"检索链路解剖工坊"为方法——每章拆开链路的一段,看清楚内部机制、量测它的效果、动手替换其中的零件——带你从第一次安装走到生产部署。
想象你刚接手一个客服知识库项目:三千篇产品文档躺在共享盘里,老板要求两周内做出一个"问不倒"的问答机器人。你面对的不是缺模型——大模型 API 随处可调——而是缺一条把私有知识稳妥送进模型上下文的流水线。文档怎么读进来?长文怎么切?切成什么粒度?切完存哪?用户提问来了怎么召回?召回十段碎片怎么合成一个不胡说的回答?这条链上任何一环掉链子,用户看到的就是"一本正经地答非所问"。
LlamaIndex 把这条链路做成了可插拔的工程体系。本册不满足于"跑通官方五分钟示例",而是像工坊拆解一台发动机那样,把每一站都打开看看:数据从 Reader 进厂成为 Document,经 Transformer 切成 Node,由 Embedding 模型压成向量存进 Vector Store;查询侧则经过查询转换、Retriever 召回、Node Postprocessor 重排,最后由 Response Synthesizer 交给大模型合成答案。每一站都能量测、能换件、能调参。
全册知识地图
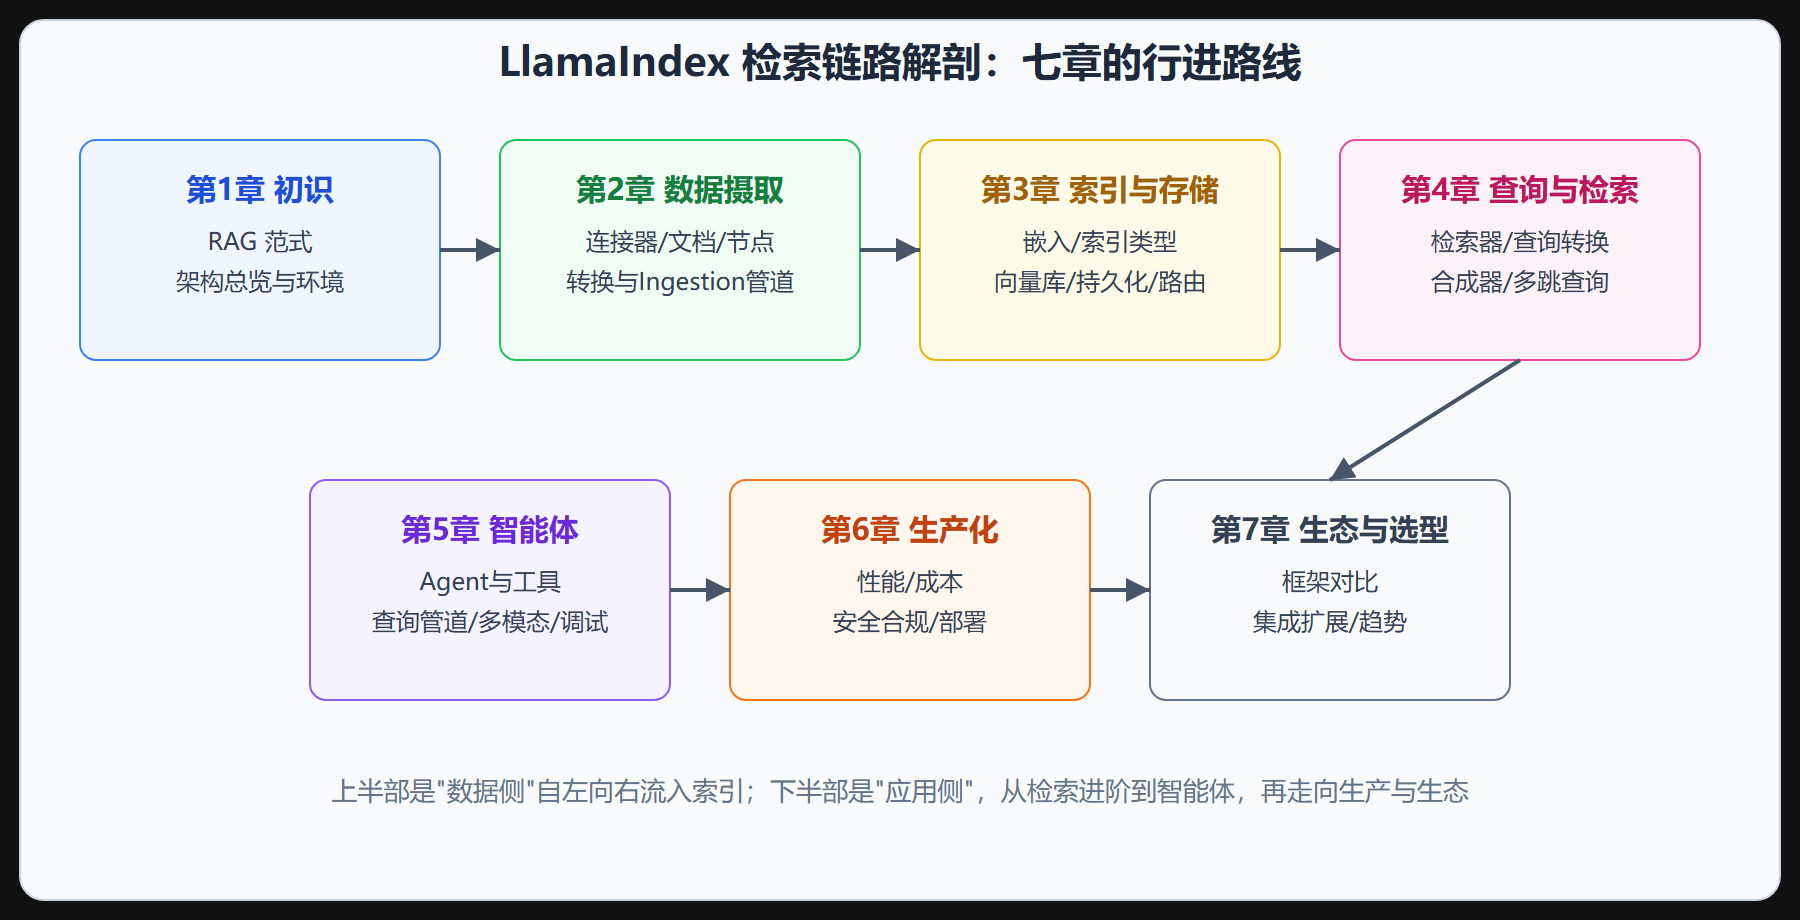
各章分工一句话
第 1 章回答"它是什么、为什么是它";第 2、3 章是数据侧,负责"知识怎么进厂、怎么入库";第 4 章是查询侧,负责"问题怎么变成答案";第 5 章把静态链路升级为会调用工具的智能体;第 6 章解决上线后的性能、成本与合规;第 7 章拉远镜头看生态与选型。行业里常见的故事——法律检索、企业知识库、多模态图书编目——将作为案例散布在各章,而不是单独成章。
适合谁读
你需要会用 Python、调过大模型 API,对向量检索有概念即可。每节都有可运行代码(依赖用一行命令安装 LlamaIndex 主包与对应集成包),建议边读边在自己的机器上拆装。全册遵循同一条主线:先看现象,再拆机构,最后换零件验证——这也是"解剖工坊"四个字的含义。
常见问题
零基础能直接读这本书吗? 需要 Python 基础与一次调用大模型 API 的经验,向量检索不要求先修——第 3 章会从"语义距离"的实验讲起。如果连虚拟环境都不熟,建议先花一小时补 Python 工程基础再回来,否则第 1.5 节的排错环节会卡住你。
必须用 OpenAI 的模型吗? 不必。全书代码同时给出本地模型(Ollama 加开源模型)与 OpenAI 兼容接口两种写法,国内模型服务走兼容层即可。唯一要记住的是嵌入模型与生成模型可以分开选、分开换,但换嵌入模型必须重建索引。
学完需要多久? 七章按"每周一章"的节奏大约七周;动手能力强、有 RAG 基础的读者可以挑第 2、3、4、6 章精读,第 1 章快速略过。每章末的要点回顾可以作为自测清单。
为什么叫"解剖工坊"而不是"实战指南"? 因为本书的方法论是拆解:每一段链路都先看现象、再拆机构、最后换零件验证。实战指南教你照做,解剖工坊教你看懂——框架每年都在变,看懂结构的人永远能快速上手新版本。
目录大纲
最新文档
知识宇宙
正在加载知识图谱...