1.4 LlamaIndex 的基本架构与工作流
1.4 LlamaIndex 的基本架构与工作流
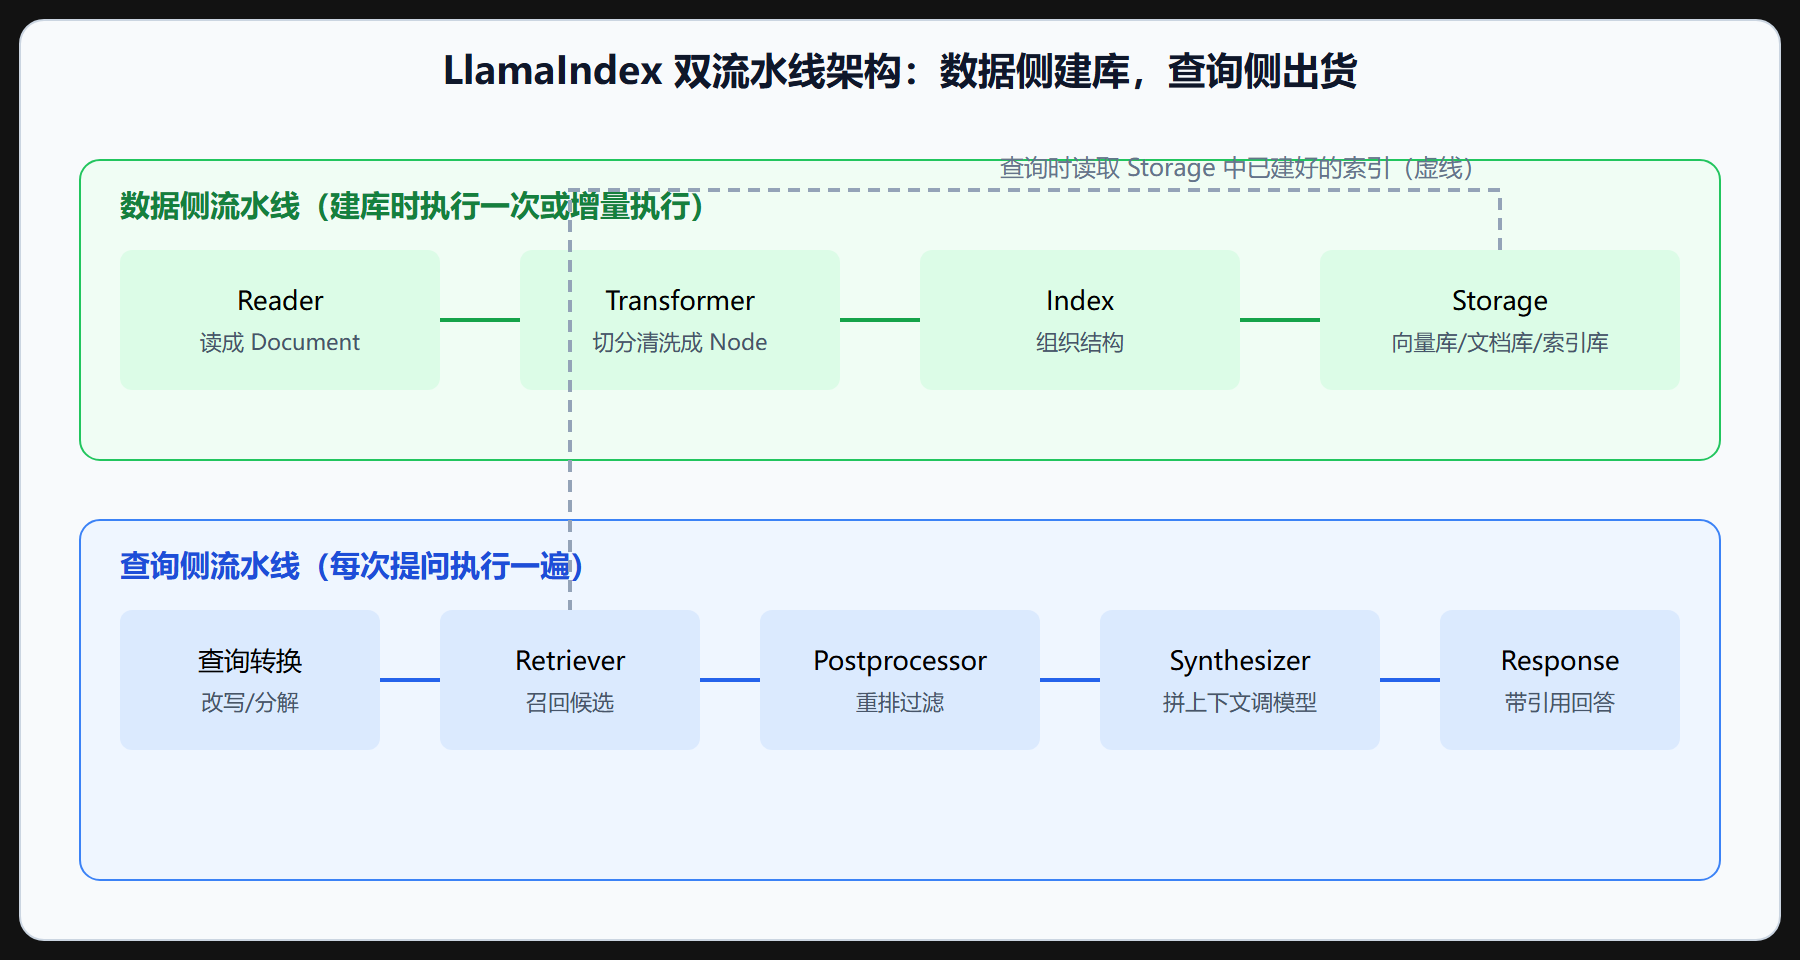
本节摘要:LlamaIndex 内部由两条流水线组成——建库时的"数据侧流水线"(Reader → Transformer → Index → Storage)与问答时的"查询侧流水线"(Query → 转换 → Retriever → Postprocessor → Synthesizer)。本节画出这两条流水线的全景,并用
verbose输出与回调钩子实际观察一次查询在内部的行进路线。
两条流水线,一个仓库
把框架想象成一座工厂:白天进料(数据侧),随时出货(查询侧),中间是仓库(索引与存储)。数据侧流水线四站:Reader 把异构源读成 Document;Transformer 做清洗、切分、元数据抽取,产出 Node;Index 决定 Node 的组织结构(向量、树、图);Storage 负责落盘(向量库、文档库、索引结构库三个默认部分)。查询侧五站:Query 进入后先可做转换(改写、分解、HyDE);Retriever 召回候选 Node;NodePostprocessor 做重排、过滤、去重;ResponseSynthesizer 拼装上下文并调用大模型;最后返回带引用的 Response。
用回调系统实际观察一次查询
架构图要落地成"看得见的执行轨迹"。LlamaIndex 的回调系统(callbacks)可以在每站打点:
import llama_index.core from llama_index.core import Settings from llama_index.core.callbacks import CallbackManager, LlamaDebugHandler # 挂一个调试处理器,观察查询在流水线里的行进 handler = LlamaDebugHandler(print_trace_on_end=True) Settings.callback_manager = CallbackManager([handler]) engine = index.as_query_engine() resp = engine.query("试用期是多长?") # 事件流里能看到:检索执行了几次、模型调用了几次、耗时多少 for event in handler.get_event_pairs(): print(type(event[0]).__name__, getattr(event[0], "payload", {}).get("name", ""))
典型输出里会出现 Retrieval 事件与 LLM 事件各一次——说明默认查询引擎走的是"检索一次、生成一次"的直通模式。当你后面看到输出里出现多个 Retrieval(比如多跳查询)或多次 LLM 调用(查询改写),就能立刻反推出该模式的内部行为。这种"从执行轨迹反推架构"的习惯,是解剖框架最趁手的手术刀。
分层架构的替换点
两条流水线的每个方框在代码里都对应一个可替换的组件槽位。默认实现之外,你可以替换:嵌入模型(Settings.embed_model)、大模型(Settings.llm)、分块器(Settings.text_splitter)、存储后端(StorageContext)、检索器(as_retriever 的参数或自定义类)、合成模式(response_mode)。替换不需要继承框架内部类,多数场景传参即可。
# 全局设置层:一处替换,全链路生效 from llama_index.core.node_parser import SentenceSplitter from llama_index.embeddings.huggingface import HuggingFaceEmbedding Settings.llm = llm_local # 换本地模型,省 API 成本 Settings.embed_model = HuggingFaceEmbedding( # 换中文嵌入模型 model_name="BAAI/bge-small-zh-v1.5") Settings.text_splitter = SentenceSplitter( # 换分块参数 chunk_size=512, chunk_overlap=64) Settings.context_window = 8192 # 告诉框架模型的窗口上限
本节要点回顾
- 双流水线心智模型:数据侧(Reader→Transformer→Index→Storage)建库,查询侧(转换→检索→后处理→合成)出货,仓库居中。
- 回调打点:LlamaDebugHandler 能把执行轨迹打印出来,从轨迹反推模式行为是调试核心技巧。
- 默认直通模式:一次检索 + 一次生成;轨迹里事件数量一变,说明走了进阶模式。
- 组件槽位:模型、分块器、存储、检索器、合成模式全是参数级可替换件,第 3、4 章逐一上手。
- Settings 全局层:全局默认一处替换全链生效,也可在单个组件上局部覆盖。
常见问题
Settings 全局设置和逐组件传参,哪个优先? 局部传参覆盖全局设置。生产上常见的组织方式是:Settings 放"全系统默认"(模型、嵌入、分块器),个别环节按需局部覆盖(某个索引用不同的 top_k)。这样一处改动全链生效,特殊需求又不被绑死。
回调系统会影响性能吗? 打点本身开销很小,但 print_trace_on_end=True 这类详细输出在生产上应关闭,只保留事件上报到观测服务。调试期开详细打印,上线换静默上报——回调管理器的用法可以运行时切换,不用改业务代码。
数据侧流水线和查询侧流水线,哪边更值得投入优化时间? 经验上是数据侧。摄取质量决定上限,查询侧的任何优化都是在既有上限内逼近它。一个切坏了的语料库,检索器调出花来也补不回丢失的信息单元。这也是本册第 2 章篇幅厚重的原因。