2.1 数据源连接器与集成
2.1 数据源连接器与集成
本节摘要:连接器(Reader)负责把异构数据源统一读成 Document 列表。本节盘点 Reader 生态的分类地图,实战文件目录读取、数据库读取与网页读取三种最高频场景,并给出"官方连接器、社区连接器、自己写"三条路线的选择标准。
生态地图:先看清货架再挑货
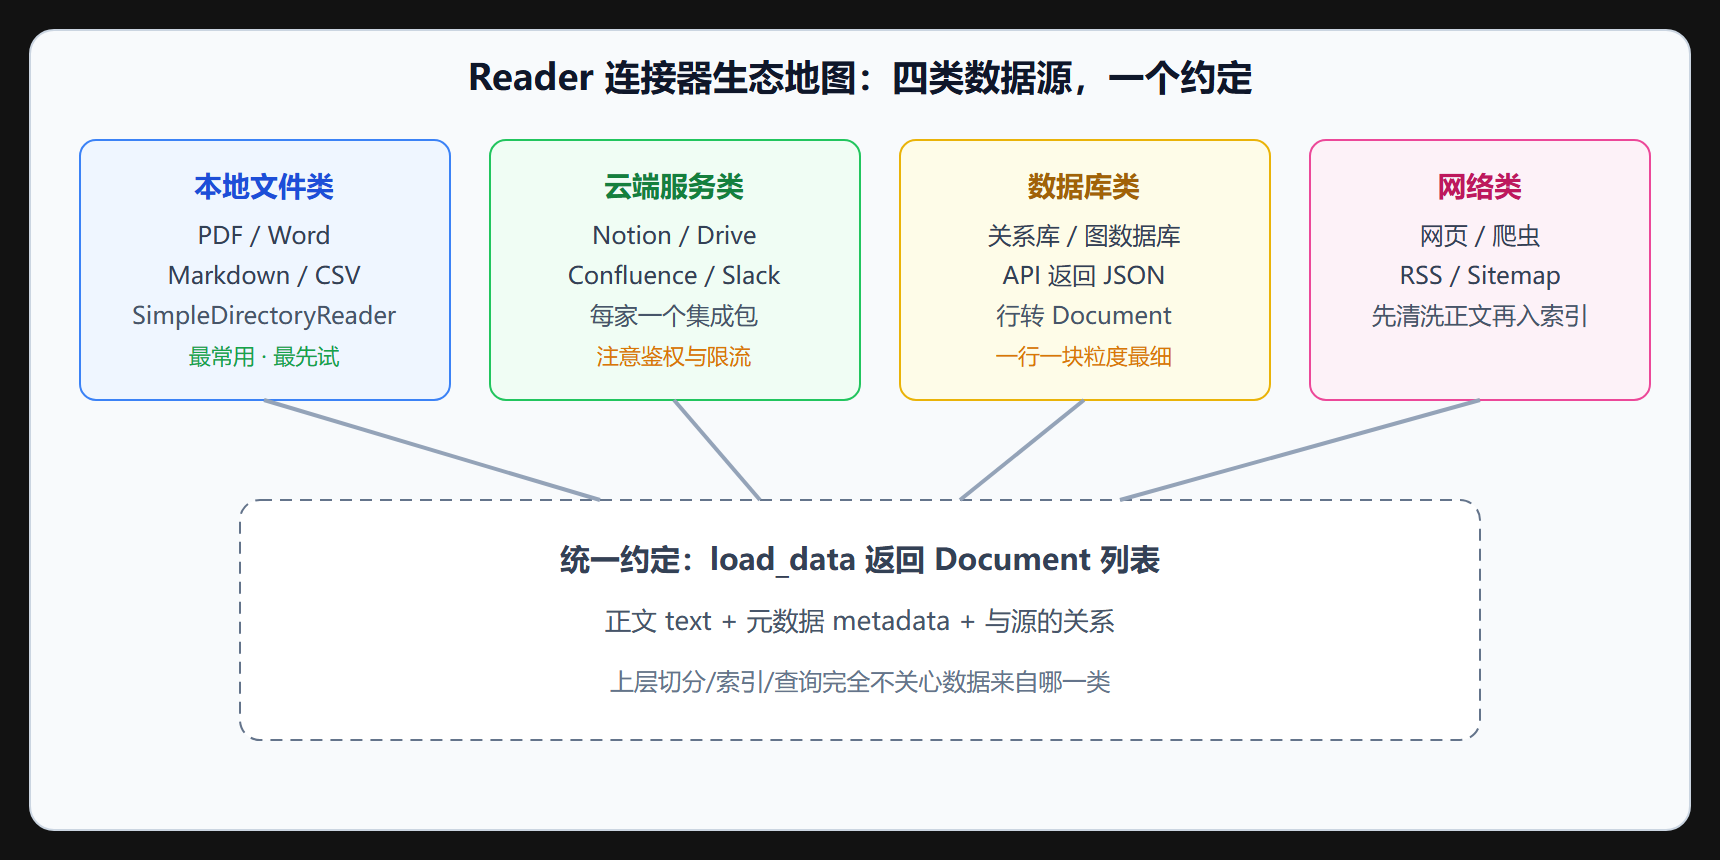
LlamaIndex 的 Reader 生态按数据形态分四类:本地文件类(PDF、Word、Markdown、CSV,统一在文件读取集成包里);云端服务类(Notion、Google Drive、Confluence、Slack 等,每家一个包);数据库与结构化类(关系数据库、图数据库、API 返回的 JSON);网络类(网页爬取、RSS、Sitemap)。所有连接器遵守同一约定——实现 load_data() 返回 List[Document]。这个约定就是生态的全部魔法:上层的切分、索引、查询完全不关心数据从哪来。
三种最高频场景实战
场景一:本地目录。SimpleDirectoryReader 会按扩展名自动挑解析器,还支持按文件过滤与多目录。
from llama_index.core import SimpleDirectoryReader # 只要 pdf 与 md,且要求每个文件至少 200 字符才收录 reader = SimpleDirectoryReader( input_dir="./knowledge", required_exts=[".pdf", ".md"], exclude_hidden=True, filename_as_id=True, # 文件名作为稳定 id,增量更新时靠它判重 recursive=True, # 递归子目录 ) docs = reader.load_data(show_progress=True) print(len(docs), "篇文档") print(docs[0].metadata) # 看看自动提取了哪些元数据
filename_as_id 是个值得养成的习惯:它让"同一文件重复摄取"在管道缓存(2.4 节)里有稳定键,避免重复嵌入的冤枉钱。
场景二:数据库。把每行变成一个 Document,元数据带上主键,检索时能精确回指:
# 自定义数据库读取:保持对 SQL 的完全控制 import sqlite3 def load_tickets(db_path): conn = sqlite3.connect(db_path) rows = conn.execute("SELECT id, title, body, status FROM tickets").fetchall() from llama_index.core import Document return [ Document( text=f"工单标题:{t}\n内容:{b}", metadata={"ticket_id": i, "status": s, "category": "customer_support"}, excluded_llm_metadata_keys=[], # 元数据也参与提示词 ) for i, t, b, s in rows ] docs = load_tickets("tickets.db")
场景三:网页。读取时务必做正文清洗,导航栏、页脚这类"全站相同"的内容进入索引后会在无数查询中被召回,是典型的噪音源。
from llama_index.readers.web import SimpleWebPageReader docs = SimpleWebPageReader(html_to_text=True).load_data(["https://example.com/policy"]) raw = docs[0].text # 先看一眼再决定怎么清洗:截掉页脚重复段、去掉冗长免责声明 print(raw[:300])
三条路线怎么选
我的标准很简单:官方维护的用官方(文件、Notion、Drive 这类高频源 bug 修得快);社区包先小规模试(拿 5% 的数据验证解析质量,尤其是 PDF 类);长尾源直接自己写——一个返回 Document 列表的函数就是合法连接器,往往比修社区包的坑更快(2.4 节给完整模板)。判断口诀:数据越核心,越要自己掌控读取层。
本节要点回顾
- 一个约定撑起生态:所有 Reader 都是
load_data() → List[Document],上层完全解耦。 - 四类货架:本地文件、云端服务、数据库、网络,各有典型坑(扫描 PDF、限流、粒度、噪音)。
- 稳定 id:
filename_as_id与主键元数据让增量更新与出处回指成为可能。 - 网页必清洗:全站重复内容是最隐蔽的索引噪音。
- 路线口诀:核心数据自己写读取层,高频源用官方包,社区包先小样验证。
常见问题
PDF 解析总出问题怎么办? PDF 是最难啃的格式,分三种情况处理:文字层完好的普通 PDF 用默认解析即可;扫描件没有文字层,先走 OCR 再入管道;表格密集的 PDF 换更强调版面理解的解析方案,或干脆人工导出成 Markdown。别指望一个连接器通吃所有 PDF——按文档类型分管道处理是常态。
连接器读进来的 Document 太脏,在哪一层清洗最合适? 尽量早:能在 Reader 里做清洗(自定义 load_data 后处理)就别拖到切分之后,因为脏内容一旦被切进节点,清理就要逐节点进行,还要处理切分边界上的残留。清洗函数放摄取管道第一站是成本最低的位置。
数据源每天更新,要定时全量重读吗? 千万不要。配合稳定 id 与 2.4 节的管道缓存,只读增量(按更新时间拉取变更),未变更的文档在缓存层直接跳过。全量重读不仅浪费嵌入费用,还会因为重新切分导致节点 id 变化,破坏增量更新的判重基础。
补充一个容易被忽略的工程点:连接器的"读取节奏"要与数据源的变更节奏对齐。共享盘文档按天同步、工单系统按小时拉增量、外部网页按周重抓——不同源配不同的调度周期,并且周期信息写进元数据,检索时"数据新鲜度"才有据可查。用户问"最新的制度"时,系统才能诚实回答自己最后一次同步是什么时候。