2.4 自定义数据源与 Ingestion 数据管道
2.4 自定义数据源与 Ingestion 数据管道
本节摘要:当现成连接器不够用时,自己写一个 Reader 只需实现
load_data返回 Document 列表;当摄取流程需要可重复、可增量、可缓存时,用 IngestionPipeline 把"读取→清洗→切分→抽取→入索引"装配成一条带缓存的流水线。本节给出两块完整模板,并把缓存省下的真金白银算给你看。
手写 Reader:二十行补齐长尾数据源
假设要接公司内部一个没有现成连接器的工单系统。合法连接器的全部要求就是"callable、返回 Document 列表":
from llama_index.core import Document import requests class TicketReader: """内部工单系统读取器:拉取指定时间段的工单并转成 Document""" def __init__(self, base_url, token): self.base_url, self.token = base_url, token def load_data(self, since="2024-01-01"): page, docs = 1, [] while True: resp = requests.get( f"{self.base_url}/tickets", params={"since": since, "page": page}, headers={"Authorization": f"Bearer {self.token}"}, timeout=30, ) batch = resp.json().get("items", []) if not batch: break for t in batch: docs.append(Document( text=f"标题:{t['title']}\n描述:{t['description']}\n处理记录:{t.get('log','')}", metadata={ "ticket_id": t["id"], "created_at": t["created_at"], "dept": t.get("dept", "unknown"), }, )) page += 1 return docs # 与任何官方 Reader 用法完全一致 docs = TicketReader("https://tickets.internal", token="xxx").load_data() print(len(docs), "张工单入厂")
写自己的 Reader 有个隐藏好处:分页、重试、字段映射这些脏活都在你代码里,出问题不用去啃社区包的实现。
IngestionPipeline:装配、缓存与增量
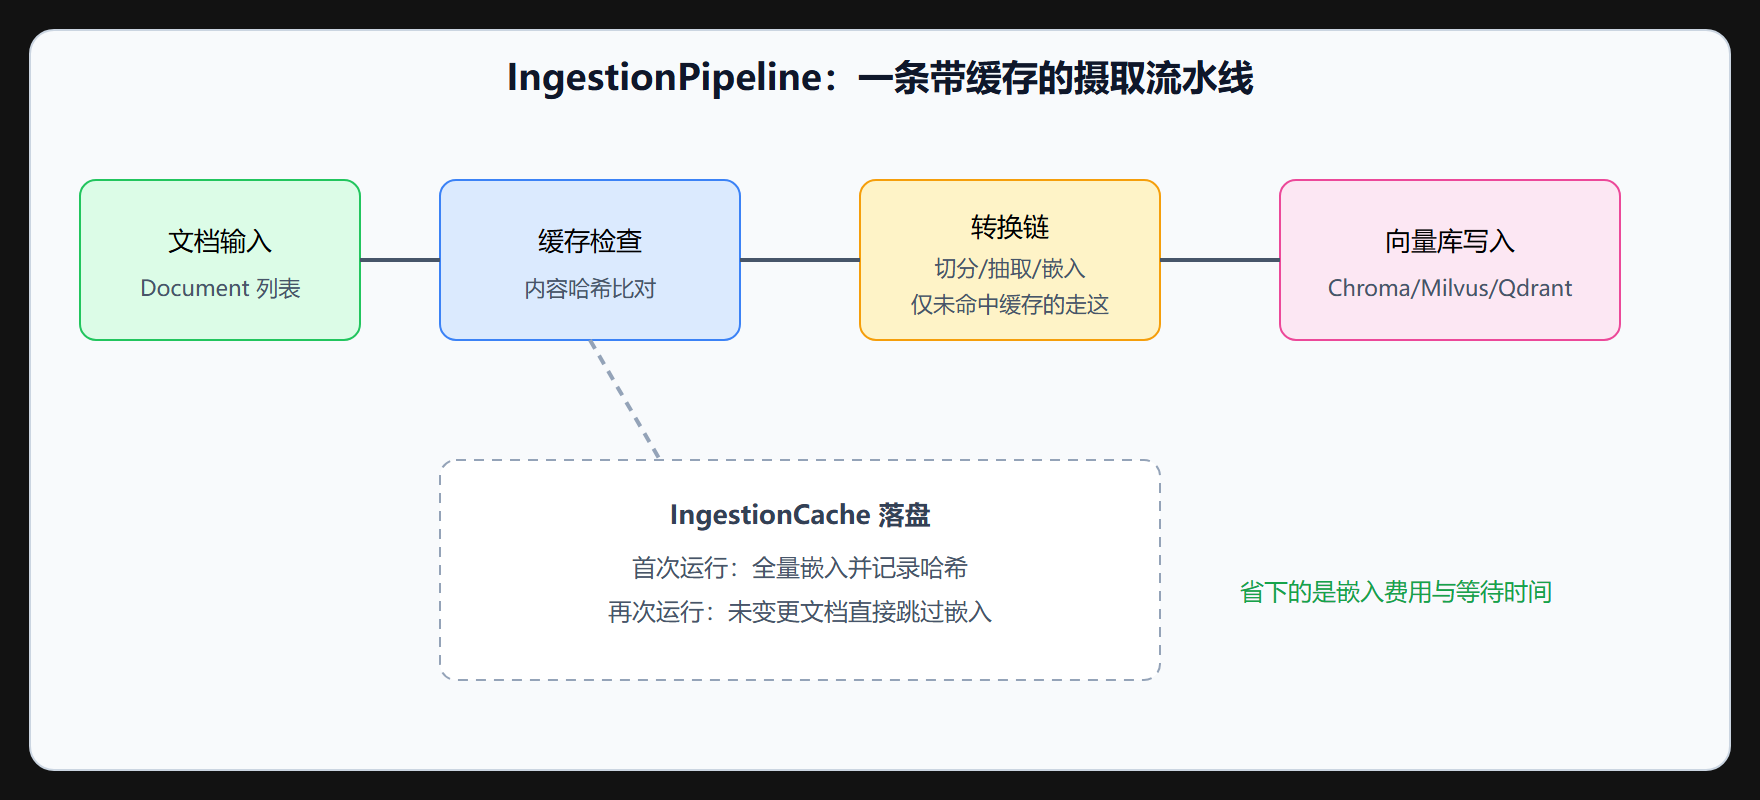
前面各节的操作(读、洗、切、抽)如果散落在脚本里,每次重跑都要对全量文档重新嵌入。IngestionPipeline 把它们串成一条链,并带两个生产级能力:缓存(对没变化的文档跳过嵌入,键是文档内容哈希)与增量(配合向量库的删除机制实现"改了才重做")。
from llama_index.core.ingestion import IngestionPipeline, IngestionCache from llama_index.core.node_parser import SentenceSplitter from llama_index.core.extractors import TitleExtractor from llama_index.vector_stores.chroma import ChromaVectorStore import chromadb db = chromadb.PersistentClient(path="./chroma_db") collection = db.get_or_create_collection("kb") vector_store = ChromaVectorStore(chroma_collection=collection) pipeline = IngestionPipeline( transformations=[ SentenceSplitter(chunk_size=512, chunk_overlap=64), TitleExtractor(nodes=5), Settings.embed_model, # 嵌入也作为流水线的一站 ], vector_store=vector_store, # 直接写入外接向量库 cache=IngestionCache(persist_path="./ingestion_cache"), # 缓存落盘 ) nodes = pipeline.run(documents=docs, show_progress=True) print(f"本次实际处理 {len(nodes)} 个节点")
第二次运行时,未修改的文档会命中缓存,跳过嵌入计算:
# 模拟增量:只改了 3 篇文档后重跑 nodes2 = pipeline.run(documents=docs_updated) # 输出节点数远小于全量 —— 嵌入调用只发生在新增/变更文档上
粗算一笔账:一万节点、按每百万 token 十几元的嵌入报价,全量重跑一次的成本与十分钟等待,在缓存加持下变成"只付变更部分"。对每周更新语料的知识库,一年省下的费用与时间都相当可观。
删除与更新的闭环
增量体系还缺一角:文档删了、改了,旧节点要从索引里清掉。稳定 id(2.1 节的 filename_as_id、工单的 ticket_id)在这里兑现价值——按 id 删除即可:
# 变更闭环:删除旧节点 → 重跑管道 pipeline.run(documents=[changed_doc], store_doc_override=True) # 或直接操作向量库按 metadata 删除 collection.delete(where={"ticket_id": "T-1024"})
本节要点回顾
- 自定义 Reader 模板:实现
load_data返回 Document 列表即合法连接器,分页重试自己掌控。 - 流水线装配:读取、清洗、切分、抽取、嵌入串成 IngestionPipeline,可重复、可测试。
- 缓存省钱:内容哈希做键,未变更文档跳过嵌入,增量更新的经济学基础。
- 稳定 id 闭环:插入靠缓存判重、删除靠 id 定位,增删改三态齐全才叫数据管道。
- 直写向量库:流水线可把处理结果直接写入外接向量库,第 3 章的存储话题由此接棒。
常见问题
管道跑一半失败了,会留下半成品数据吗? 会有这个风险,规避方式是"先收集后写入":转换链全部跑完、确认节点列表完整后再写入向量库;或者给每次运行打批次号,失败时按批次号清理。外接向量库大多没有事务,写入的原子性要靠管道设计自己保证。
缓存会不会占很大磁盘? 缓存键是文档内容哈希,值主要是嵌入结果,万级文档规模通常在百兆以内,相比重复嵌入的费用不值一提。真正要注意的是缓存失效逻辑:换嵌入模型后旧缓存全部作废,务必换缓存路径或清空,否则会把旧模型的向量喂给新索引。
多条数据源要共用一条管道吗? 转换逻辑相同就共用,参数差异(不同源的块大小)通过实例化多个管道解决。但缓存建议按源分开——不同源的更新节奏不同,混在一个缓存里排查问题很痛苦。