3.5 多索引组合与路由策略
3.5 多索引组合与路由策略
本节摘要:当知识库天然分成几个域(制度、工单、产品手册),或一个问题形态需要不同索引(精确条款 vs 全局总结)时,与其把所有东西塞进一个索引,不如建多个索引再加一个"分诊台"。本节实现两种路由:基于 LLM 意图判断的 RouterQueryEngine,以及基于元数据自动路由的 AutoMergingRetriever 思路,并讨论"何时该拆、何时不该拆"。
为什么一个索引不够
两种压力会推着你拆索引。第一种是数据域差异:工单是短口语化文本、制度是长正式条文、手册是图文混排——它们的最佳切分粒度与元数据结构不同,混在一个索引里意味着用一套参数伺候三种语料,互相妥协。第二种是问题形态差异:3.2 节已经证明"找条款"和"写总结"需要不同索引。拆开后要解决的新问题只有一个:问题来了先去哪个索引——这就是路由。
RouterQueryEngine:LLM 当分诊护士
from llama_index.core import VectorStoreIndex, SummaryIndex from llama_index.core.tools import QueryEngineTool, ToolMetadata from llama_index.core.query_engine import RouterQueryEngine from llama_index.core.selectors import LLMSingleSelector # 两个索引:同一批文档,两种组织方式 policy_vec = VectorStoreIndex.from_documents(policy_docs).as_query_engine( similarity_top_k=4) policy_sum = SummaryIndex.from_documents(policy_docs).as_query_engine( response_mode="tree_summarize") # 把两个引擎包装成"工具",描述写得越准,路由越准 tools = [ QueryEngineTool( query_engine=policy_vec, metadata=ToolMetadata( name="policy_lookup", description="回答关于具体制度条款的问题,如天数上限、审批流程", ), ), QueryEngineTool( query_engine=policy_sum, metadata=ToolMetadata( name="policy_summary", description="对制度文件做全局概括、总结或对比", ), ), ] router = RouterQueryEngine( selector=LLMSingleSelector.from_defaults(), query_engine_tools=tools, ) print(router.query("差旅报销的审批要经过哪些环节?")) # → 走 policy_lookup print(router.query("用三句话总结今年的制度变化")) # → 走 policy_summary
路由质量的隐藏变量是工具描述。把 description 写成"检索公司制度"这种模糊话,路由基本靠运气;写成上面那样的"适配问题示例",LLM 选择器的准确率会显著提升。这本质上是提示词工程,只是对象换成了索引。
多域路由与并行召回
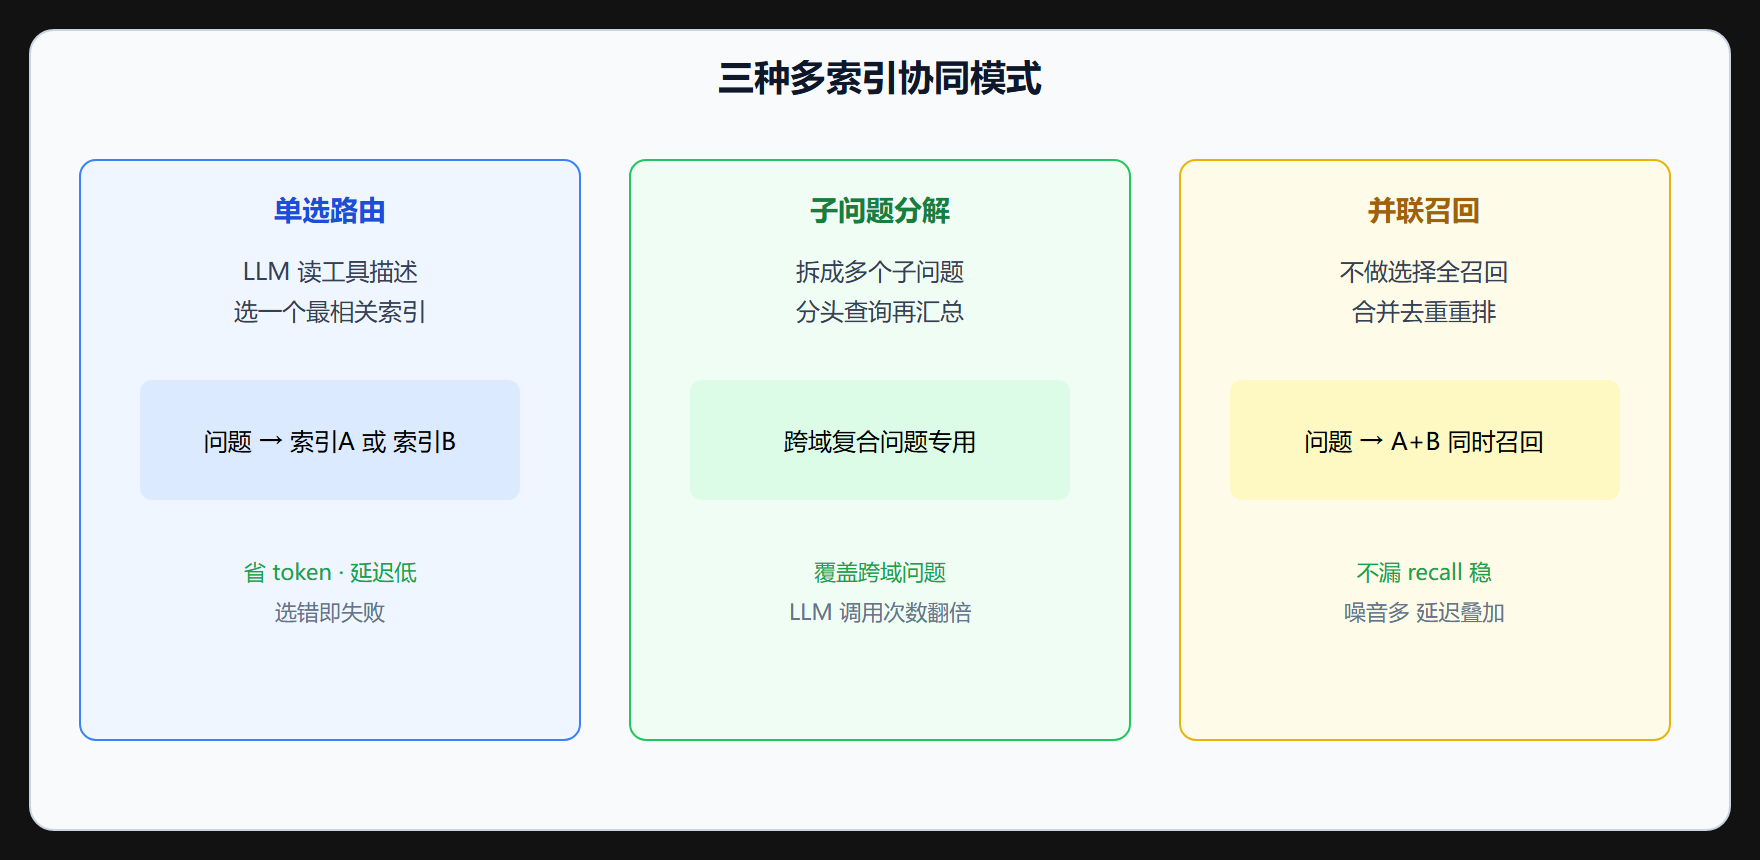
域拆分场景(制度库 / 工单库 / 手册库)同样用 Router 组合;但当问题可能跨域("华东区最近关于配送延迟的投诉有哪些,对应制度怎么规定的")时,串行选一个就不够了,两个进阶玩法:
# 玩法一:多选并行 —— 每个域各召回一部分,再合并给合成器 from llama_index.core.query_engine import SubQuestionQueryEngine sub_engine = SubQuestionQueryEngine.from_defaults(query_engine_tools=tools) # 它会把跨域问题拆成子问题分头查询,再汇总结答案(4.5 节详拆) # 玩法二:检索层并联 —— 不做选择,全召回再重排 from llama_index.core.retrievers import QueryFusionRetriever fusion = QueryFusionRetriever( [vec_index.as_retriever(similarity_top_k=4) for vec_index in indexes], similarity_top_k=6, num_queries=1, )
何时该拆、何时不该拆
拆的收益是参数对齐与权限边界清晰(不同域不同权限时几乎是刚需);代价是路由错误引入新的失败模式——分错了诊,后面的检索再好也白搭。我的判断线:域之间有权限差异或问题形态差异显著 → 拆;只是数据来源不同但查询方式一致 → 不拆,用元数据过滤解决(3.3 节)。后者用 filters 就能实现的"软分区",永远比物理拆分 + 路由便宜且不会选错。
本节要点回顾
- 两种拆分压力:语料域差异与问题形态差异;拆完要配路由。
- 描述即提示词:RouterQueryEngine 的路由质量取决于工具描述里的问题示例。
- 三种协同模式:单选路由省资源、子问题分解跨域强、并联召回稳但贵。
- 软分区优先:能靠元数据过滤解决的"分区"不要物理拆索引。
- 权限即硬边界:域间权限不同时物理拆分近乎必选。
常见问题
路由选错了怎么办? 三层防御:把工具描述写细(第一道);对高价值问题加"兜底路由"——不确定时同时查两个索引(并联模式);上线后统计路由准确率(5.4 节的观测数据),针对性改描述。路由错误率降到个位数百分比后,剩下的小概率错误用并联兜底比继续优化描述划算。
索引数量有没有上限? 物理上没有,但路由的准确率随候选数量下降,实践经验是单个 Router 管三到五个索引为宜。更多域就分层:第一层按大域路由,第二层域内再细分——像目录树一样组织路由。
多索引的权限怎么统一管理? 每个索引建库时就带权限元数据,查询侧的权限过滤(6.3 节)在路由之后、检索之前统一施加。千万别在每个索引的查询引擎里各配一套权限逻辑——分散的权限配置是越权事故的温床。