4.1 查询引擎的工作原理与自定义组装
4.1 查询引擎的工作原理与自定义组装
本节摘要:
as_query_engine()一行代码背后是一个四段装配:Retriever(召回)→ NodePostprocessor(重排过滤)→ ResponseSynthesizer(合成)→ 引用装配。本节把这四段拆开逐个替换,学会"不用 as_query_engine 也能手工组装引擎"的能力——这是后续所有进阶玩法(自定义重排、多引擎组合、管道编排)的地基。
as_query_engine 到底组装了什么
engine = index.as_query_engine( similarity_top_k=6, # 传给 Retriever node_postprocessors=[reranker], # 传给后处理链 response_mode="compact", # 传给 Synthesizer )
这一行等价于下面的手工装配。理解等价关系后,引擎就不再是一个黑盒开关组,而是一张可自由改装的电路图:
from llama_index.core.query_engine import RetrieverQueryEngine from llama_index.core.response_synthesizers import ResponseMode # 手工组装:每一站都可以换成自定义实现 retriever = index.as_retriever(similarity_top_k=6) # 第一站:召回 postprocessors = [reranker, similarity_cutoff] # 第二站:重排+过滤 synthesizer = get_response_synthesizer( response_mode=ResponseMode.COMPACT, streaming=False) # 第三站:合成 engine = RetrieverQueryEngine( retriever=retriever, response_synthesizer=synthesizer, node_postprocessors=postprocessors, )
四段各自负责什么
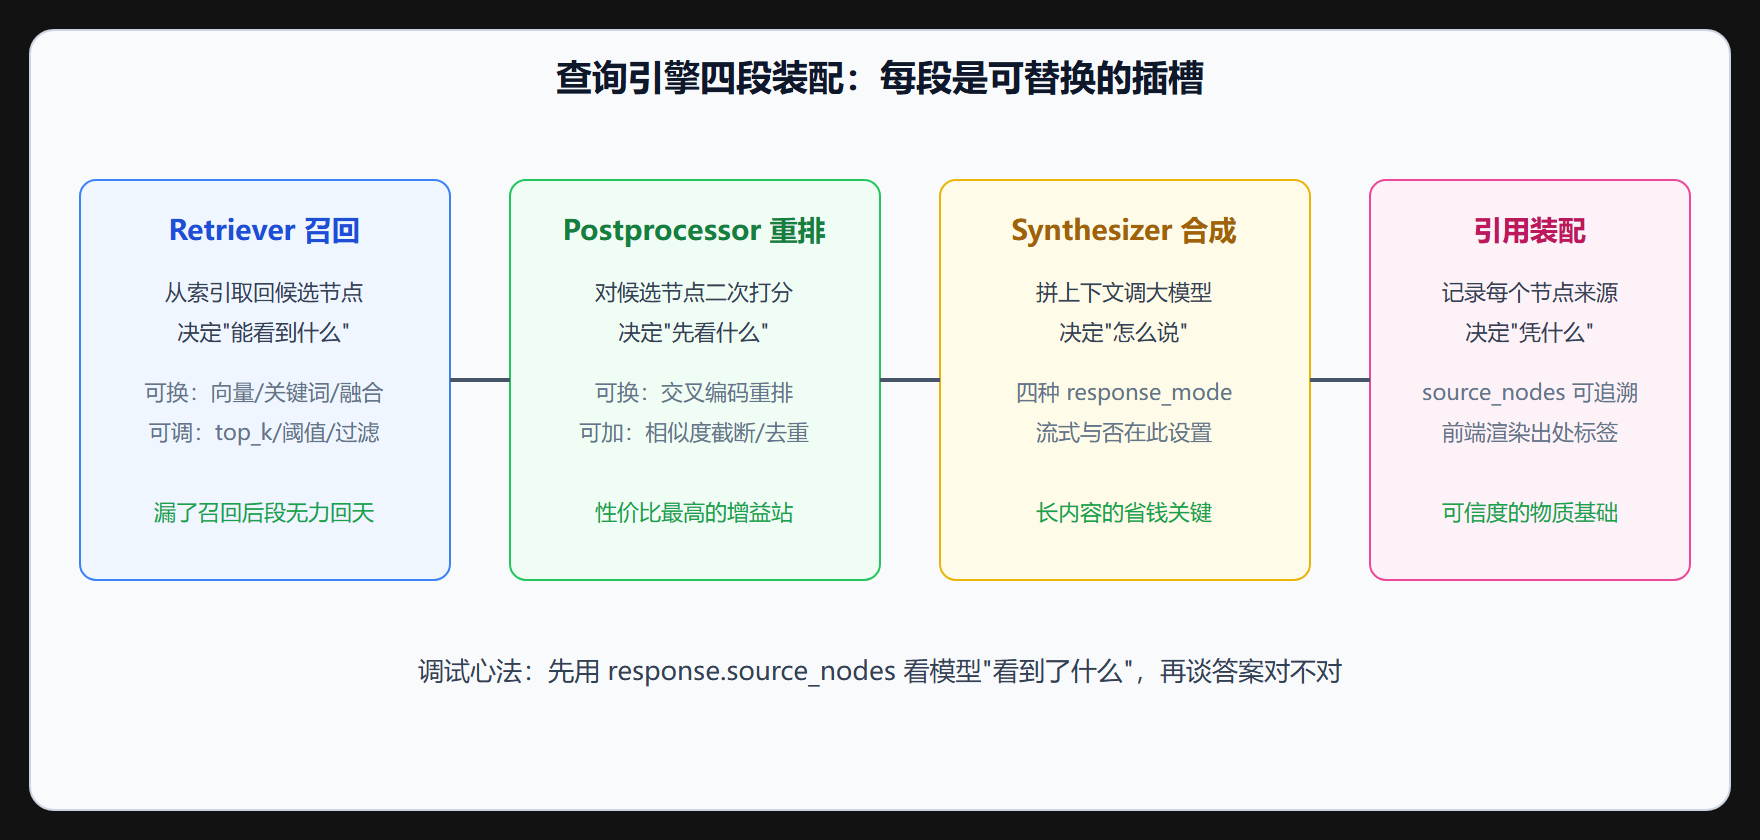
一个改变调试方式的习惯
答案不对时,先别怀疑模型——先看喂给它的原料。response.source_nodes 保留了最终参与合成的节点及得分:
resp = engine.query("P8 差旅住宿上限是多少?") for sn in resp.source_nodes: print(f"{sn.score:.3f} | {sn.node.metadata.get('file_name')} | {sn.text[:50]}")
如果正确条款根本不在 source_nodes 里,问题在召回(改检索器/查询转换,4.2、4.3 节);如果在但排在末尾被挤掉,问题在排序(加重排,本节下文);如果在且靠前但答错,问题才在合成(4.4 节)。这个三分法能把 RAG 调优从"整体玄学"变成"逐段归因",也是全册反复使用的解剖刀。
插一个重排器感受插槽威力
from llama_index.core.postprocessor import SimilarityPostprocessor from llama_index.postprocessor.flag_embedding_reranker import FlagEmbeddingReranker reranker = FlagEmbeddingReranker( model="BAAI/bge-reranker-base", top_n=4) # 交叉编码器重排取前4 cutoff = SimilarityPostprocessor(similarity_cutoff=0.3) # 分数截断 engine2 = RetrieverQueryEngine( retriever=index.as_retriever(similarity_top_k=10), # 宽召回 response_synthesizer=get_response_synthesizer(response_mode="compact"), node_postprocessors=[reranker, cutoff], # 严筛选 )
"宽召回 + 严重排"(先取 10 个、重排留 4 个)是检索质量提升的经典组合,比直接 top_k=4 的直通模式稳得多——交叉编码器逐对精算查询与文档的相关性,比双向量余弦的粗判更准,代价是多一次模型前向。
本节要点回顾
- 一行等价于四段装配:Retriever → Postprocessor → Synthesizer → 引用,每段都是插槽。
- 手工组装能力:会写 RetrieverQueryEngine 的显式构造,才有后续一切改装自由。
- source_nodes 三分法:不在→改召回;在但靠后→改排序;在前还错→改合成。
- 宽召回严重排:top_k 放大 + 交叉编码重排截断,是性价比最高的第一刀。
- 引用是物质基础:可追溯出处让回答从"像真的"变成"可验证的"。
常见问题
重排器应该常开吗? 召回数量小(top_k 小于 5)且语料干净时收益有限;召回宽(top_k 10 以上)或语料噪音多时收益显著。它是"用一次模型前向换排序精度"的交易,成本敏感的轻量场景可以用便宜的交叉编码器(如 base 级)起步,评估显示瓶颈在排序再升档。
similarity_top_k 到底调到多少? 从 4 到 6 起步,配合重排器可以放大到 10 到 20。判断依据不是感觉而是 5.4 节的指标:命中率随 top_k 增长趋平的拐点就是合适值。没有评估集时,看 source_nodes 里正确答案的排名分布也能有个大致判断。
为什么我的回答不带出处? 出处来自 source_nodes 的渲染,两种情况会丢:用了某些自定义合成路径绕过了标准引擎;或前端没有渲染引用组件。先打印 source_nodes 确认数据在,再查展示层。带出处的回答在用户信任度上与裸答案差一个量级,值得花时间修好。