5.1 LLM 智能体与工具
5.1 LLM 智能体与工具
本节摘要:智能体 = 大模型 + 工具集 + 决策循环。模型读工具描述,自己决定调用哪个、传什么参数、要不要继续。本节把查询引擎与普通函数包装成工具,对比 ReAct 与 OpenAIAgent 两类智能体的机理与取舍,并讨论"哪些任务该交给智能体、哪些坚决不该"。
从流水线到方向盘
第 4 章末尾的合同审查任务,用查询引擎硬做需要预先猜测所有分支;用智能体做,只需把"检索合同""查制度""算金额"三个能力注册成工具,模型在循环里自己决定次序。先用最简代码看清"循环"长什么样:
from llama_index.core.agent import ReActAgent from llama_index.core.tools import FunctionTool, QueryEngineTool, ToolMetadata # 工具一:查询引擎(第4章的成果直接复用) policy_tool = QueryEngineTool( query_engine=policy_engine, metadata=ToolMetadata( name="policy_qa", description="查询公司制度库,回答报销、审批、休假等问题", ), ) # 工具二:普通函数 —— 任何 Python 函数都能当工具 def calc_overdue_penalty(amount: float, days: int) -> str: """按公司标准计算逾期违约金:每天万分之五,上限为本金两成""" penalty = min(amount * 0.0005 * days, amount * 0.2) return f"违约金 {penalty:.2f} 元(本金 {amount} 元,逾期 {days} 天)" calc_tool = FunctionTool.from_defaults(fn=calc_overdue_penalty) agent = ReActAgent.from_tools([policy_tool, calc_tool], verbose=True) print(agent.chat("合同本金 50 万逾期 60 天,违约金多少?超过公司审批上限吗?"))
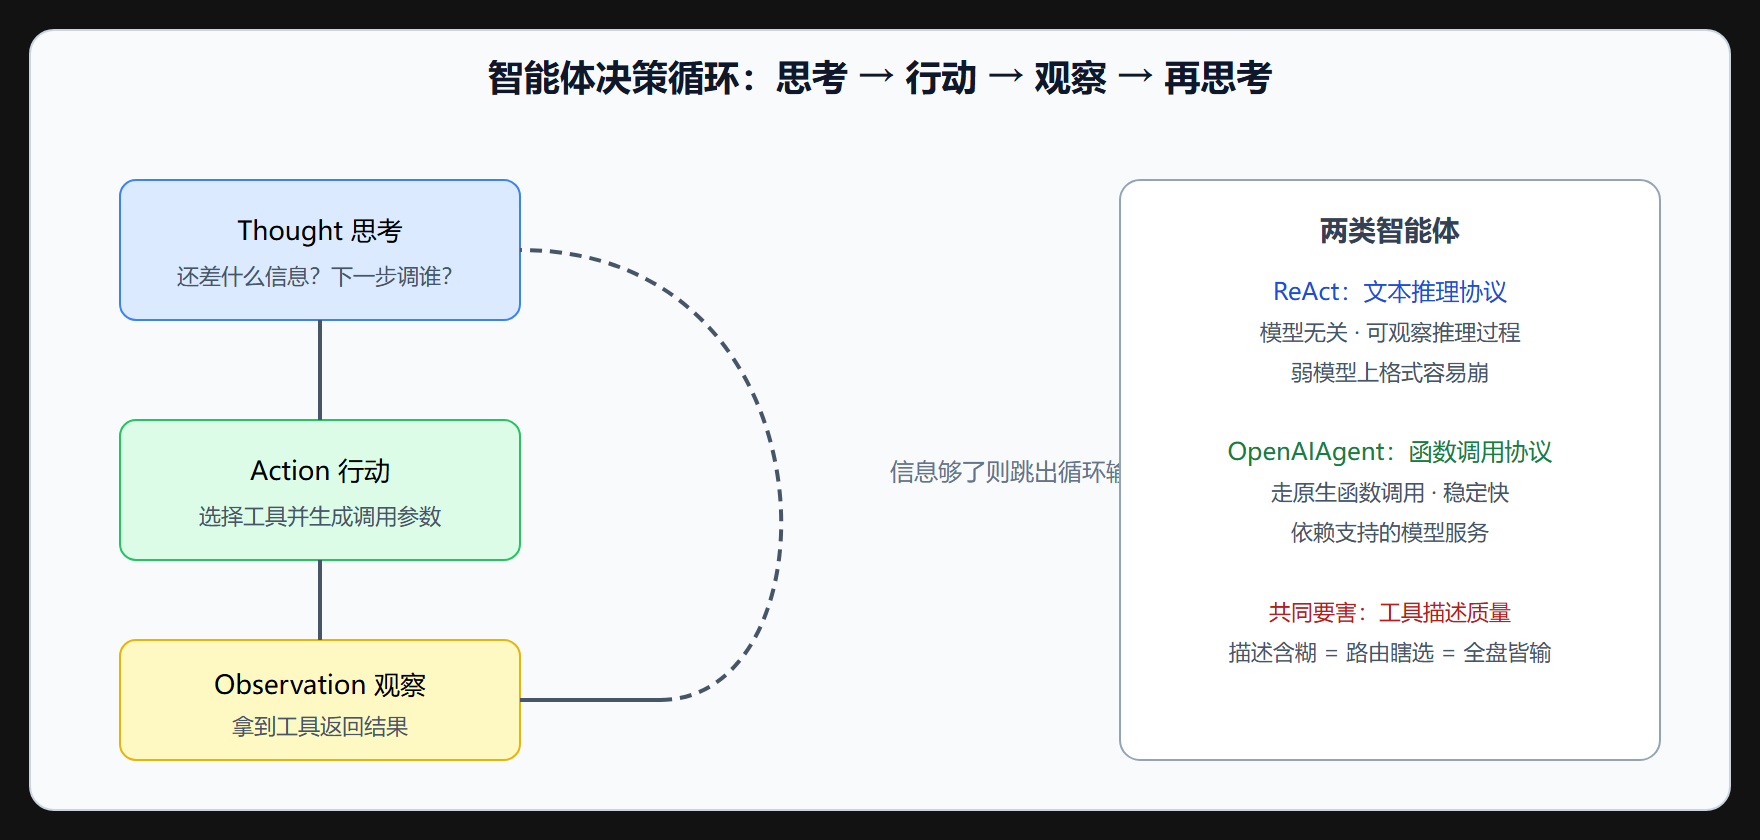
verbose 输出里能看到 ReAct 的推理轨迹:思考(Thought)→ 行动(Action: policy_qa / calc_overdue_penalty)→ 观察(Observation)→ 循环直到给出最终答案。这个"思考-行动-观察"循环就是智能体的心脏。
两类智能体怎么选
# 函数调用型:模型原生支持 function calling 时首选 from llama_index.core.agent import OpenAIAgent agent_fc = OpenAIAgent.from_tools([policy_tool, calc_tool], verbose=True)
选择逻辑:模型服务原生支持函数调用就用 OpenAIAgent(稳定、快、不易出协议格式错误);本地开源模型或需要完整推理轨迹审计时用 ReAct。两者的工具层完全一致,可以随时互换——工具包装是资产,智能体类型只是驱动方式。
什么任务该交给智能体
交的标准:任务多步骤且步骤依赖中间结果(先查再算再总结)、分支不可预知(不同输入走不同路径)。不交的标准:问题形态固定(一律查询引擎,又快又便宜又可测)、延迟敏感(智能体循环至少两三个来回,延迟翻倍起)、错误代价高(智能体的自由度同时是失控面,生产上要配步数上限与工具白名单)。
⚠️ 常见坑:把几十个工具一股脑塞给智能体,模型选择准确率随工具数量下降。工具按业务域分组,前面加一层 Router(3.5 节)先选域、再给该域的三五个工具,比"工具大杂烩"稳定得多。
本节要点回顾
- 心脏是循环:思考-行动-观察循环,verbose 轨迹是调试与审计的抓手。
- 工具即资产:查询引擎、普通函数都能包装,工具描述质量决定路由准确率。
- 两类驱动:函数调用型稳、ReAct 通用且可审计,工具层一致可互换。
- 交付判据:多步骤、依赖中间结果、分支不可预知才交智能体;固定形态用引擎。
- 工具别大杂烩:按域分组加 Router 分诊,几十个工具平铺是准确率杀手。
常见问题
智能体的延迟一般多少? 至少两到三个模型往返:一次决策调用工具、一次拿结果再决策、一次生成最终答案。相比单次查询引擎调用,延迟轻松翻三倍。所以 5.1 节的"交付判据"反复强调:固定形态的问题别交给智能体。
怎么防止智能体无限循环? 三个保险丝:最大迭代数上限(超过强制收尾);单步超时;重复调用同一工具同一参数的检测(连续两次完全相同的调用基本等于卡死)。生产智能体这三样缺一不可,自由度必须配缰绳。
工具的返回值很长(比如整篇文档),怎么办? 工具返回"摘要加出处"而不是全文,智能体需要细节时再调"取详情"工具。让智能体上下文保持"目录级"信息密度,既省 token 又防它被长文本淹没。工具设计的一半功夫在返回值的裁剪上。
关于工具设计再展开一句:好的工具描述要回答三个问题——这个工具做什么、什么时候该用它而不是别的工具、参数怎么填。缺任何一项,模型的选择与调用都会出错。实践中我习惯给每个工具描述配一个"典型问题示例",效果立竿见影。另外工具数量超过五个时考虑用 Router 分域(3.5 节),工具的"可发现性"随数量递减是所有智能体系统的共性规律,不分框架。
最后一个实战建议:先做"单工具智能体"的试运行。把一个查询引擎交给智能体、用真实问题跑一周,观察它的决策轨迹——什么时候多调了一次不必要的工具、什么时候该调没调。单工具场景下这些失误无害,却是你理解智能体行为模式的最好教材;等行为摸透了再扩工具集,稳得多。
工具设计还有一个度量习惯值得建立:统计每个工具的"被调用率"与"调用成功率"。长期零调用的工具该考虑下架(它只占用模型的选择注意力),频繁调用失败的工具该修参数描述。工具集不是建好就完事,也要像产品一样迭代运营。