6.4 生产环境部署架构与最佳实践
6.4 生产环境部署架构与最佳实践
本节摘要:RAG 服务的部署要点是"读写分离 + 缓存分层 + 索引版本化":查询服务无状态水平扩容,摄取走离线管道;请求路径上布语义缓存、结果缓存两级;索引作为版本化资产灰度切换。本节给出参考架构、FastAPI 服务化骨架与一份上线前检查清单。
参考架构
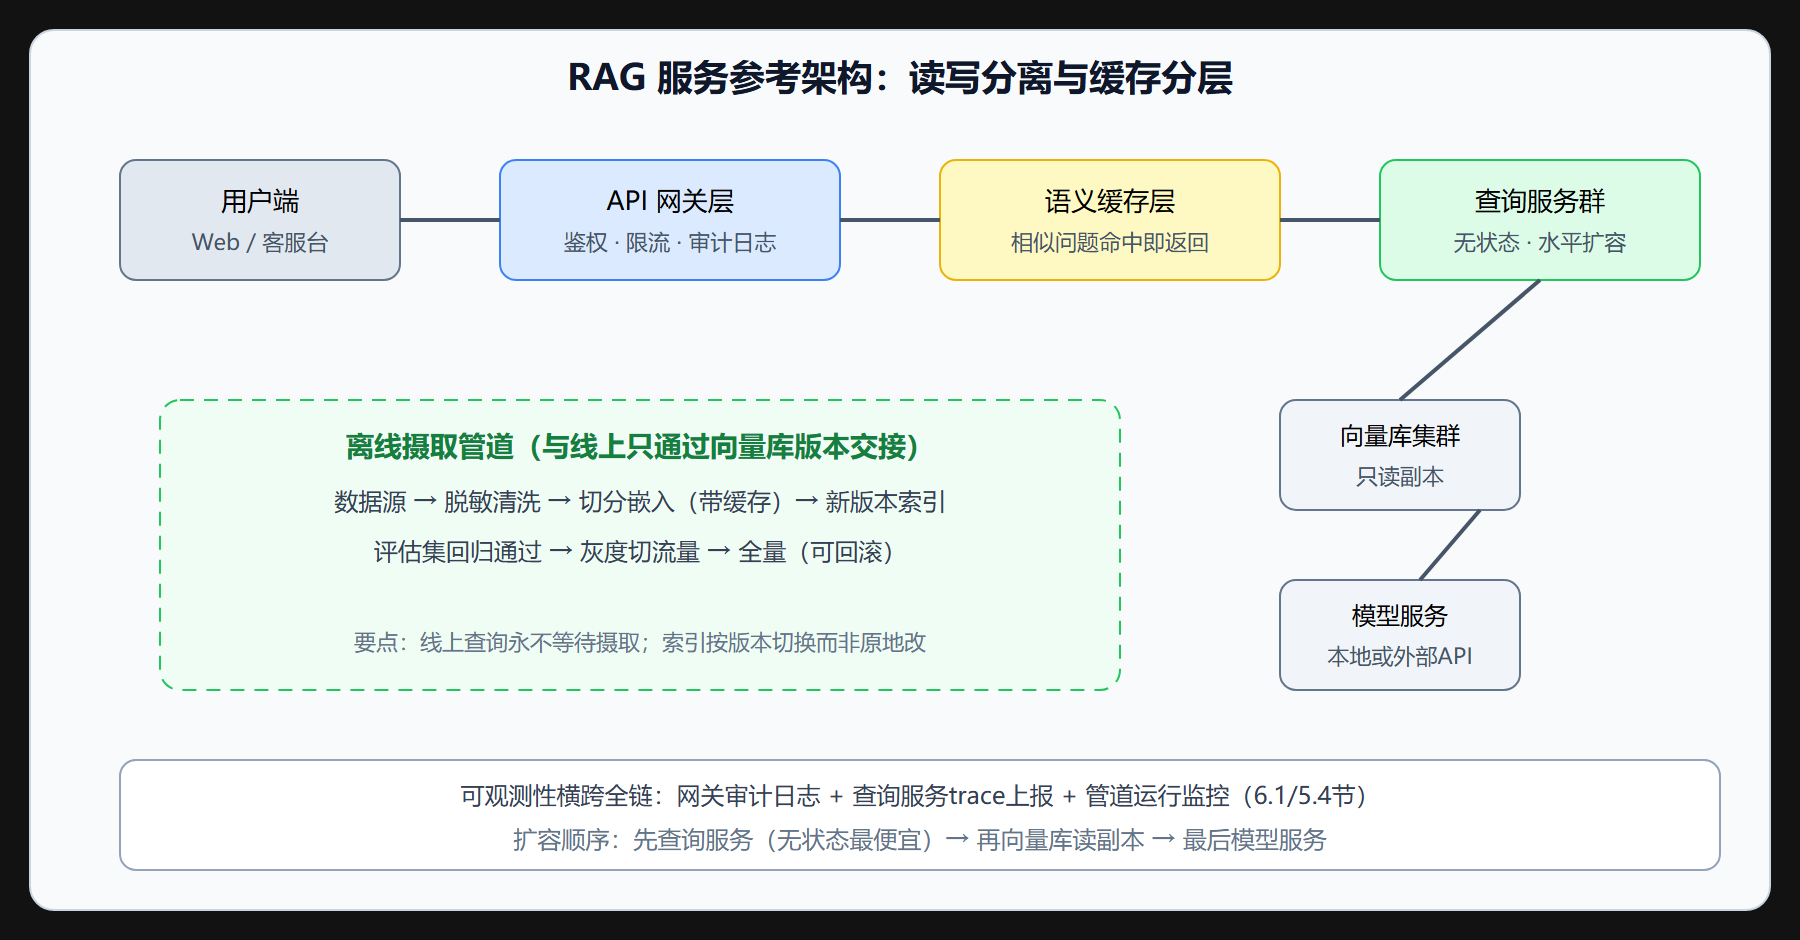
架构的核心决定只有两个:读写分离(摄取永远在离线管道跑完再切版本,线上只读)与无状态查询服务(索引连接与模型客户端随进程初始化,服务本身可随意扩缩容)。
服务化骨架
from fastapi import FastAPI, Request from pydantic import BaseModel app = FastAPI() engine = build_engine_from_version(CURRENT_INDEX_VERSION) # 启动时装载 class Ask(BaseModel): question: str @app.post("/ask") async def ask(body: Ask, request: Request): user = get_user(request) # 网关已鉴权,这里取身份 engine_with_acl = engine.clone_with_filters( # 6.3节权限过滤 acl_filters(user)) resp = engine_with_acl.query(body.question, streaming=True) audit_log(user, body.question) # 审计三要素 return StreamingResponse(stream_tokens(resp))
两个工程细节:流式响应用流式接口返回;权限过滤每次请求按用户构造,不要为每个用户缓存常驻引擎对象(内存会爆)。
上线前检查清单
一查索引版本化与回滚:新版本索引能否十分钟内切回?二查权限过滤:拿测试账号实际验证越权问题返回为空。三查限流与超时:网关限流保护后端,查询设总超时并在超时时返回兜底话术。四查缓存一致性:索引版本号入缓存键(6.1 节),切版本即失效。五查降级路径:模型服务不可用时,返回"暂无法回答"加检索到的原文链接(no_text 模式的产物),比直接报错体面。六查观测:trace 上报、审计落盘、管道监控告警全部就位。
⚠️ 常见坑:把摄取管道和查询服务写在同一个进程里"省事",结果每次全量更新时线上查询卡死。读写分离不是可选项。
本节要点回顾
- 两个核心决定:读写分离(离线管道 + 版本切换)、查询服务无状态(水平扩容)。
- 缓存分层:语义缓存拦相似问题,结果缓存拦重复问题,版本号入键保一致。
- 权限按请求构造:每次查询按用户身份加过滤,别缓存常驻引擎对象。
- 降级路径:模型不可用时退化为返回检索原文,比报错体面。
- 清单六查:回滚、越权、限流、缓存、降级、观测——上线前的最后一道闸。
部署形态的选择
三种常见形态按运维成本排序。单机容器:一个容器跑 API 服务,向量库用嵌入式(如 Chroma 持久化目录),适合日查询几千次的内部工具,一台四核八 G 的机器绰绰有余。容器编排:查询服务多副本加独立向量库服务加离线管道作业,适合有流量波动的对外服务,扩缩容由编排平台按负载自动完成。全私有化:模型、向量库、服务全部内网部署,合规硬约束下的选择,代价是运维复杂度与硬件投入。
# 无论哪种形态,健康检查接口都该有:报告索引版本与依赖状态 @app.get("/health") async def health(): return { "status": "ok", "index_version": CURRENT_INDEX_VERSION, "vector_store": vector_store.ping(), "model_service": model_gateway.ping(), }
健康检查暴露索引版本号这个小细节,能让"哪个副本还在跑旧版索引"这类发布事故在三分钟内定位,而不是靠猜。
上线后的第一周盯什么
四个数字每天看:错误率(超时、模型服务异常)、延迟分位数(P50 与 P95,别只看平均)、缓存命中率(异常下跌常意味着索引刚切版本、正常;持续过低说明该调缓存键归一化)、低分查询占比(相似度普遍偏低往往预示语料与问题域漂移,该补语料了)。第一周养出的看数习惯,比之后任何一次救火都有价值。
本节要点回顾(部署版)
- 三种形态:单机容器、容器编排、全私有化,按流量与合规选,从简单起步。
- 健康检查带版本:索引版本入健康接口,发布事故定位从小时级到分钟级。
- 第一周四数:错误率、延迟分位、缓存命中、低分占比——每个数字异常都对应一个明确的行动。
补充容量估算的思路:单副本查询服务在流式模式下的并发承载力,主要受模型服务的并发配额而非自身 CPU 限制——自测方法是逐步加压看 P95 延迟拐点。按"单副本并发数乘副本数小于模型配额"来规划副本上限,超出配额的副本只是浪费机器。另外给离线管道留独立资源池,避免摄取高峰挤占线上服务的向量库连接数。
服务化的一个进阶细节:引擎对象的构建成本要留意。启动时装载一次全量引擎是常态,但权限过滤与不同档位的引擎变体若每次请求都深拷贝,高并发下内存会抖动。务实做法是按权限组缓存轻量的过滤器包装,而不是缓存整套引擎;过滤器对象本身极轻,真正重的索引与模型客户端全程共享。这个细节在压测时表现为内存缓涨,早做设计早安心。
发布流程的最后一块拼图是"索引与代码的协同发布":代码新版依赖新版索引结构时,先发管道产出新索引版本,再灰度切换查询服务读取新版本,最后才上线依赖新特性的代码。三步有序,任何一步出问题都能退回上一步——发布顺序本身就是一种容错设计。
最后交代部署文档化的清单:系统拓扑图(哪个组件在哪、依赖谁)、索引版本与数据源版本的对应关系、发布与回滚的操作步骤、值班排障手册(常见告警的含义与第一反应)。这四份文档在事故发生时的价值,十倍于平时的编写成本——多数重大事故的扩大,都源于排障时对系统现状的不确定。