7.1 LlamaIndex 与其他 RAG 框架的对比
7.1 LlamaIndex 与其他 RAG 框架的对比
本节摘要:主流可选项有三——LlamaIndex(数据与检索为中心)、LangChain(通用编排生态)、Haystack(工程化流水线)。本节按"抽象重心、学习曲线、生态广度、评估工具、适用场景"五个维度做对比,给出场景化选型决策,并澄清一个常见误区:这些框架不是互斥的竞争关系,生产系统中常见组合使用。
先看抽象重心,再看功能清单
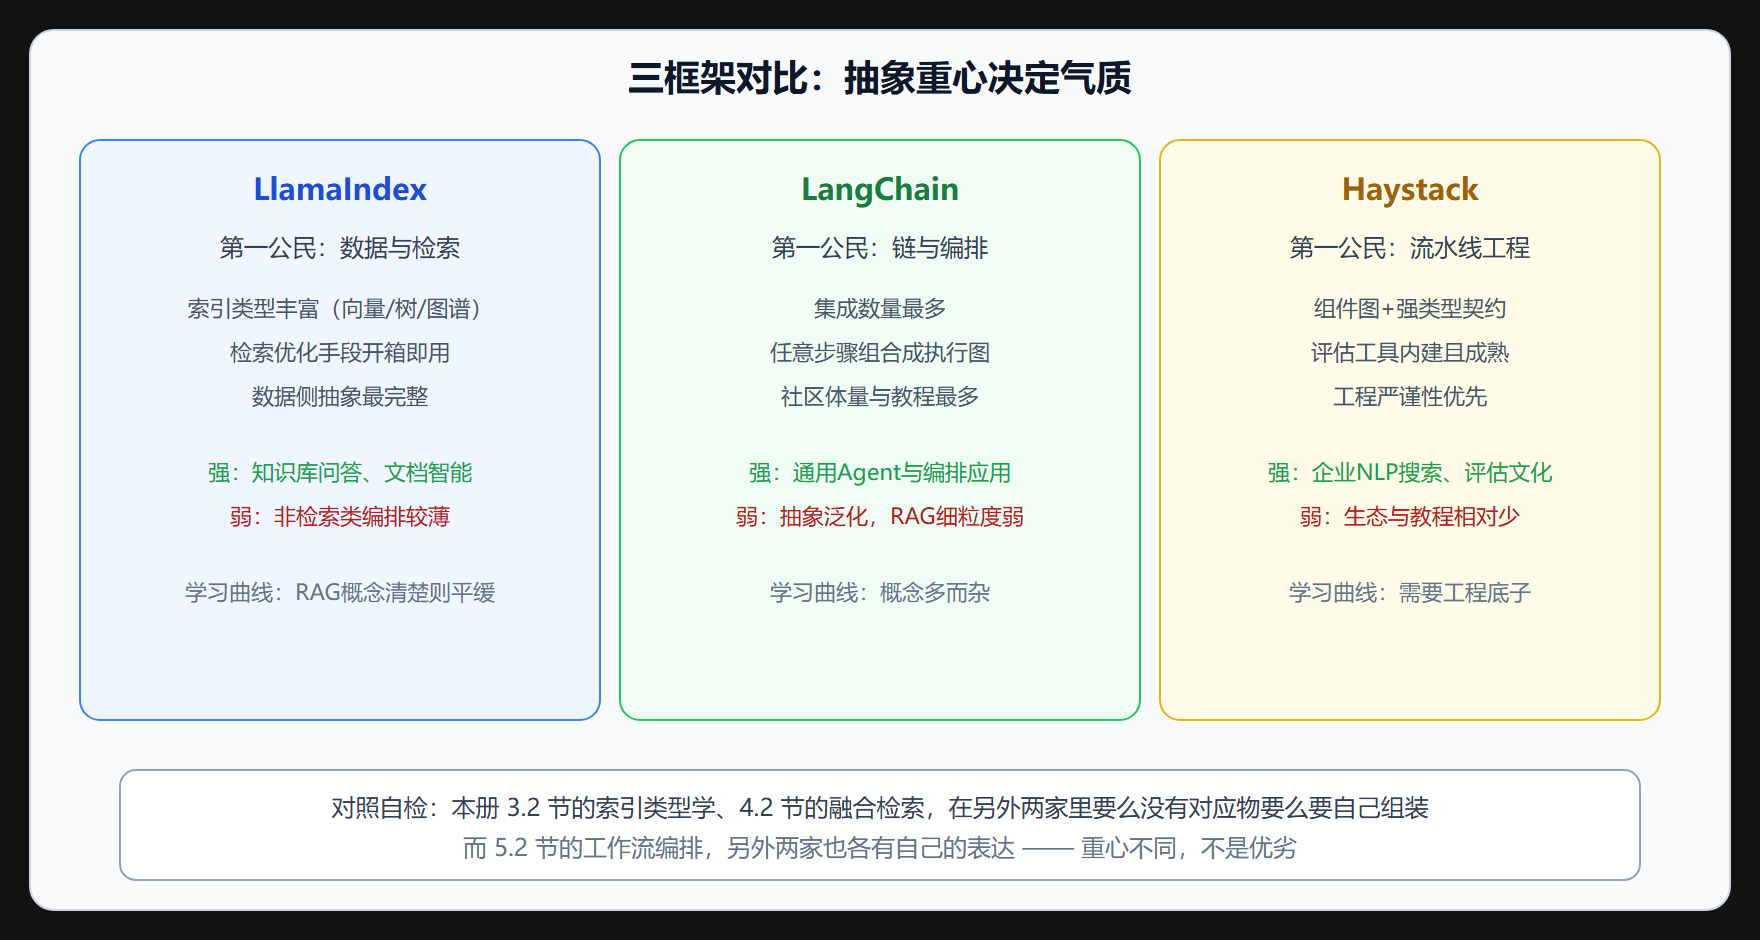
功能对比表会很快过时(三家都在快速迭代),但抽象重心的差异稳定得多。LlamaIndex 的第一公民是数据:Document、Node、Index、Retriever 这一族抽象全部围绕"知识如何被组织与检索"设计,RAG 是它的母语。LangChain 的第一公民是链:把任意步骤(不止检索)串成可组合的执行图,RAG 只是它众多用例之一,换来的是更广的集成面与更泛化的编排抽象。Haystack 的第一公民是流水线:显式的组件图、强类型的输入输出契约、内置评估,更像传统 NLP 工程体系的现代化身。
场景化决策
知识库问答 / 文档智能(本册主线):LlamaIndex 起步最快,数据侧深度(索引类型、切分策略、检索优化)罕见对手。通用智能体应用(编排要接触几十种非检索工具):LangChain 生态广度占优。评估文化浓、要严格回归测试的搜索团队:Haystack 的内建评估更对口。已有一套自研代码、只缺零件:可以不用任何全家桶,只借某些独立包(比如某家的重排器或连接器),框架的核心价值在抽象复用,零件本来就可拆。
一个被反复验证的提醒:选型的最大成本是团队学习成本与迁移成本,不是功能差异。三家的核心 RAG 能力都足以做出合格系统,差异在调优时的顺手程度。团队已有哪家的经验,权重应该高于功能表上的细微差别。
💡 关键直觉:框架对比的正确姿势是"比较抽象与重心",不是数集成数量——集成每季度都在变,抽象重心几年不变。
本节要点回顾
- 重心差异:LlamaIndex 数据为中心、LangChain 链为中心、Haystack 流水线为中心,各自气质由此而来。
- 场景决策:知识库问答选前者,通用编排选生态最广者,评估文化浓选工程化最严者。
- 不必二选一:生产中常见组合使用与"只用零件不用全家桶"。
- 团队成本优先:学习与迁移成本常大于功能差异。
- 看抽象不看清单:功能表会过时,抽象重心稳定。
迁移成本的实话
如果已有系统想换框架,真实的迁移成本在三层:概念层(一两周)——术语映射,比如另一家的某个组件对应这里的 Retriever;数据层(一两天)——向量数据按新格式导出导入,或者干脆用 2.4 节缓存重新嵌入(费用可控);逻辑层(一两周)——查询逻辑、权限过滤、缓存这些业务定制逐条搬迁。一个中型系统总迁移量约一到两个月人力,这就是"选型要慎重"的量化含义——不是不能换,是换之前要确认新框架的收益能覆盖这个价。
反过来,降低未来迁移成本的做法现在就能做:业务逻辑尽量落在标准契约上(Reader 接口、Retriever 接口、向量库的标准客户端),评估集随业务积累(迁移后跑一遍回归就知道损失多少)。7.2 节的契约层思想,在选型讨论里的意义就是"让今天的决定不至于锁死明天"。
一个真实的选型故事
一个法律科技团队的选型过程值得参考:他们先用某框架的通用链跑通原型,两周后发现法律文书检索的瓶颈在切分与层级召回——按条款切、按案件卷宗层级合并,这些能力在通用编排框架里都要手写。评估后切到 LlamaIndex,层级分块与自动合并检索(4.2 节)直接命中需求,而通用编排那部分经验也没浪费:智能体调度沿用了原框架的思路,最终系统是"检索层一个框架、编排层借鉴另一家"的混合形态。启示:选型不是站队,是按问题的主矛盾挑主力工具。
本节要点回顾(选型版)
- 迁移成本三层:概念、数据、逻辑,中型系统约一到两个月人力,量化后再决策。
- 降低锁定:业务逻辑落标准契约、评估集持续积累,今天的谨慎决定明天的自由。
- 混合形态正当:按主矛盾挑主力工具,多框架共存是常态而非失败。
最后给一个反直觉的观察:框架选型的争论在社区里很热闹,但成熟团队的实际痛点很少是"选错了框架",而是"没有评估集、没有观测、语料没人治理"——这些问题换任何框架都解决不了。如果你所在团队正在选型上纠结数周,不妨把这段时间拿去建评估集:它不但能让选型决策有依据(跑个对比就知道),其价值也远超选型本身。选型是岔路口,评估是道路本身。
还有一个维度值得补充:招聘与协作成本。选一个团队已有经验的框架,新人上手时间是天;选一个全新框架,是周。框架之争常被简化为功能对比,但对多数组织而言,"谁会维护这套系统"比"哪套系统理论上更好"重要得多。技术选型的最后一票,往往投给维护者的舒适区——这不是妥协,是对可持续性的尊重。
至于"要不要自研",只在两种情况下认真考虑:一是你的场景极度特殊(超大规模、极端延迟、特殊合规),框架的通用抽象成了负资产;二是你想把 RAG 能力做成团队的平台级产品。其余情况,在框架契约层做定制永远是性价比更高的路线——7.2 节的扩展机制就是为这条路准备的。
把选型决策再压缩成一个可操作的流程:第一步列约束(团队经验、合规要求、已有基础设施);第二步按主矛盾归类场景(检索问答、通用编排、工程化搜索);第三步拿两个候选框架各做一周最小原型,用同一份评估集打分;第四步把迁移成本列进决策表。走完这四步,结论通常自然浮现——选型最难的不是比较,是诚实地面对自己的约束。
最后收个尾:所有框架对比的结论都建议标注日期并半年复审——这个领域变化太快,去年成立的判断今年可能反转。养成"带时间戳的选型结论"这个习惯,比记住任何一个具体结论都重要。
还有一个小而实的建议:无论最终选了谁,花一天读一遍另一家主流框架的核心抽象文档。对比阅读会让你对自己主力框架的设计取舍看得更透——知道"另一条路长什么样",才真正理解"这条路为什么这样走"。