2.1 算法偏见如何伤害真实人群
2.1 算法偏见如何伤害真实人群
本节摘要:算法偏见是训练数据、特征、目标函数与部署反馈把现实世界的不公复制并放大的过程。伤害发生在招聘、信贷、司法风险评估、医疗与人脸识别等分配机会的场景。公平没有单一公式:统计平等、机会均等、均衡赔率、预测值相等往往不能同时成立。工程上只能按场景选指标,并在数据前、训练中、输出后三处设卡,同时切断反馈循环。
学习目标
阅读完本节,你应当能够:
- 区分历史、选择、测量、表征四类数据偏见,并各举一类业务例子。
- 说明为何「整体准确率最高」会牺牲少数群体。
- 在统计平等与机会均等之间做出场景化选择,并说出代价。
- 列出预处理、训练中约束、后处理调阈值各自的适用边界。
一、拒信到来时,偏见已经训练完了
申请人看不到模型,只看到「未通过」。历史招聘记录里某类岗位几乎全是男性,模型会把「像过去的成功员工」学成规则。信贷里邮编、消费品类成为种族或阶层的代理变量。司法里用逮捕与起诉记录当「风险」,等于把过去的执法密度写成未来的危险分数。人脸识别训练集若以浅肤色男性为主,较深肤色女性错误率会系统性偏高——这是公开研究反复展示的模式,不是某家公司的独家丑闻细节。
伤害清单在原文里写得很具体:歧视性决策、固化不平等、侵犯权利、摧毁信任、触发反歧视法与合规处罚。我补一句工程上容易漏的:偏见一旦进入自动流程,会以远超人工审核的速度复制。人工招聘官的偏见是个案;模型的偏见是政策。
二、偏见从三条管道进来
数据偏见最常见。历史偏见:数据是过去歧视实践的化石。选择偏见:采集没覆盖真实使用分布。测量偏见:标签本身歪了,例如用「被捕」代替「犯罪」。表征偏见:敏感群体样本过少或特征残缺,模型在他们身上胡猜。
算法设计偏见在数据相对均衡时仍会发生。模型结构爱抓虚假相关;特征选择把敏感属性的代理变量留了下来,或把能纠偏的特征丢掉;目标函数只最大化全局准确率,少数群体变成可接受的误差来源。
人机交互与应用偏见发生在上线之后。人对模型输出的解读带自己的成见。更危险的是反馈循环:系统说某社区风险高 → 更多执法 → 更多记录 → 模型更确信。预测性警务文献把这写成自我实现的预言。推荐系统里也有:越推越极端的内容,用户越被当成「本来就爱看」。
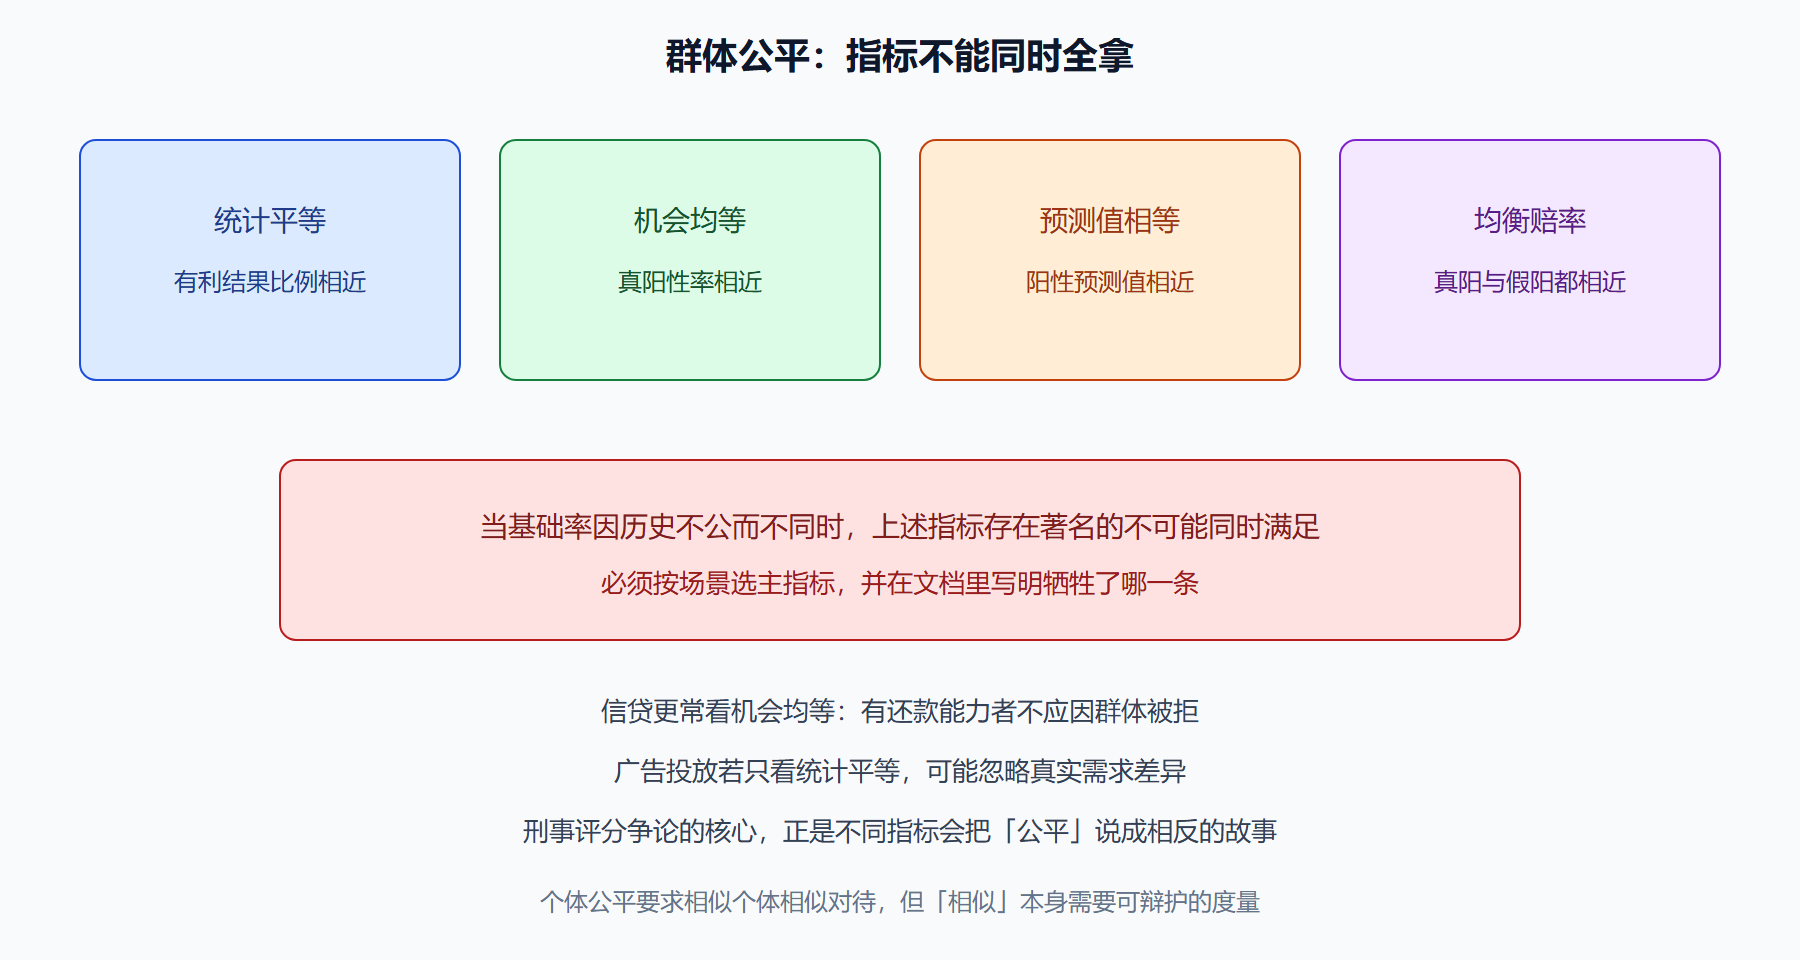
图 公平指标互相卡住
三、公平定义:先承认不可能三角,再选
群体公平看受保护群体在结果上的统计关系。统计平等要求有利结果比例接近。机会均等要求在真实为「应得」的人里,被模型选中的比例接近(真阳性率)。预测值相等要求模型报「通过」时,各组真实通过率接近。均衡赔率要求真阳性率与假阳性率都接近。
个体公平要求相似的人得到相似决定,关键是相似性度量不能偷运歧视。实践中,当标签与敏感属性在真实世界里相关——往往正是历史不公造成的——这些定义会冲突。刑事风险评分的公开争论,本质是:用哪一条公平,故事完全不同。原文称之为不可能三角,要求在场景、伦理与利益相关者之间协商,而不是找一个「数学上最公平」的万能指标。
| 策略阶段 | 做法 | 擅长 | 代价 |
|---|---|---|---|
| 预处理 | 重采样、重加权、多样化采集、检测代理变量 | 从源头减表征不足 | 可能损失信息或引入新偏 |
| 训练中 | 公平约束、对抗性去偏 | 把指标写进优化 | 调参难,全局精度常下降 |
| 后处理 | 分组调阈值、校准 | 上线后可快速止血 | 不改内部表示,可能不稳 |
| 非技术 | 人工复核、审计、法规 | 兜住高风险个案 | 成本高,依赖复核质量 |
对抗性去偏的思路原文写得很清楚:训练一个判别器去猜输出里有没有敏感属性信息,主模型则学会让判别器猜不准。它不是魔法,敏感属性仍可能从代理变量里漏出来。
⚠️ 常见坑:只做一次全库准确率,或只看「男女通过率一样」而忽略真阳性率。统计平等在基础率不同时会强制配额,可能伤害真正符合条件的人,也可能掩盖组内不公。
💡 关键直觉:公平是产品决策。你必须写下主指标、牺牲的指标、以及人工复核覆盖哪些拒绝。
公平门禁伪代码 for group in sensitive_slices: report tpr, fpr, selection_rate, calibration if any slice below floor: block_release() if feedback_loop detected: freeze_retraining_until_reviewed()
缓解流程应按原文:数据先检测再决定是否去偏,训练后评估公平,不行就改算法或后处理,部署后持续审计。高风险场景必须有人复核,而不是把后处理阈值当永久补丁。
问题:去掉敏感字段是否就公平了?
通常不够。邮编、姓名、购物、学校都会当代理。去字段而不查代理,是自我安慰。需要的是切片评估与代理审计,不是把性别列删掉截图存档。
问题:公平会不会让模型变笨?
可能会让全局准确率下降,这是取舍,不是 bug。若业务不能接受任何下降,说明业务在用多数群体的分数补贴自己,把成本外部化给被误伤的人。那是定价问题,不是技术不可能。
四、招聘、信贷、司法、医疗:同一机制不同地板
招聘里的历史偏见最容易懂:成功员工画像复制过去的性别与学校结构。工程上除了切片,还要禁止用姓名、照片、毕业年份当捷径特征,并规定人工复核不能只抽「模型已通过」的人——否则复核会确认偏见。信贷里的代理变量更隐蔽:消费品类、设备型号、社交关系都可能指向阶层。机会均等往往更合适:有还款能力者不应因群体被拒;统计平等可能变成配额,掩盖组内差异。司法风险评估的公开争论提醒我们:用逮捕当标签是测量偏见;不同公平指标会把「公平」说成相反故事,因此任何上线决定必须写明主指标与被牺牲指标,并允许独立复核。医疗里的表征偏见表现为皮肤类型、性别、年龄段上的灵敏度差异;这里假阴性的代价是漏诊,地板应高于营销推荐。
反馈循环在预测性警务与内容推荐里形态不同,治理相同:模型输出若决定下一轮标签,必须注入探索性抽样或冻结再训练。否则 5.3 的任何去偏都会被数据吞回。法律合规风险原文已点名:反歧视法不因为你用了「算法」就豁免。产品语言里的「客观分数」在法庭上站不住,日志与切片反而站得住。
个体公平要求相似的人相似对待。相似性若用「与过去成功员工的距离」,会把历史歧视写成几何。必须由业务与法务共同定义可辩护的相似:同一岗位、同一硬性资格,而不是同一邮编。做不到个体度量时,至少保证群体主指标过线,并在高风险拒绝上保留人。
五、指标选择决策树、伤害分档与「删列即公平」反例
公平没有单一公式,上线必须写成产品决策。决策树:先切片,无切片禁止宣称公平。再查四类数据偏见——历史化石、采集缺口、标签代理、表征不足——各写一条证据。再选主指标:招聘信贷倾向机会均等,同时上报统计平等;惩罚不可逆的场景控制假阳性差;医疗看分组灵敏度。最后查回流:模型输出若决定下一轮标签,必须探索抽样或冻结再训练,否则 5.3 的去偏会被数据吞回。个体公平的「相似」若用「与过去成功员工的距离」,会把历史歧视写成几何,必须改成同一岗位同一硬性资格。
| 伤害档 | 管道 | 现场 | 反例 |
|---|---|---|---|
| 历史复制 | 数据历史偏见 | 成功员工画像复制性别结构 | 认为「客观分数」可抗辩 |
| 代理偷运 | 邮编、设备、姓名 | 信贷与定价 | 删性别列截图存档 |
| 测量歪了 | 逮捕当风险 | 司法评分公开争论 | 用不同公平指标各说各话却不上报主指标 |
| 表征不足 | 样本过少 | 人脸跨群体误差 | 全局准确率掩盖少数群体 |
| 回流焊死 | 预测驱动执法或推荐 | 自我实现预言 | 去偏一次当永久 |
治理检查项:发布包附切片表,样本量过小标明置信不足;代理变量扫描贡献过大进入特征治理;人工复核不能只抽「模型已通过」的人。反例:只看男女通过率一样而忽略真阳性率;统计平等在基础率不同时强制配额;对抗性去偏当魔法却不扫代理。法律不因你用了算法就豁免反歧视义务。产品语言里的「客观」在法庭上站不住,日志与切片反而站得住。
偏见分诊决策树 无切片 ──► 未开始公平工作 有代理无扫描 ──► 删列无效 有回流 ──► 先切断再干预 指标打架 ──► 写主指标与代价,禁止找万能公式 复核只抽通过者 ──► 复核在确认偏见
下一节看数据被模型吃掉之后,隐私如何在「没用原表」的情况下仍然被泄露。
本节要点回顾
- 偏见是化石加放大镜:历史、选择、测量、表征四类数据问题最常见。
- 目标函数会歧视:全局准确率允许牺牲少数群体。
- 反馈循环会焊死错误:预测驱动的资源投放必须切断或约束。
- 公平指标互相冲突:选主指标并写明代价。
- 三阶段干预:预处理、训练中、后处理,外加人工复核。
- 删敏感列不够:代理变量仍在。
- 持续审计:上线后分布会变,一次达标不等于一直达标。
工作纸:选定主公平指标并写下被牺牲的指标。招聘与信贷更常以机会均等为主,同时上报统计平等以免配额幻觉。列出四类数据偏见在本数据中的证据:历史化石、采集缺口、标签代理、表征不足。画出再训练数据是否包含本模型昨日决策;若是,必须设计探索抽样或冻结。代理变量扫描:哪些特征能预测敏感属性,贡献过大则进入特征治理。发布包附切片表,样本量过小标明置信不足。删敏感列若是你现在的唯一动作,把它从「已完成公平」改列为「未开始」。
下一节看数据被模型吃掉之后,隐私如何在「没用原表」的情况下仍然被泄露。