2.2 隐私被模型吃掉之后
2.2 隐私被模型吃掉之后
本节摘要:现代模型饥饿的是数据,擅长的是把购物、位置、社交与健康记录融合成细粒度画像,并预测你尚未说出的状态。隐私风险不只是数据库被拖走,还包括超出目的使用、成员推断、模型反演与去匿名化。差分隐私给出可量化噪声保证;联邦学习让原始数据留在本地;同态加密与安全多方计算在密文或联合计算中工作。它们都要拿效用和算力换,且必须叠上最小化、目的限定与隐私设计,才能对得起 GDPR、CCPA 与个人信息保护法。
学习目标
阅读完本节,你应当能够:
- 说明 AI 如何通过融合与推断把「非敏感字段」变成敏感结论。
- 区分成员推断与模型反演,并写出对应的威胁模型。
- 在差分隐私、联邦学习、同态加密、安全多方计算之间做场景选择。
- 把数据最小化、目的限定、访问审计写成上线检查项。
一、原表删了,模型还记得
隐私讨论若停在「库加密了吗」,会漏掉模型当记忆体这件事。攻击者不一定要拿到病历表。成员推断通过观察模型对某条记录的反应,判断它是否出现在训练集——对医疗、人脸、财务模型,这已经是敏感事实。模型反演更进一步,在某些设定下能从输出里重构训练样本的近似,例如人脸。匿名化若只删姓名,留下足够多准标识符,再与公开数据一交叉,人就被认回来。原文把这几条写成 AI 放大隐私风险的机制,而不是黑客故事集。
数据饥渴让组织倾向「先囤着再说」。融合与关联让看似无关的日志变成精密画像。细粒度预测能估计健康风险、偿付能力、政治倾向,于是监控与操纵从技术上变得便宜。自动化把一次配置错误放大成规模泄露。黑箱则让「数据到底怎么被用进决策」难以审计。
二、滥用不只是拖库
超出目的使用:为客服收集的对话,转去训练无关的营销模型。歧视性应用:用推断出的敏感属性做招聘或定价。操纵:微定向广告打在心理弱点上。非法监控:人脸、步态、位置拼成持续追踪。安全漏洞:存了敏感数据的训练集群成为高价值目标。权力不对等:持有数据与模型的机构对个人形成信息碾压。
后果不只是诈骗。信任崩了,人会停止提供真实数据,模型反而更差——这是隐私失败的反馈循环。医疗与公共部门尤其明显:一次再识别丑闻,可以让后续研究拿不到数据。
| 技术 | 保护什么 | 典型代价 | 更适合 |
|---|---|---|---|
| 差分隐私 | 单个记录对输出的影响被噪声盖住 | 查询或模型效用下降 | 统计发布、部分训练 |
| 联邦学习 | 原始数据不离开本地 | 通信、异构、投毒与梯度泄露 | 手机、医院联盟 |
| 同态加密 | 在密文上计算 | 全同态开销仍大 | 窄查询、高敏感外包 |
| 安全多方计算 | 多方输入不互看 | 协议复杂、轮次多 | 两家企业对共同客户计数 |
| 假名/匿名 | 去直接标识 | 易被背景知识击穿 | 须与其他 PET 叠用 |
⚠️ 常见坑:把联邦学习宣传成「绝对隐私」。上传的梯度与参数更新仍可能泄露;需要安全聚合、差分隐私或对更新再加噪。
💡 关键直觉:隐私是预算。噪声越大越安全,模型越糊。你必须写下 epsilon 或同等约束,而不是口头「我们加了噪声」。
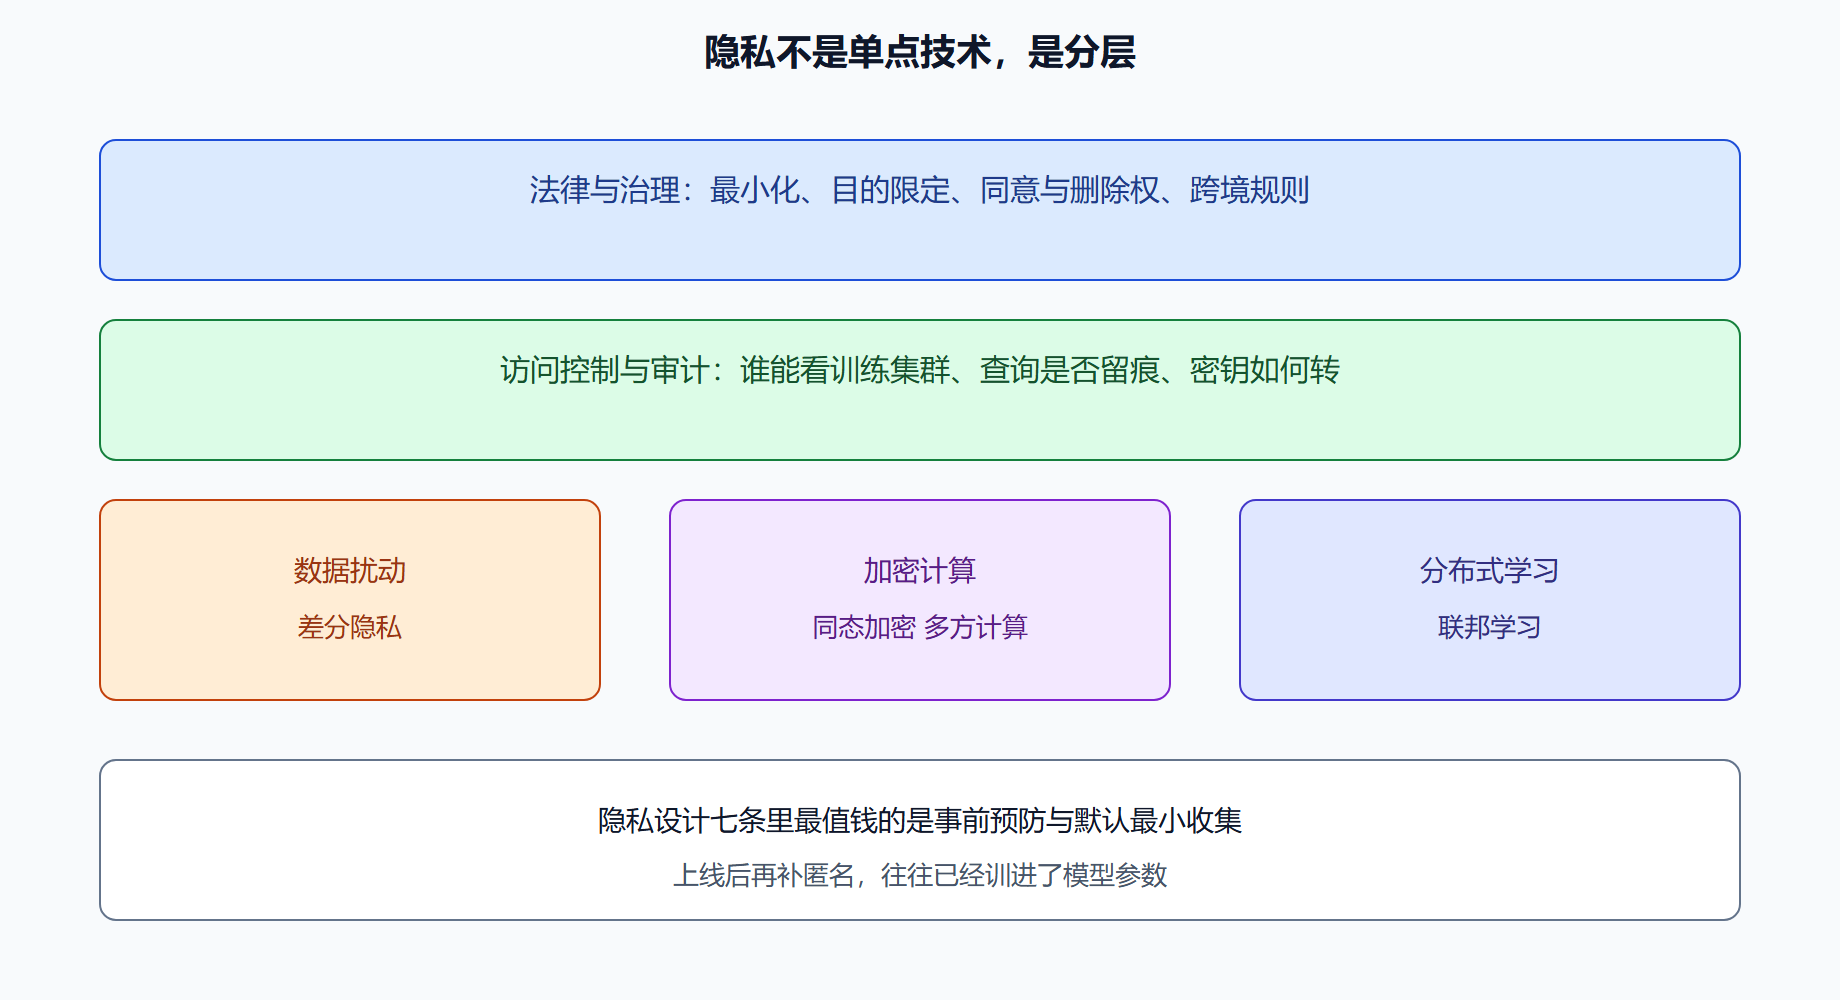
图 隐私增强技术怎么叠
三、法规翻译成工程语言
欧盟通用数据保护条例、加州消费者隐私法及其修订、中国个人信息保护法,都要求合法性、最小化、目的限定、透明,并赋予访问、更正、删除等权利。对自动化决策,当事人常常需要有意义的信息:逻辑涉及什么、后果是什么。跨境传输另有规则。工程翻译是:训练清单里必须有合法基础;特征表里必须能指出每一列的目的;模型迭代必须能响应删除请求——这很难,因为删除一行并不能自动让参数忘掉那一行,往往需要停训、机器遗忘研究或缩短数据留存并定期重训。
隐私设计原则原文列了事前预防、默认隐私、嵌入设计、功能不减到不可用、端到端安全、可见可审计、以用户为中心。我最看重前两条。默认把麦克风与通讯录权限全打开的应用,后面再写「用户可关」是在玩弄同意。
威胁模型草稿 资产:训练集、嵌入、日志、模型参数、查询接口 对手:外部查询者、内部过度授权、合作方二次使用 推断:成员推断、属性推断、反演、链接攻击 控制:查询限速、DP、最小化、差分访问、定期重训删除 残留风险:书面接受,指定复审日期
效用与隐私的平衡没有闭式解。全同态加密理论上漂亮,大规模训练仍贵。攻击者会针对你选的 PET 换打法。所以 PET 是必要但不够,必须叠治理:谁批准新的数据用途、用途变更是否等于新项目。
问题:用户点了同意是不是就够了?
同意在权力不对等时很弱:不点就用不成基本服务,同意就不是自由的。法规越来越强调目的限定与最小化,而不是无限总同意。产品应把非核心训练用途设为默认关。
问题:开源模型有没有隐私问题?
有。权重可能记忆训练文本中的个人数据;输出可能复述。公开权重等于把记忆体发给所有人。需要训练前过滤、输出过滤、记忆测试,而不是假设「已经公开就无隐私」。
四、从收集到删除:生命周期上的隐私债
数据最小化不是少存几个字段那么简单。特征工程会派生出比原字段更敏感的推断:从位置序列得到家与公司,从购物得到孕期,从语音得到健康状态。目的限定要求这些派生也要有合法基础,不能说「原始字段是位置所以派生合法」。访问控制要覆盖训练集群、特征平台、嵌入库、日志检索,而不是只锁生产库。原文把传输加密与静态加密列为数据安全基线——这是卫生,不是 PET;没有卫生,差分隐私也救不了被拖走的明文训练集。
跨境与供应商是第二笔债。标注外包、云训练、评测供应商都可能构成处理者。合同要写清禁止二次训练、到期删除、违约审计。开源权重若记忆了个人数据,公开即扩散,训练前过滤与记忆测试必须进流水线。用户行使删除权时,工程上应停止用该用户数据做增量,并在留存到期时重训;向用户承诺「参数已立即忘记」在当前技术下通常不诚实。
解释接口与个性化推荐会成为侧信道:过细的「因为你上周去过某医院所以……」本身就是隐私伤害。对当事人的解释应停留在因素类别,把细粒度画像留给有权限的审计,而不是当成产品卖点。这与 2.4 的听众分层一致:不是越细越好。
五、威胁模型决策树、泄露分档与「点了同意」反例
隐私若停在「库加密了吗」,会漏掉模型当记忆体。决策树按对手走:外部查询者——成员推断与反演必须评测,查询限速。能看到联邦更新的服务器——安全聚合与对更新加噪,否则数据不出门是假的。内部人员与标注外包——最小化、目的限定、禁止二次训练,合同到期删除。派生特征(从位置得到家与公司、从购物得到孕期)要有自己的合法基础,不能说「原始字段合法所以派生合法」。删除权触发时,停止增量并在留存到期重训;承诺参数立即忘记通常不诚实。
| 泄露档 | 机制 | 法规翻译 | 反例 |
|---|---|---|---|
| 融合画像 | 非敏感字段组合出敏感结论 | 目的限定覆盖派生 | 先囤着再说 |
| 成员推断 | 判断谁在训练集 | 医疗财务人脸视为敏感事实 | 删表即无隐私问题 |
| 反演 | 重构样本近似 | 输出过滤与记忆测试 | 开源权重当无隐私 |
| 同意勒索 | 不点就用不成基本服务 | 非核心训练默认关 | 总同意包打天下 |
| 解释过细 | 推荐文案泄露行踪 | 当事人只给因素类别 | 当产品卖点 |
治理检查项:每一列特征能否指出目的;训练清单有无合法基础;跨境与供应商是否构成处理者;隐私预算若无法报出数字则删除差分隐私宣传。反例:默认打开麦克风与通讯录再写「用户可关」;联邦学习宣传绝对隐私;匿名化只删姓名留下准标识符。传输加密与静态加密是卫生不是 PET,没有卫生,差分隐私也救不了被拖走的明文训练集。GDPR、CCPA、PIPL 的共同工程翻译是最小化与目的限定,解释权与删除权要落到迭代节奏。
隐私分诊决策树 对手未写 ──► 不准采购 PET 只会加密磁盘 ──► 未覆盖推断 联邦无安全聚合 ──► 假出境合规 删除只改主库 ──► 缓存与嵌入仍记得 同意当唯一基础 ──► 权力不对等,改默认关
下一节问:这些伤害发生后,法律和技术上究竟谁来负责。
本节要点回顾
- 模型是记忆体:删表不等于删推断能力。
- 融合比单库可怕:非敏感字段组合出敏感结论。
- 成员推断与反演必须进威胁模型。
- PET 要叠用:DP、联邦、加密计算各管一段。
- 联邦学习不是保险箱:梯度仍可能漏。
- 法规要点是最小化与目的限定:同意不能包打天下。
- 删除权与参数记忆冲突:需要留存上限与重训策略。
工作纸:画三种对手——外部查询者、中心服务器、内部人员——各写一条已有控制与一条缺口。成员推断与反演是否评测过,结果放哪。联邦学习若在用,安全聚合与更新加噪做了没有。删除请求来时,增量是否停止、下次重训日期是否写进日历。解释接口与推荐文案有没有泄露过细画像。隐私预算若无法报出数字,差分隐私宣传必须从材料中删除。最小化:列出可以不收集却仍在收集的字段,下个迭代关掉默认。供应商合同有无禁止二次训练。这些比再买一个加密方案更先做。
下一节问:这些伤害发生后,法律和技术上究竟谁来负责。