3.2 泛化失败与不确定性
3.2 泛化失败与不确定性
本节摘要:泛化是模型在未见样本上仍可用的能力。开放世界里,数据分布会因时间、地点、设备、人群而偏移;罕见病变、极端天气、非标准口音会让「测试集优秀」的系统突然降智。与对抗不同,这里常常没有敌人,只有世界比训练集大。安全要求系统估计不确定性:高不确定时拒绝、降级或交给人,而不是用一个过分自信的概率把人送进不可逆流程。
学习目标
阅读完本节,你应当能够:
- 区分独立同分布假设与真实部署中的分布偏移。
- 举出医疗、语音、驾驶中因罕见或环境变化失效的类型。
- 说明校准不良的置信度如何比「低准确率」更危险。
- 设计「不会就说不会」的降级策略。
一、测试集是一张被修剪过的世界地图
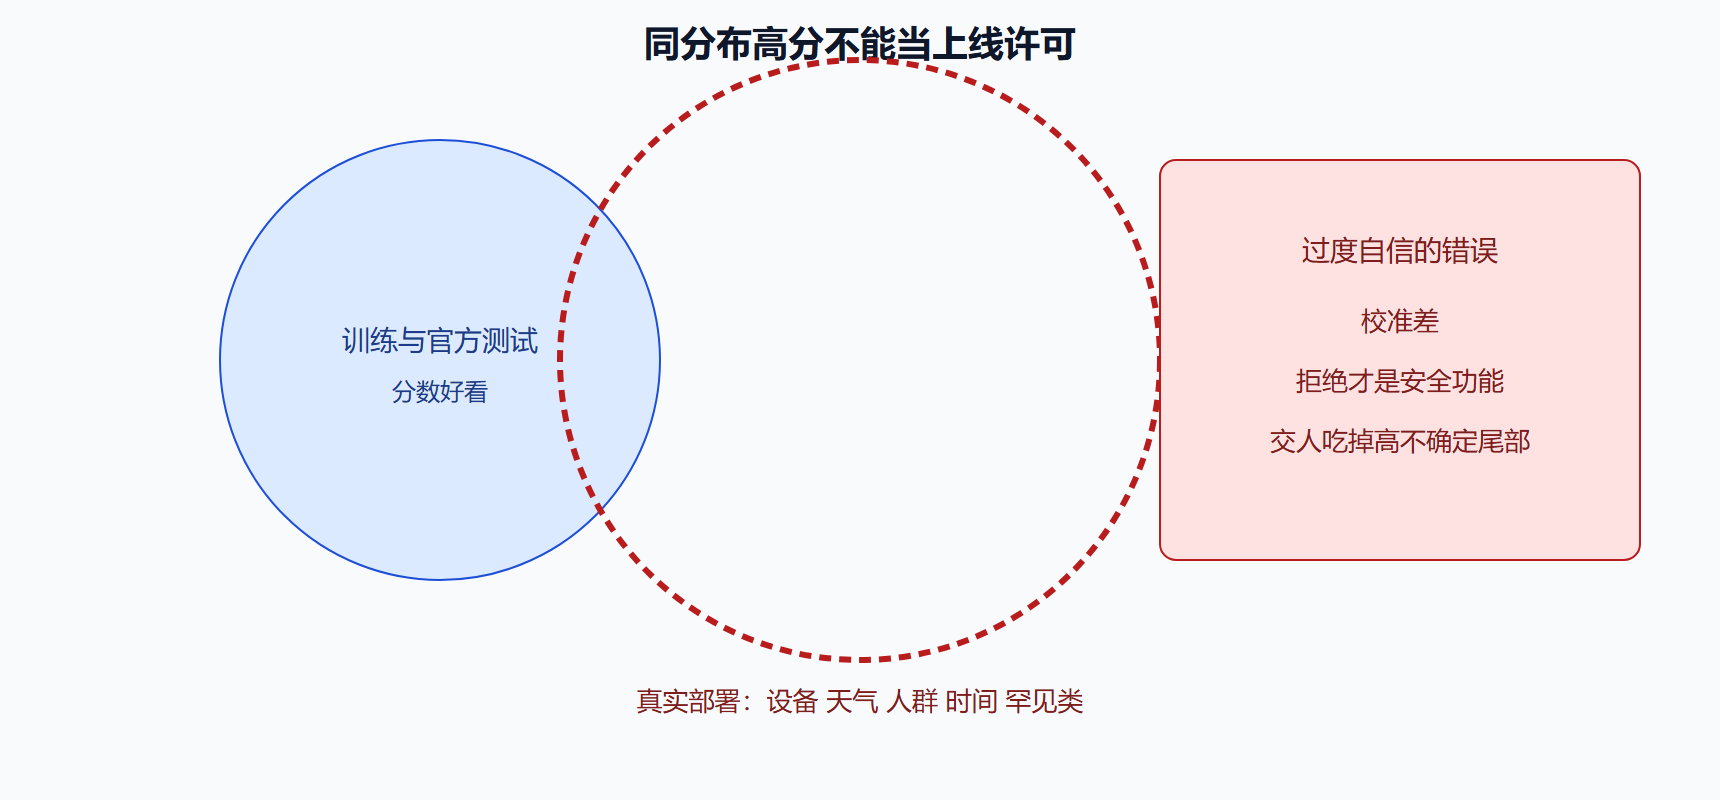
训练与官方测试往往来自同一采集协议。医院换了扫描仪、道路换成暴雨夜、客服来了新方言,输入还是「图像/音频」,统计结构已经变了。原文把鲁棒性与在未预见复杂环境中的不可预测并列:对抗是人为,偏移是自然,失效看起来却像同一件事——模型仍输出一个很像那么回事的答案。
医疗影像在罕见病变上的失效尤其典型:正类样本少,损失被多数正常病例主导,系统对稀有模式既不准又过度自信。语音识别在噪声与非标准口音上崩溃,伤害会落到本已边缘的使用群体——这与第 2 章公平切开了一条缝:泛化失败会变成歧视。
二、不确定性不是装饰性的方差数字
需要区分:认知不确定来自模型没见过;偶然不确定来自固有噪声。安全上更怕前者被当成后者——用 softmax 最大值当「把握」,深度网络却常常在偏移样本上仍然给出接近满分的概率。校准差意味着阈值策略会失效:你以为 0.9 很稳,其实只是训练域里的 0.9。
工程菜单包括:领域外检测、拒绝选项、集成或贝叶斯近似、温度校准、用人类复核吃掉高不确定尾部。没有一种能覆盖全部偏移,所以要监控生产分布:输入统计、错误投诉、切片指标是否漂移。这与第 2.3 节部署者义务直接相连。
| 现象 | 含义 | 控制 |
|---|---|---|
| 协变量偏移 | 输入分布变,标注规则 theoretically 还在 | 检测、适配、重采集 |
| 标签偏移 | 类别先验变 | 重新校准、改决策阈值 |
| 概念漂移 | 输入到标签的关系变了 | 必须重训或停用 |
| 子群体偏移 | 全局还行,某群体崩 | 公平切片 + 泛化切片一起看 |
⚠️ 常见坑:用数据增强假装覆盖了开放世界。增强能补一些天气与噪声,补不了你从未建模的新病种或新攻击面。
💡 关键直觉:安全的模型会把一部分流量标成「我不会」。永远满分的系统更像没装温度计。
不确定时的策略 if ood_score high: route_to_human if confidence uncalibrated: widen_reject_band if slice_metric drop: freeze_expansion never auto_act on irreversible high_stakes when uncertain
与对抗的分工:对抗评估回答「有人故意推你」;泛化评估回答「没人推你、世界自己走了」。两张成绩单都要。形式化验证在狭窄规范内有用,开放世界仍要监测。原文提到开发能识别并拒绝不确定或对抗输入的模型——拒绝是一等公民,不是失败。
问题:不断标注生产数据是不是就能泛化?
能缓解,也会引入反馈偏见:你只会标模型已经见到的投诉,见不到沉默的失败。需要主动抽样边缘案例、保持评估集与训练隔离、防止用测试调参把评估集训穿。
问题:大模型是不是泛化已经解决了?
覆盖面变宽,幻觉与越界仍在。开放域生成尤其会在无知时编造。高风险应用应限制工具范围,用检索把回答钉在可核对材料上,并在材料不足时拒绝。泛化不是「什么都答」,是「知道边界」。
四、校准、拒绝与生产监测要绑在一起
开放世界失效的典型样子不是报错退出,而是给出一个很自信的错答案。所以校准与拒绝必须进同一套策略:生产上监控的不只是准确率,还有置信度分布是否漂移、OOD 检测器触发率是否异常升高、人工复核改写率是否上升。后两者往往比准确率更早报警。概念漂移——输入到标签的关系变了——必须停用或重训,不能靠调阈值硬撑。子群体偏移要求公平切片与泛化切片一起看:全局还行、某口音或某皮肤类型崩了,就是 2.1 与 3.2 的交界事故。
不断标注生产数据能缓解,也会引入「只标投诉到的失败」。主动抽样边缘、保持评估集隔离、防止把测试当调参集训穿,是基本卫生。大模型覆盖面变宽,无知时仍会编造;高风险应用要把回答钉在可核对材料上,材料不足就拒绝。泛化不是什么都答,是知道边界。形式化验证在狭窄规范内有用,开放世界仍要监测——原文把拒绝不确定输入列为与对抗防御并列的能力,拒绝是一等公民。
医疗罕见病变、驾驶极端天气、客服新方言,是三类应写进评估集的「世界比训练集大」的例子。没有这些切片的优秀测试分,不能当作上线许可。把「再多标点数据」当唯一策略的团队,通常还没有威胁模型,只有采集预算。
五、偏移类型决策树、静默失效分档与「再标点数据」反例
开放世界失效的典型样子不是报错,而是很自信的错答案。先分偏移类型再选控制。协变量偏移:输入分布变、标注规则 theoretically 还在——检测、适配、重采集。标签偏移:类别先验变——重新校准、改阈值。概念漂移:输入到标签的关系变了——必须重训或停用,调阈值硬撑会把人送进不可逆流程。子群体偏移:全局还行、某口音或某皮肤类型崩——公平切片与泛化切片共用报表,这是歧视与失效的交界。校准差意味着你以为 0.9 很稳,只是训练域里的 0.9,拒绝带必须加宽。
| 失效档 | 现场类型 | 监测信号 | 反例 |
|---|---|---|---|
| 罕见类被平均 | 少见病变、少见故障 | 该类灵敏度单独地板 | 优秀全局测试分当许可 |
| 环境换了 | 暴雨夜、新扫描仪、新方言 | OOD 触发率、设备切片 | 数据增强假装覆盖开放世界 |
| 过度自信 | 偏移上 softmax 仍满分 | 置信度分布漂移 | 用最大值当把握 |
| 沉默失败 | 无人投诉的错拒 | 主动抽样边缘 | 只标客服工单 |
| 生成编造 | 材料不足仍作答 | 拒绝率、引用可核对 | 「大模型已泛化」 |
治理检查项:生产监控是否包含置信度分布、OOD 触发率、人工改写率——后两者往往比准确率更早报警;评估集是否含罕见类、极端环境、非标准口音;评估集是否与训练隔离;生成式是否在材料不足时拒绝。反例:不断标注生产数据却只标投诉到的失败;把测试集当调参集训穿;永远满分输出被当成产品优点;形式化验证覆盖狭窄规范却宣布开放世界已解决。拒绝是一等公民,产品文案要写好,以免被当成故障。
泛化门禁决策树 概念漂移 ──► 停用或重训,禁止只调阈值 子群体崩 ──► 当公平事故与安全事故同时开单 OOD 或校准差 ──► 加宽拒绝带、交人 只有同分布高分 ──► 不得作为上线许可 生成材料不足 ──► 闭嘴,不准编
下一节把失败从「看错输入」转到「目标写错了」:对齐与控制。
六、校准、拒绝与生产监测如何绑成一条策略
开放世界策略是一条链:校准差则加宽拒绝带;OOD 高则交人;切片跌则冻扩张;不可逆高风险在不确定时禁止自动执行。生产监控不只看准确率,还看置信度分布、OOD 触发率、人工改写率。后两者往往更早报警。概念漂移必须停用或重训。子群体偏移与公平切片共用报表。不断标注生产数据要搭配主动抽样边缘,否则只会标投诉到的失败。评估集隔离,防止训穿。大模型覆盖面变宽,无知时仍会编造;高风险把回答钉在可核对材料上,材料不足就拒绝。泛化不是什么都答,是知道边界。
医疗罕见病变、驾驶极端天气、客服新方言,应写进评估集。没有这些切片的优秀测试分,不能当作上线许可。「再多标点数据」只能当策略之一。拒绝选项的产品文案要写好,以免被当成故障。形式化验证在狭窄规范内有用,开放世界仍要监测。原文把拒绝不确定输入列为与对抗防御并列的能力。认知不确定被当成偶然不确定,是用 softmax 最大值当把握的典型失败。安全的模型会把一部分流量标成我不会。永远满分更像没装温度计。
与对抗的分工:一张成绩单回答有人故意推你,一张回答世界自己走了。两张都要。
拒绝文案要事先写进产品,避免值班把「我不确定」当成故障工单。校准曲线按设备与人群切片看,全局校准好、某扫描仪上崩了,仍按失效开单。评估集与训练隔离写进数据说明书,防止把测试当调参集。这三句落地,泛化才从口号变成可值班的策略。
本节要点回顾
- 同分布测试会撒谎:部署分布随设备、人群、时间而变。
- 罕见类最容易被平均掉:医疗与安全场景要单独切片。
- 泛化失败可变成不公平:口音、肤色、年龄都是偏移轴。
- softmax 不是校准过的把握:偏移上常过度自信。
- 拒绝与交人是安全功能:不是产品耻辱。
- 监控漂移是持续义务:概念漂移必须重训或停用。
- 大模型仍会在无知时编造:高风险要钉证据、要会闭嘴。
图 开放世界比测试集大
工作纸:生产监控是否包含置信度分布、OOD 触发率、人工改写率。评估集是否含罕见类、极端环境、非标准口音。概念漂移的停用条件是否写成自动触发。子群体偏移是否与公平切片共用报表。标注生产数据时有无主动抽样边缘,评估集是否隔离。生成式是否在材料不足时拒绝。把「再多标点数据」从唯一策略降级为策略之一。拒绝选项的产品文案是否已写,以免被当成故障。校准差的高置信阈值必须加宽拒绝带,不能假装 0.9 在偏移上仍稳。
下一节把失败从「看错输入」转到「目标写错了」:对齐与控制。