3.1 对抗样本与鲁棒性崩溃
3.1 对抗样本与鲁棒性崩溃
本节摘要:鲁棒性是系统在噪声、分布变化甚至蓄意扰动下仍可靠的能力。对抗攻击沿模型敏感方向加入人难以察觉的改动,使分类跨越决策边界。白盒攻击能精确算扰动,黑盒攻击靠查询或迁移。停车标志贴纸、对抗眼镜、语音里人耳难辨的指令,属于公开研究演示的威胁类型。防御以对抗训练最常用,但耗算力、常降干净精度,且与新攻击处于持续竞赛。高风险系统必须把鲁棒当成上线门槛,而不是竞赛榜附加分。
学习目标
阅读完本节,你应当能够:
- 用「高维方向上的小步累积越界」解释对抗样本,而不写可复制的攻击代码。
- 区分白盒/黑盒、有目标/无目标。
- 说明对抗训练做什么、付出什么。
- 把物理世界扰动写进自动驾驶与安防的威胁模型。
一、99% 准确率可以在几像素上倒下
标准测试集上的高分,测的是与训练同分布的干净样本。对抗样本走另一条路:在允许的扰动预算内,专门找让损失上升最快的方向。人仍看成熊猫或停车标志,模型已改口。原文强调这不是偶尔的数值噪声,而是决策边界在高维里又脆又弯,微小输入变化被层层放大后越界。
安全关键领域付不起这种脆。辅助驾驶、工业控制、恶意软件检测、内容审核,一旦被专门制作的输入骗过,伤害是物理或大规模的。因此鲁棒性与「再刷一个点的准确率」不是同一优化。
二、威胁怎么分类,决定你怎么防
白盒:攻击者知道结构与权重,可用梯度构造扰动。公开文献中的 FGSM 沿梯度符号走一步;PGD 多步投影,更强也更贵。黑盒:只看输入输出,可训练替代模型再迁移,或用查询估计方向。无目标只要判错;有目标要判成指定类,例如把限速当停车。图像之外,语音与文本同样存在:改几个词、加听不见的扰动,就能让识别或情感分类翻转——此处只说明存在性,不给配方。
模型易中招的原因,原文列了近似线性、高维空间里对抗方向多、训练数据覆盖有限、过拟合脆弱相关、缺乏因果。这些原因也解释了为什么「再收集一万张干净图」常常不够:对抗方向不在你原来的数据流形上。
| 防御 | 思路 | 代价 |
|---|---|---|
| 对抗训练 | 把对抗样本加入训练 | 算力高,干净精度常降 |
| 输入净化 | 压缩、去噪、重建 | 可被自适应攻击绕过 |
| 检测器 | 先判断是否像对抗 | 检测器自己成为新靶 |
| 随机化与集成 | 让单一扰动难同时奏效 | 延迟与成本 |
| 形式化验证 | 证明某扰动半径内标签不变 | 只适用较小模型或有限规范 |
⚠️ 常见坑:用固定攻击测一次过关就宣称「已鲁棒」。自适应攻击者会针对你的预处理与检测器重做扰动。评估必须包含自适应设定。
💡 关键直觉:对抗训练是目前相对管用的主防,它买的是更平滑的边界,账单是算力和可能更低的干净准确率。
图 干净精度与鲁棒的权衡
物理世界例子必须写清楚证据等级:标志上的对抗贴图、使人脸系统失败的奇特眼镜图案、音频对抗,都是论文与演示中出现的类型。它们要求威胁模型包含「攻击者能接触传感器输入」,不是要求教材提供制作步骤。内容审核同样会被对抗文本绕过,所以审核不能只靠单一分类器。
鲁棒门禁 clean_acc 达标 adversarial_eval 含自适应 physical_eval 若有传感器 fallback 不确定则降级或交人 retest 每次模型大版本
与 649 文集的边界:那里展开攻击算法与防御实验;这里只要求产品负责人听懂「干净分数不够」以及必须做的评估档。不要在伦理教程里贴可运行的攻击实现。
问题:检测对抗样本是不是更容易?
检测是纵深的一层,不能当唯一防线。攻击者可以把扰动做得像自然噪声,或先打检测器。拒绝回答与人工复核,往往比「再训练一个二分类器」更诚实。
四、自然扰动、投毒与「只防一种范数」
鲁棒性不只对抗样本。原文同时点了数据漂移、模糊、传感器噪声、天气等自然扰动。只在无穷范数小球里对抗训练的模型,可能对雨雾或打印失真仍然脆。安全关键感知应把自然扰动集与对抗集分开报,都过线才算。数据增强(噪声、裁剪、天气模拟)补自然侧,不能代替自适应对抗评估。正则化让边界更平滑,是便宜的辅助,不是盔甲。
投毒与后门发生在训练入口。公开爬取、众包、联邦更新都可能被植入触发器:平时表现正常,特定图案或词出现时改判。工程控制是数据来源审查、异常样本与异常更新检测、可追溯版本。这里仍然不写如何投毒。模型窃取发生在查询接口,限速与身份比权重量化更针对这条路。CW 等更强白盒攻击在专集展开;伦理课要记住的是:评估协议必须写清攻击强度,用过时弱攻击刷「已防御」是虚假保证。
物理世界演示(贴纸、眼镜、音频)要求威胁模型包含「攻击者能接触传感器前的世界」。内容审核则要假设对抗文本存在,不能只靠单一分类器。不确定就降级,比在对抗样本上硬给出标签更负责任。与 649 的分工再强调一次:算法细节去专集,门禁留在这里。
五、暴露面决策树、威胁分档与评测反例
对抗样本的产品问题不是「会不会有论文」,而是暴露面。决策树:他人能否提交输入——能,就必须有自适应评估与不确定降级。有摄像头或麦克风——加物理评估档,贴纸、眼镜、音频对抗属于公开研究演示的威胁类型,写入威胁模型,不写成某起车祸的已证原因。内容审核——假设对抗文本存在,不能只靠单一分类器。数据来自爬取或联邦——投毒与后门与对抗输入分开记账。评估协议必须写清攻击强度;用过时弱攻击刷「已防御」是虚假保证。
| 威胁档 | 证据等级 | 工程含义 | 反例 |
|---|---|---|---|
| 白盒梯度攻击 | 研究演示 | 公开权重或泄露模型时必须按最强档评 | 只测黑盒就宣称鲁棒 |
| 黑盒查询/迁移 | 研究演示 | API 暴露面要限速并评迁移 | 以为不公布权重就安全 |
| 物理扰动 | 研究演示 | 传感器系统列入攻击面 | 当段子,不进威胁模型 |
| 自然噪声天气 | 生产事实 | 与对抗集分开报 | 只在一种范数球里训练 |
| 投毒后门 | 研究+部署风险 | 入口审查与版本追溯 | 公开爬取无审查 |
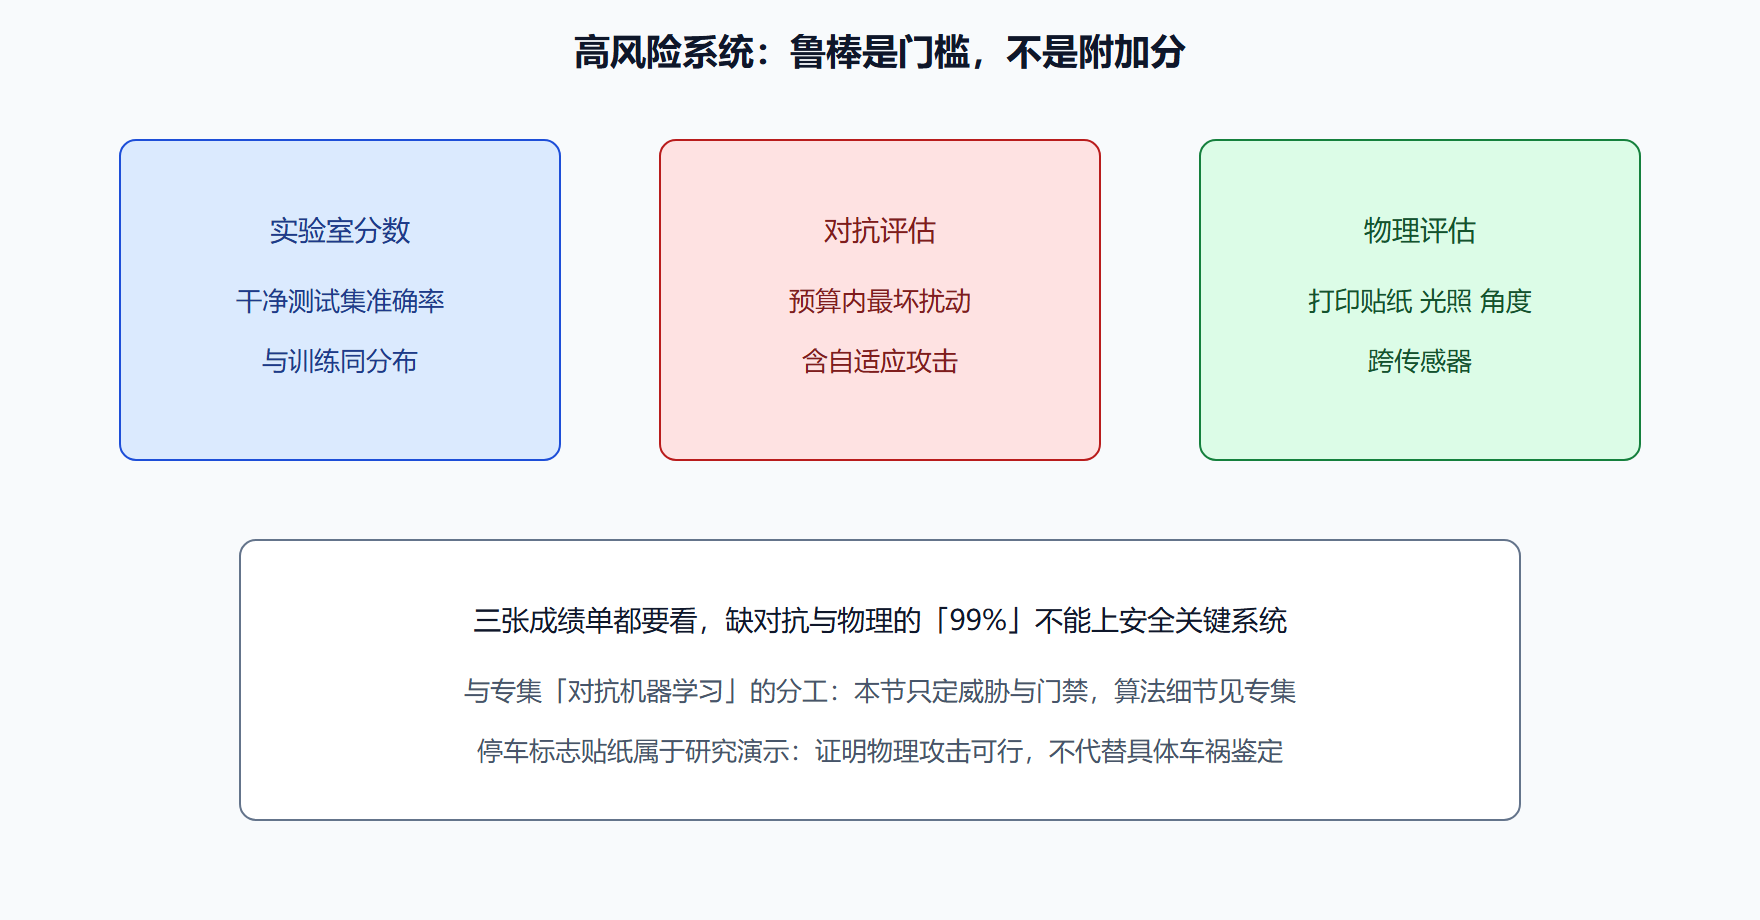
治理检查项:干净精度、对抗自适应、自然扰动三张成绩单是否都看;不确定是否降级;与专集分工是否守住——这里不提供可运行攻击实现。反例:99% 干净准确率当高风险上线理由;检测器当唯一防线;净化被自适应绕过仍宣传纵深已完成。停车标志贴纸类研究证明物理攻击可行,部署必须当攻击面。语音与文本同样存在翻转,只说明存在性,不给配方。
对抗门禁决策树 无输入暴露 ──► 仍要数据完整性,对抗训练可低优先 有输入暴露 + 伤人 ──► 自适应评估 + 对抗训练预算 + 拒绝 有传感器 ──► 物理档,研究演示进威胁模型 只用固定攻击过关 ──► 评测作废,重跑自适应 不确定 ──► 降级,禁止硬标签
下一节看没有攻击者、只是世界换了模样时,模型如何静默失效。
六、三张成绩单与物理威胁怎么写进发布门槛
高风险感知发布看三张成绩单:干净精度、自适应对抗、自然扰动。少一张不能过。物理世界演示(标志贴图、对抗眼镜、音频扰动)证据等级是研究演示,写入威胁模型,要求「攻击者能接触传感器前的世界」,教材不提供制作步骤。内容审核把对抗文本当成默认存在。投毒发生在训练入口,与测试时对抗分开:来源审查、异常样本、可追溯版本。模型窃取走查询接口,限速与身份针对这条路。CW 等更强白盒名称留给专集;伦理课记住评估协议必须写清攻击强度。
不确定就降级,比硬给错误标签更负责任。检测是纵深一层不能当唯一防线。只在一种范数球里对抗训练,雨雾或打印失真仍可能脆。数据增强补自然侧,不能代替自适应对抗评估。正则化是便宜辅助不是盔甲。与 649 分工再强调:这里只留门禁,不实现攻击。把 99% 干净准确率从高风险上线理由中删除。暴露面不允许提交输入时,对抗训练可低优先,数据完整性仍要做。
白盒用梯度、黑盒用查询或迁移,评估要覆盖你真实的暴露面。无目标只要判错,有目标要判成指定类。这些分类决定防什么,不决定在教程里复述配方。
本节要点回顾
- 干净准确率不等于鲁棒:对抗沿敏感方向越界。
- 白盒用梯度,黑盒用查询或迁移:评估要覆盖你真实的暴露面。
- 物理扰动已证明可行:传感器系统必须列入威胁模型。
- 对抗训练是主防之一:账单是算力与精度权衡。
- 固定攻击评测会自欺:需要自适应评估。
- 不确定就降级:比硬给出错误标签更安全。
- 本教程不提供攻击配方:机制与门禁即可。
工作纸:暴露面是否允许他人提交输入。有则必须有自适应对抗评估与不确定降级。有传感器则加物理评估档。对抗训练是否在预算内,干净精度下降是否被业务书面接受。数据入口是否审查投毒,API 是否限速。评估协议写清攻击强度,禁止用最弱攻击刷海报。与专集分工:这里只留门禁,不实现攻击。自然扰动集与对抗集分开报。内容审核假设对抗文本存在。把「99% 干净准确率」从高风险上线理由中删除,三张成绩单都看。
下一节看没有攻击者、只是世界换了模样时,模型如何静默失效。