1.1 从演示到生产:AI项目为何需要落地成色审计
1.1 从演示到生产:AI项目为何需要落地成色审计
落地成色审计:对已公开的AI应用案例,按统一框架核对其问题真实性、技术匹配度、数据可持续性、成本结构与退场机制,判断其价值成色的方法。本节讲清为什么需要这么一套流程。
一条裂缝的故事
2016年前后,几乎所有行业会议上都有让人惊艳的AI演示:实时识别皮肤病变、自动撰写财报摘要、预测设备故障到小时级。三年后回看,其中相当一部分演示再也没有变成生产系统。裂缝出在哪里?一家做工业质检的供应商私下总结得很直白:演示集是精心挑选的两百张图,产线每天流过的是两万张光照各异、油污遮挡的实物。演示衡量的是模型上限,生产衡量的是模型下限,而业务承受的是下限。
这解释了本教程的基本立场:读案例时先问"这个数字是在哪个集上测的"。是实验室集、灰度集,还是全量生产环境?对照基线是什么——是和随机猜比、和旧规则比,还是和熟练人工比?这三个问题不弄清,任何"准确率百分之九十几"都没有审计意义。
裂缝的三个来源
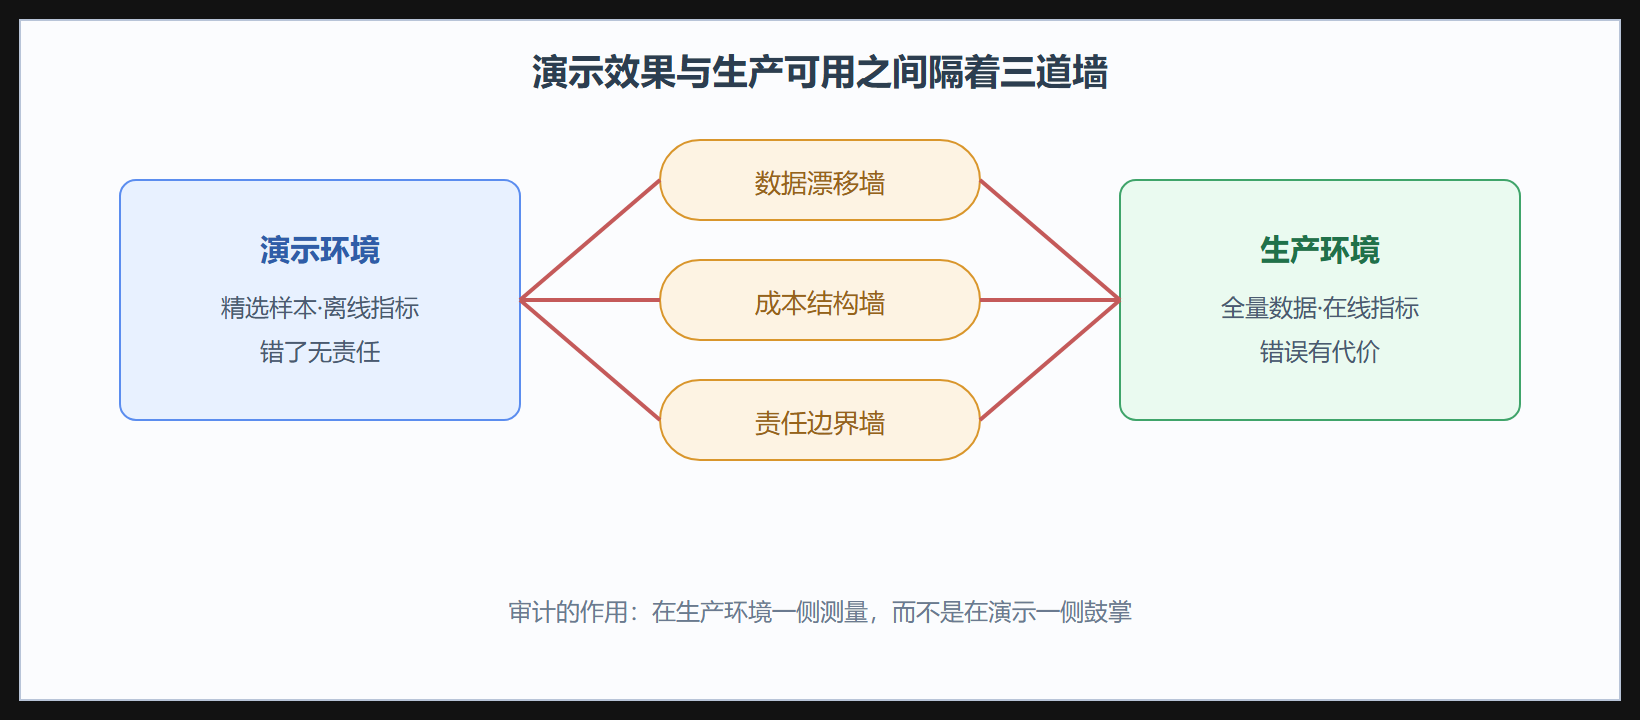
第一是数据漂移。训练数据是历史快照,业务世界持续移动:客群在变、设备在老化、渠道在换。模型上线那一刻就是它开始过时的那一刻。第二是成本结构反转。演示阶段算力与标注成本可以忽略,生产阶段它们变成月度固定支出,很多项目死于"模型还不错但养不起"。第三是责任边界。演示错了没人负责,生产错了要有明确的责任归属——医疗、金融尤其如此,这往往比精度更早地决定项目生死。
图:演示与生产之间的三道墙
用代码看清"上限与下限"
用一个可运行的例子体会演示集与生产集的差别。我们构造一个简单分类器,观察它在"干净演示集"与"漂移生产集"上的表现落差。
import random random.seed(7) def make_data(n, noise, defective_rate=0.05): """模拟质检特征:正常品与缺陷品在特征空间里部分重叠。 noise 越大,重叠越严重,模拟产线环境恶化。""" data, labels = [], [] for _ in range(n): if random.random() < defective_rate: x = random.gauss(0.55, 0.12 + noise) # 缺陷品 y = 1 else: x = random.gauss(0.30, 0.10 + noise) # 正常品 y = 0 data.append(min(max(x, 0.0), 1.0)) labels.append(y) return data, labels # 规则分类器:阈值判断,代表最朴素的基线 def rule_predict(x, threshold=0.45): return 1 if x > threshold else 0 def evaluate(data, labels): hits = sum(1 for x, y in zip(data, labels) if rule_predict(x) == y) return hits / len(labels) demo_x, demo_y = make_data(500, noise=0.00) # 演示集:干净 prod_x, prod_y = make_data(500, noise=0.10) # 生产集:漂移 print("演示集准确率: %.3f" % evaluate(demo_x, demo_y)) print("生产集准确率: %.3f" % evaluate(prod_x, prod_y)) # 典型输出:演示集 0.95 左右,生产集掉到 0.85 上下
再算一笔误报账,看看"准确率下降五个点"在业务上意味着什么。
def cost_of_errors(data, labels, fp_cost=1, fn_cost=20): """fp: 误报(好品被拦下);fn: 漏检(缺陷品流出)。 在质检场景,漏检一台不良品的代价远高于误报。""" fp = fn = 0 for x, y in zip(data, labels): p = rule_predict(x) if p == 1 and y == 0: fp += 1 if p == 0 and y == 1: fn += 1 return fp * fp_cost + fn * fn_cost print("生产集错误代价: %d 元" % cost_of_errors(prod_x, prod_y)) # 把 fn_cost 从 20 调到 200 再跑一次,观察代价结构如何反转 # 你会发现:同一套阈值,换一个代价假设,最优决策完全不同
这个例子是全册的微缩模型:精度只是技术指标,代价结构才是业务指标。审计要核对的永远是后者。
解读与变式
背景(行业演示普遍高光)、操作(对比两个分布的评估)、结果(五个点的精度落差放大为数十倍代价差)都有了。变式:把同样的分析搬到信贷场景,fp 变成"拒了一个好客户",fn 变成"放款给坏客户",结论一样成立——这就是第2章金融案例要展开的。本节承上启下:它定义了审计的动机,1.2节将给出审计的第一件工具,技术选型阶梯。
一个补充实验:把漂移画出来
上面的模拟只给了一个时间截面,更直观的做法是把漂移当作时间过程来观察。把生产集的噪声从零逐步加到零点二,每一步记录一次准确率,会看到一条缓慢下滑的曲线——它不是断崖,而是一个月一个月悄悄发生的斜坡。这正是漂移危险的地方:没有任何一天的数据看起来"明显不对",但半年后模型已经站在坡底。生产环境的监控因此不能只看输入是否异常,要同时看输出分布(拦截率、报警率、各类占比)是否缓慢移动。拦截率每月涨一个百分点,一年就是十二个点,而每一点的背后都是真金白银的误报代价。把这条斜坡画在项目周报里,是审计师给业务方最有效的一次科普。
演示与生产的第三种状态
补一个容易被忽略的中间态:试点。试点介于两者之间——有小规模真实数据,但没有全量的成本压力与责任压力。不少项目的错误是把试点的成绩直接外推到全量,忽略了试点往往有最好的资源(骨干员工盯守、优先的数据支持、宽容的容错)。审计用语里这叫资源溢价:试点成绩减去资源溢价,才接近全量的真实预期。溢价有多少没有通用数字,但问一句"试点是谁在盯、全量后还有没有人盯",答案通常就在那里。