1.2 核心技术分类与选型逻辑
1.2 核心技术分类与选型逻辑
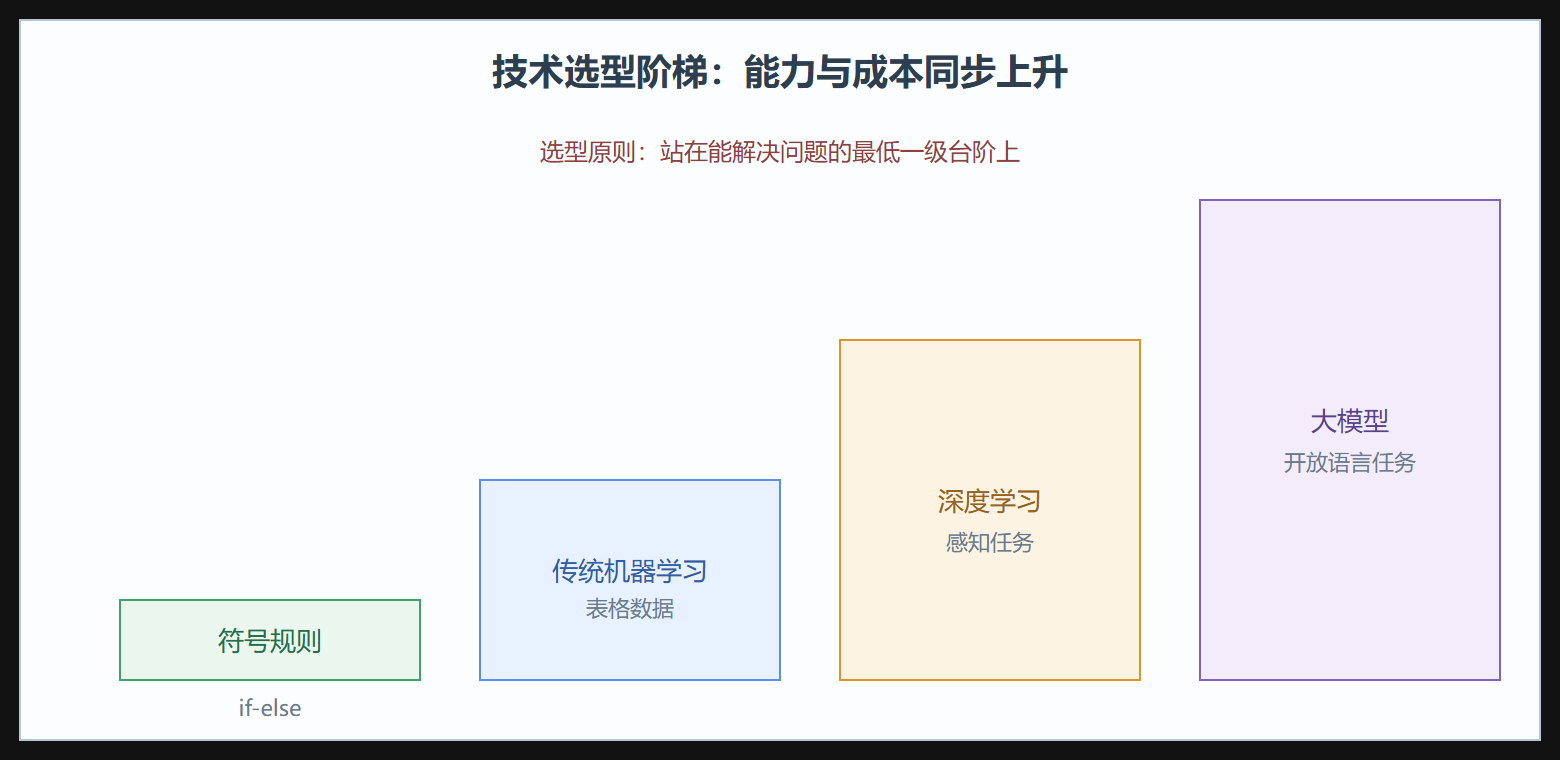
AI技术选型阶梯:把符号规则、传统机器学习、深度学习、大模型视为一条能力与成本同步递增的阶梯,选型目标是让方案所在台阶尽量贴近问题复杂度,宁低勿高。本节给出这条阶梯及配套的判断方法。
回到第1章开头的连锁药店。会员复购预测这个需求提出来后,供应商开出的方案是"大模型驱动的智能营销中台"。审计介入后问的第一个问题是:你们的复购规律,一条SQL加三个业务规则能解释多少?答案接近八成。于是选型结论变成:先用规则引擎上线,把大模型预算留给规则解释不了的那两成长尾。半年后复盘,这个决定省下的不只是钱——规则系统每个判断都可解释,投诉处理有据可依。
阶梯的四级
第一级是符号规则:人工总结的if-else逻辑。可解释、零训练成本、出错可追责,但无法处理高维模糊模式。第二级是传统机器学习:决策树、逻辑回归、梯度提升这类模型,吃结构化表格数据,样本量在万级即可工作,特征工程决定上限。第三级是深度学习:处理图像、语音、文本等非结构化数据的默认选择,代价是数据量、算力与调试难度。第四级是大模型:通用语言能力与少量样本适应能力,代价是推理成本、幻觉风险与行为不可完全控制。
| 台阶 | 适用问题 | 数据要求 | 典型成本 | 可解释性 |
|---|---|---|---|---|
| 符号规则 | 边界清晰的业务逻辑 | 无需训练 | 极低 | 完全 |
| 传统机器学习 | 结构化数据预测 | 万级标注样本 | 低 | 中等 |
| 深度学习 | 图像语音文本感知 | 十万级样本 | 中高 | 弱 |
| 大模型 | 开放语言任务、小样本适应 | 提示或少样本 | 推理持续支出 | 弱且不稳定 |
审计视角下,选型过高的代价常被低估:系统复杂度、运维技能要求、人员依赖都随台阶上升。选型过低倒是容易被发现并补救。
图:选型阶梯
用代码比较两级台阶
下面这个可运行实验对比规则与机器学习在同一任务上的表现,体会"什么时候值得上一级台阶"。
import random, math random.seed(42) def gen_customers(n): """生成会员数据:访问频次、客单价、距上次购买天数。 复购与否由一个带噪声的非线性关系决定。""" rows = [] for _ in range(n): visits = random.randint(1, 15) basket = round(random.uniform(30, 400), 1) recency = random.randint(1, 90) score = 0.05*visits + math.log(basket)/5 - recency/40 + random.gauss(0, 0.25) repurchase = 1 if score > 0.15 else 0 rows.append((visits, basket, recency, repurchase)) return rows train, test = gen_customers(4000), gen_customers(1000) # 一级台阶:人工规则 def rule(v): visits, basket, recency, _ = v return 1 if (visits >= 5 and recency <= 30) or basket >= 350 else 0 acc_rule = sum(1 for v in test if rule(v) == v[3]) / len(test) print("规则准确率: %.3f" % acc_rule) # 二级台阶:简单的最近邻思想 + 手写特征加权(不依赖第三方库) def feat(v): visits, basket, recency, _ = v return (visits/15.0, basket/400.0, 1 - recency/90.0) def knn_predict(x, k=25): dists = sorted(train, key=lambda t: sum((a-b)**2 for a, b in zip(feat(t), feat(x)))) votes = sum(t[3] for t in dists[:k]) return 1 if votes * 2 > k else 0 acc_knn = sum(1 for v in test if knn_predict(v) == v[3]) / len(test) print("机器学习准确率: %.3f" % acc_knn) # 典型输出:规则 0.85 上下,kNN 0.90 上下——提升存在但需权衡复杂度
提升是真实的,但要接着算增量价值:准确率五个点在药店的会员池规模下折合多少额外复购收入,是否覆盖开发与维护成本。这就是"贴近问题复杂度"的算术形式。
# 增量价值速算:假设会员池 2 万人,复购客单 120 元 members, basket_value = 20000, 120 gain = (acc_knn - acc_rule) * members * basket_value * 0.10 # 仅一成被触发营销 annual_dev_cost = 60000 # 年化开发与运维 print("年增量毛收入约: %.0f 元" % (gain - annual_dev_cost)) # 把 0.10(营销转化率)改为 0.03 再跑:结论可能反转,这正是审计要追问的敏感参数
解读与变式
药店案例的完整链路:背景是供应商推动的高台阶方案;操作是用规则基线量化"低台阶能吃掉多少";结果是方案降级、成本可控;解读为"选型是经济决策而非技术审美";变式是当业务规则本身频繁变动、无法固化时,低台阶会失效,此时上移一级才是对的。下一节把镜头对准账本:阶梯选对之后,钱怎么算清楚。
选型阶梯的一个反例
为防止阶梯被读成教条,给一个反例:票据OCR场景,规则时代用模板匹配,后来深度学习全面替代,如今大模型又在部分环节替代深度学习——三层技术同时活着,各自处理不同版式的票据。这个反例说明阶梯不是时间表,而是成本坐标:任何一层只要它对当前问题复杂度是最经济的,它就是对的。审计时看到"落后"的技术不必扣分,看到"先进"的技术反而要多问一句成本。供应商方案书里最贵的那个选项,往往出现在客户最不懂的那个环节——这是选型谈判的博弈常识。
再多说一句关于"降级"的体面:项目中途从大模型降回规则或小模型,不叫失败,叫纠偏。审计档案里记录过不止一个这样的案例,降级后成本降了一个量级、指标几乎没变,团队却始终不愿声张——因为降级在组织叙事里总被当成认输。好的审计文化会把"及时降级"列为正面事件写进年报。选型阶梯真正的敌人不是技术误判,是这种不敢降级的叙事压力。