3.3 交通与物流:调度与路径优化
3.3 交通与物流:调度与路径优化
物流AI的核心问题是在庞大的可能性空间里给出足够好的调度与路径方案,并预测哪里会延误。本节审计它的成色:组合爆炸为什么让精确求解退场、学习式方法在调度里的真实位置、延误预测业务化的前提。
十辆车能有多少种排法
一个配送站十辆车、四十个点位,问"怎么排路线最省"。看似朴素,它的可能性数量是天文级的:四十个点位的排列本身已超过可枚举的规模,再把时间窗、车辆载重、司机工时约束叠上去,精确求解在计算上不可行——这是调度问题的一块硬天花板。所以物流行业的主流方案从来不是"算出最优解",而是启发式加局部搜索:先贪心构造一个可行解,再不断交换、搬移、逆转片段来改良。审计调度类AI项目,第一个要识别的宣传水分就是"最优"两个字——多数场景里只能说"比人工排单好百分之几",不能说最优。
import random from itertools import permutations def route_length(route, dist): return sum(dist[route[i]][route[i+1]] for i in range(len(route)-1)) random.seed(41) N = 8 # 8 个点位已经很能说明问题 dist = [[0 if i == j else random.randint(5, 60) for j in range(N)] for i in range(N)] # 精确法:枚举所有排列(8 点位 = 5040 种;20 点位就是天文数字) best = min(permutations(range(1, N)), key=lambda r: route_length((0,) + r + (0,), dist)) exact = route_length((0,) + best + (0,), dist) # 启发式:最近邻构造 + 2-opt 局部改良 def nn_route(): un, route = set(range(1, N)), [0] while un: nxt = min(un, key=lambda j: dist[route[-1]][j]) route.append(nxt); un.discard(nxt) return route + [0] def two_opt(route): improved = True while improved: improved = False for i in range(1, len(route)-2): for j in range(i+1, len(route)-1): new = route[:i] + route[i:j+1][::-1] + route[j+1:] if route_length(new, dist) < route_length(route, dist): route, improved = new, True return route heur = route_length(two_opt(nn_route()), dist) print("精确最优: %d | 启发式: %d | 差距 %.1f%%" % (exact, heur, (heur-exact)/exact*100)) # 典型输出:差距在 0%~5% 之间。点位稍多,精确法直接算不动, # 而启发式几毫秒出解——这就是"放弃最优换取可解"的工程取舍。
这段代码跑出来的差距,就是调度AI的成色来源:不是碾压最优,而是以可接受的计算成本稳定逼近最优,并且能秒级响应临时插单——人工排单做不到的正是响应速度。
学习式方法的位置
机器学习在调度里不是替代优化器,而是给它喂更好的输入。三个典型位置:预测各路段的行驶时间(给优化器更真实的距离矩阵)、预测各点位的服务时长(让时间窗约束不虚)、预测订单量来预排运力。把"学"和"优"分层,各干各的,是落地项目里最稳的架构;反过来想用一个大网络端到端直接输出路线的方案,在审计里见过多次,效果都不稳定——因为约束满足这件事,网络不擅长。
def eta_with_traffic(base_minutes, hour): """示意:用历史统计给距离矩阵加时段系数——学习式方法的最小形态。""" peak_factor = {8: 1.6, 9: 1.4, 18: 1.7, 19: 1.5} # 高峰时段表 return round(base_minutes * peak_factor.get(hour, 1.0), 1) for h in (10, 8, 18): print("%d 点出发:30 分钟基础路段 -> 预计 %.1f 分钟" % (h, eta_with_traffic(30, h))) # 同一段路,出发时间不同 ETA 完全不同。 # 优化器拿到的距离矩阵若不含时段因素,排出的路线高峰期必然失真。
延误预测的业务化前提
另一个常见提案是"延误预测":预测某票货会晚点,提前触发应对。技术上不难做到七成准确,难的是业务化——预报了之后系统能做什么:改派车辆?通知客户?调整承诺时效?如果预报之后没有任何联动动作,这个预测就是一张没有行动力的报表。审计这类项目的关键问句是"预测结果接到哪个流程上、谁负责响应",接不上的项目,模型再准也只是成本。
图:调度系统里"学"与"优"的分层架构
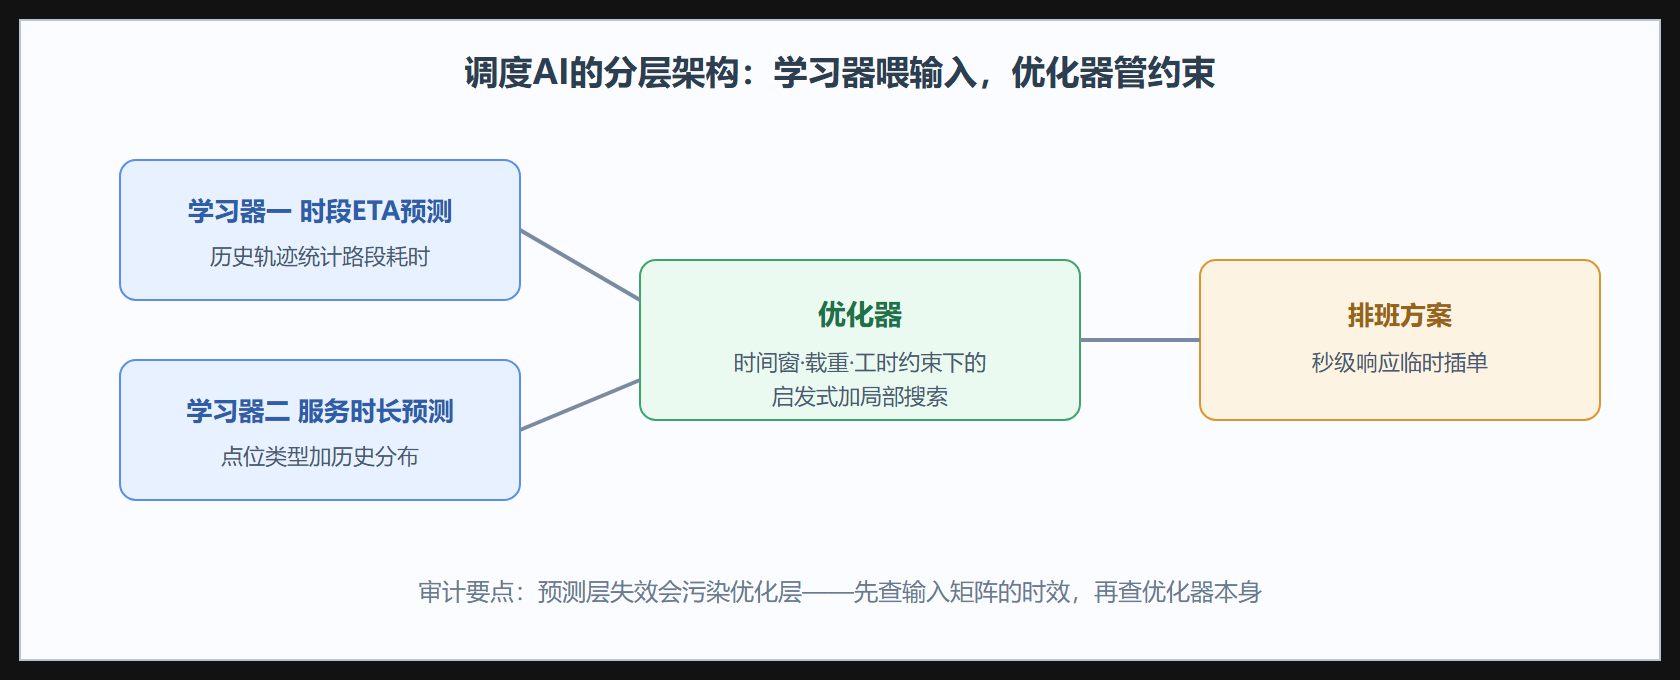
这张分层图也是排错路线图:路线整体失真时先查学习器给的ETA矩阵是否过期(高峰系数没更新是最常见病因),再查优化器的约束配置;而个别司机端异常,多半在执行层而非算法层。分层架构的价值就在这里——每一层的病灶有各自的症状。
结果、解读与变式
背景(十辆车的天文级排法)、操作(精确与启发式的对照、时段矩阵、延误联动检查)、结果(可解性换最优性的取舍量化)齐全。解读:物流AI的成色在于"优化器管约束、学习器管输入"的分工清晰,以及预测必有下游动作。变式:网约车派单、外卖调度(此处指即时配送运力调度这类组合优化问题)、港口泊位分配、航班机组排班都是同构的组合优化现场,审计方法原样可用。下一节走向数据最稀疏的现场——农田。
补充一个常被问到的边界问题:实时重排的频率。调度不是排一次管一天,订单在途插入、车辆抛锚、路况突变都会触发重排。重排有成本——司机刚收到的路线立即作废会引发混乱与抵触——所以成熟系统的做法是分层重排:小扰动在车组内局部调整,大扰动才全网重排,且给司机端留一个变更确认的缓冲。审计调度系统时,重排频率与司机端的变更体验是被技术评审最容易漏掉、却被一线抱怨最多的一环。