3.4 农业:产量预测与精准种植
3.4 农业:产量预测与精准种植
农业AI指用卫星与无人机影像、土壤传感和历史气象数据辅助产量预测、病虫害识别与变量施药的软件系统。本节审计它在数据最稀疏、环境最恶劣的现场里还能剩下多少成色。
一年只有一个生长季
农业AI的所有限制都来自一个物理事实:一年只有一个生长季。别的行业数据按天回流,农业的标签按年回流——一块田今年的产量标签,要等到收获才有。这意味着模型验证一轮要一年,三年的数据积累在农业里只是三个样本点。审计农业AI项目,先看它宣称用了几年、几个地块的数据;三年以下的数据训练出的模型谈"精准",成色存疑。
第二个限制是环境恶劣。实验室里九成五的病虫害识别模型,装到植保无人机上会遇到反光、露水、药雾遮挡、不同机型相机色偏;田间网络不稳,推理要跑在边缘设备上。部署环境的每一项都在侵蚀实验室指标。
import random random.seed(52) def field_accuracy(lab_accuracy=0.95, glare=0.04, dew=0.03, camera_shift=0.02, edge_compute=0.01): """示意:实验室精度逐项折损到田间。""" a = lab_accuracy a *= (1 - glare) # 强反光误判 a *= (1 - dew) # 叶面露水遮挡病斑 a *= (1 - camera_shift) # 相机色偏导致分布偏移 a *= (1 - edge_compute) # 边缘端模型压缩的精度损失 return a print("实验室精度 95.0%% -> 田间估计 %.1f%%" % (field_accuracy() * 100)) print("阴天反光加重时 -> 田间估计 %.1f%%" % (field_accuracy(glare=0.08) * 100)) # 五个百分点的折损听着不致命,但别忘了第2.2节的教训: # 患病率低的场景里,几个点就足以击穿阳性预测值。
变量施药的经济学
精准种植的明星应用是变量施药:按地块的杂草密度差异,控制喷头逐行调节药量。它的成色要从农资账上核:节省的农药钱减去系统加装成本(视觉模块、变量泵、调试),再除以作物亩产值的基数。经济作物(果园、蔬菜)亩产值高、用药量大,回收期普遍可行;大田粮食作物亩利润薄,同一套硬件三年回不了本。同一个技术,换个作物成色天差地别——这是第3.5节毛利显微镜的预演。
def vra_payback(acres=500, chem_cost_per_acre=120, save_rate=0.30, hardware=180000, annual_service=15000): """变量施药回收期:节省药费 vs 硬件加服务费。""" annual_saving = acres * chem_cost_per_acre * save_rate net = annual_saving - annual_service if net <= 0: return None return hardware / net for crop, acres, chem in [("经济作物(果园)", 500, 400), ("大田(粮食)", 2000, 80)]: y = vra_payback(acres=acres, chem_cost_per_acre=chem) if y: print("%s: 回收期约 %.1f 年" % (crop, y)) else: print("%s: 年节省不抵服务费,无回收期可言" % crop) # 典型输出:果园 1~2 年回本,大田 5 年以上甚至无解。 # 决定成色的不是识别算法,是作物经济结构。
产量预测的诚实口径
卫星影像加气象数据做县级产量预测,精度可以做到相当好;做到地块级立刻变难;做到"帮某个农户决定今年种什么"则基本超出当前能力边界——决定种什么的变量太多(行情、轮作、劳力、补贴),产量模型只覆盖其中一角。审计产量预测时核对预测粒度和验证口径:是县级 aggregates 的回测,还是地块级的留出验证?前者漂亮但用途有限(适合收储和保险定价),后者才是种植决策需要的。
图:农业AI的约束漏斗
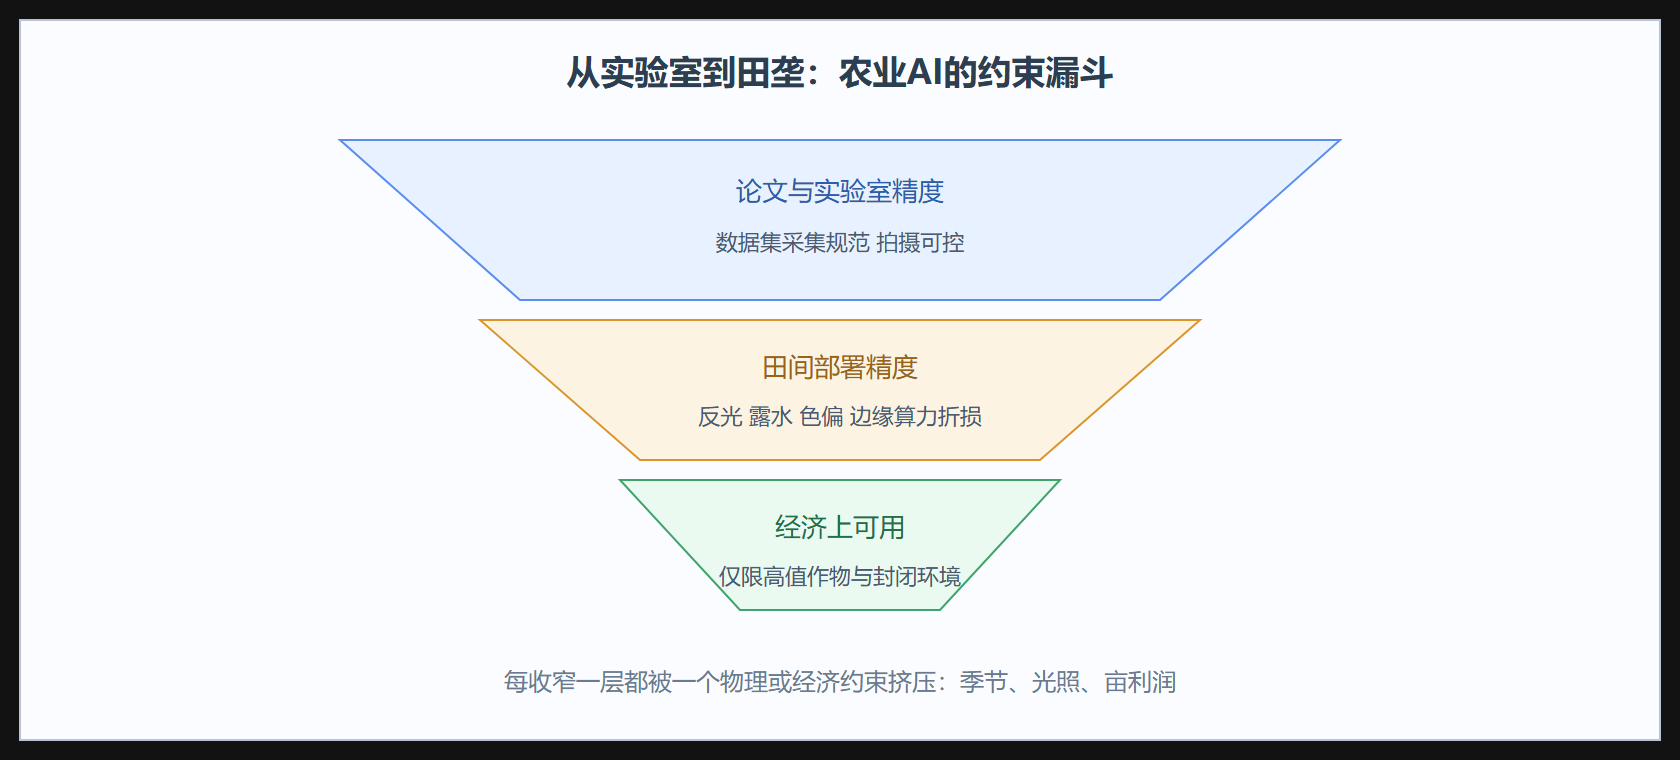
漏斗的三层对应三个审计问题:项目方报的是哪一层的精度;从第一层到第二层的折损有没有实测数据;第三层的经济核算做没做。三层问题问完,一个农业AI项目的真实成色基本就摸清了——多数宣传材料只展示漏斗最宽的那一层。
结果、解读与变式
背景(一年一季的物理约束)、操作(精度折损链、施药经济学、预测粒度核对)、结果(作物经济结构决定回收期)完整。解读:农业AI的成色底线由数据回流速度和亩均利润共同封顶,诚实的项目会把"县级预测、经济作物优先"写在第一页。变式:水产养殖的溶氧预测、畜牧的体征监测、温室的环境调控是同构场景,其中温室因为环境可控、数据回流快,反而是农业里成色最好的现场——封闭环境战胜了季节约束。下一节把四个现场放到毛利显微镜下做横向复盘。
农业AI的第三条路:绕开标签
除了等一年的田间标签,还有一条绕行路线:用模拟与迁移减轻标签饥渴。作物生长模型(农学领域积累的机理方程)可以生成大量仿真数据,让模型先在仿真里学个大概,再用少量真实田块数据微调;不同作物之间也可以迁移共享底层特征(叶片形态、行距纹理)。这类混合路线在公开研究里已有效果,但审计口径要清醒:仿真与迁移都引入了域差,微调集的真实数据量仍然决定最终成色的下限。把它当作省标签的手段可以,当作无标签的替代不行——农业的物理约束不讲情面,这一点在评审任何"少量数据解决大问题"的农业方案时都值得重复一遍。
政策变量的位置
最后记一个非技术但权重极高的变量:补贴。农机购置补贴、智慧农业试点专项会直接改变3.4节那笔回收期账的分子或分母——硬件成本被补贴覆盖后,原本五年回本的大田方案可能两年就达标。审计农业项目要问清账期内的补贴政策与到位概率,这不是取巧,是行业现实。反过来也要警惕为拿补贴而上马的项目:补贴到期之日往往就是系统停用之时,审计报告里应标注项目的"补贴依赖度"。
补一句关于部署形态的观察:农业AI的硬件迭代周期与作物周期错位,也影响成色。摄像头与传感设备装在露天,三年一换;作物一季一茬;而算法模型随数据每季更新。三种周期纠缠的结果是系统任何时刻都由"不同代际的部件"拼成,兼容性维护成为常态。采购时选模块化可更换的硬件方案、避免整机绑死一家供应商,是比挑选算法更能延长项目寿命的决策。