4.2 能源与公用事业:负荷预测与故障预警
4.2 能源与公用事业:负荷预测与故障预警
能源AI的两大支柱是电力负荷预测(未来一小时、一天、一周要用电多少)与设备故障预警(变压器、输电线路的异常提前发现)。本节审计它的成色:预测误差如何被备用容量兜住、极端天气天的模型失灵、以及故障预警为什么依赖巡检数据的数字化程度。
系统里最老的AI,反而最稳
行业内部有个反共识的观察:负荷预测是AI在电力系统里最老的应用,从统计模型时代就用了几十年,反而是全册审计过的行业应用里成色最稳的一类。原因值得写进笔记:第一,数据回流快——每小时一个真实标签,模型每天都有对答案的机会;第二,误差有兜底——电网本来就要预留旋转备用容量,预测偏差在一定范围内是系统设计消化掉的成本,不是事故;第三,基线成熟——任何新模型都要先和"去年同期加温度修正"这条朴素基线比,赢不了就不上线。数据闭环、容错冗余、诚实基线,三条恰好是前面各章反复强调的成色要素。
但"稳"不等于没有审计点。负荷预测的失灵集中在极端天气日:寒潮热浪这种负荷形态百年一遇的日子,训练数据里几乎没见过,模型的误差会成倍放大。而这些天恰恰是电网最紧张、最输不起的日子。审计时要专门看极端日的表现分桶报告,而不是全年平均误差。
import random random.seed(71) def simulate_forecast(days=365): """示意:全年平均误差漂亮,极端日误差翻倍。""" errors = [] for d in range(days): extreme = random.random() < 0.03 # 约 3% 的极端天气日 if extreme: errors.append(random.gauss(0.09, 0.04)) else: errors.append(random.gauss(0.025, 0.01)) return errors def report(errors, threshold=0.06): overall = sum(abs(e) for e in errors) / len(errors) extreme = [abs(e) for e in errors if e > threshold or e < -threshold * 1.5] print("全年平均绝对误差: %.1f%%" % (overall * 100)) print("风险日误差样本均值: %.1f%%" % (sum(extreme)/max(len(extreme),1) * 100)) report(simulate_forecast()) # 全年平均 3% 左右,好看;但风险日的误差可能到 9% 以上。 # 备用容量按 3% 配的日子撞上 9% 的误差,就要动用昂贵的应急手段了。
备用容量的经济学
负荷预测的价值换算链在这里格外清晰:预测更准 → 备用容量留得更少 → 省下的是备用机组的启停成本和现货市场的溢价采购。这条链反过来定义了精度需求——备用容量物理上就有下限(安全约束),预测精度超过某个阈值后边际价值骤减。所以能源行业对预测精度的追求是台阶式的:够到下一个容量档位就有一次跳变收益,够不到就是白费功夫。审计时问一句"当前精度对应的备用策略是哪一档、下一档差多远",比笼统追求再降一个百分点误差务实得多。
def reserve_policy(mape): """示意:误差区间映射到不同的备用策略与成本档。""" if mape < 0.02: return ("最小备用 + 现货灵活采购", 100) elif mape < 0.04: return ("常规旋转备用", 160) else: return ("保守备用加协议应急", 240) for mape in (0.015, 0.03, 0.05): policy, cost = reserve_policy(mape) print("误差 %.1f%% -> %s,日成本指数 %d" % (mape*100, policy, cost)) # 从 3% 到 1.5% 的精度提升跨了一个成本档,值得投入; # 从 1.5% 再往下抠,成本档不变,收益归零——精度投资有明确的停止点。
故障预警:数字化的巡逻队
输电线路与变压器的故障预警,技术上与3.2节预测性维护同构,但电力行业多出两样东西:巡检数据的长期积累(红外测温、局放检测的历史记录),和分级的调度响应体系(预警能联动负荷转供)。这两样恰好补上了预测性维护三种死法里的"组织"一环——预报有人接、有动作。反过来,配电网末端的故障预警常常卡在数字化程度:老旧台区没有传感器,模型无从谈起。审计能源AI项目的第一问因此不是算法,而是"目标设备的感知覆盖率是多少"。
图:预测误差与备用容量的对冲关系
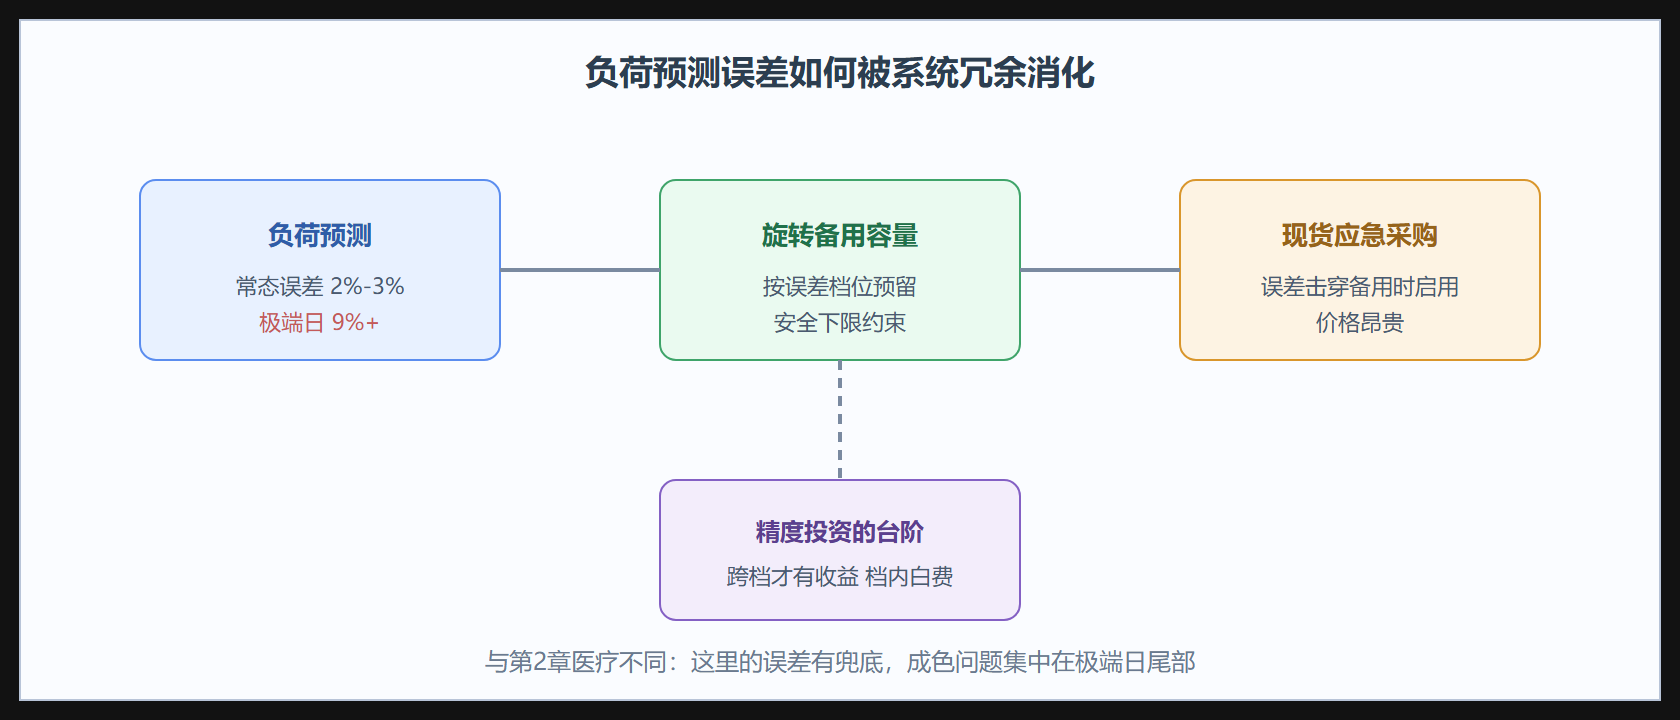
这张对冲图解释了能源AI的从容:常态误差进备用、极端误差进现货,两层缓冲把模型缺陷隔离在财务层。对照第2章医疗影像——那里的误差直接落在患者身上,没有任何缓冲层——就能理解为什么同样的预测精度,在两个行业换来的信任完全不同。审计任何预测系统的第一件事,就是画出它的误差缓冲图:误差发生后第一站落到哪里,那里有没有设计好的吸收结构。
结果、解读与变式
背景(最老反而最稳)、操作(极端日分桶、备用档位换算)、结果(精度投资的台阶结构)完整。解读:能源AI展示了"容错冗余加快速回流"的理想组合,也展示了平均指标掩盖尾部风险的经典陷阱。变式:水务的管网漏损预测、燃气的用气量预测、热网的按需供热是同构场景;智慧供热尤其值得留意——它的回报直接写在燃料账上,是公用事业里回收期最短的AI现场之一。下一节进入被生成式AI搅动最剧烈的行业:媒体。
再补一个新能源带来的变局:分布式光伏让负荷预测变成双向问题。屋顶光伏接入后,电网要预测的不再只是"用户用多少电",还有"用户的光伏板会发多少电"——后者依赖天气预报的精度,误差直接叠加进净负荷。光伏渗透率高的地区,净负荷曲线在午后出现深谷、傍晚出现陡峭爬坡(业内称鸭子曲线),预测难度和调峰压力同步上升。审计新能源占比高的电网AI项目时,天气数据管道的质量权重要显著上调:一个温度预报偏差两度的寒潮日,足以让最好的负荷模型失去意义。