4.3 媒体与娱乐:内容生成与推荐
4.3 媒体与娱乐:内容生成与推荐
媒体AI的两大引擎是内容生成(稿件初稿、标题、配图、视频剪辑)与个性化分发(信息流推荐)。本节审计生成与推荐合流之后的成色:产能过剩时代的注意力经济学、信息茧房的可度量口径、以及内容标识义务落地。
编辑部的夜班减了一半
一家数字媒体的内容中台,两年前夜班编辑十二人,现在五人加一套生成流水线:热点事件触发,模型十分钟出二十个标题候选和三版导语,编辑挑改后发布,点击数据半小时回流反哺下一轮选题。产能账非常漂亮,日产量翻倍、人力减半。但审计不能停在产能栏,要翻下一页:产量翻倍之后,单篇的平均阅读量掉了吗?广告填充率跟上了吗?如果供给翻倍而总注意力不变,每单位内容的商业价值就被稀释了一半——这就是媒体AI的第一重隐藏成本:产能通胀。全行业都用生成工具时,稀缺的不再是内容,是注意力,而注意力总量不随模型进步而增加。
def content_economy(creators, output_per, value_per_unit, attention_total): """示意:注意力总量固定时,供给膨胀如何摊薄单篇价值。""" supply = creators * output_per avg_value = attention_total / supply * value_per_unit return supply, avg_value # 引入生成工具前后:创作者数量不变,人均产量翻三倍 s0, v0 = content_economy(100, 4, 1.0, 100_000) s1, v1 = content_economy(100, 12, 1.0, 100_000) print("生成工具前: 日供给 %d 篇, 单篇价值指数 %.2f" % (s0, v0)) print("生成工具后: 日供给 %d 篇, 单篇价值指数 %.2f" % (s1, v1)) # 单篇价值掉到三分之一。产能红利在行业整体采用后被注意力天花板吃掉, # 竞争的焦点从"能不能生产"移回"能不能被信任"。
信息茧房:从口水仗到指标
信息茧房的公共讨论大多停留在形容词层面,审计要做的是把它变成可度量指标。可行口径至少有三个:信源多样性(一段时间内用户消费内容覆盖的独立信源数,按熵计)、观点跨度(同一话题下用户接触立场分布的方差)、探索率(推荐流中非历史偏好内容的占比)。有了指标才有干预实验——比如把探索率从百分之五提到百分之十二,观察留存与多样性的交换曲线。审计推荐产品时,如果对方完全拿不出这三个数中的任何一个,说明"治理茧房"只是公关稿。
import math def source_entropy(feed_sources): """信源多样性:按香农熵计,值越高越多元。""" counts = {} for s in feed_sources: counts[s] = counts.get(s, 0) + 1 n = len(feed_sources) return -sum((c/n) * math.log2(c/n) for c in counts.values()) narrow = ["A媒体"] * 18 + ["B媒体"] * 2 # 高度集中 broad = ["A媒体"] * 6 + ["B媒体"] * 5 + ["C媒体"] * 5 + ["D媒体"] * 4 print("集中信息流熵: %.2f 比特 | 多元信息流熵: %.2f 比特" % (source_entropy(narrow), source_entropy(broad))) # 同样二十条内容,熵差可以直接对比、可以 longitudinal 追踪、可以进 A/B 实验。 # 把"茧房"翻译成熵,治理才有抓手。
生成与标识义务
生成内容的标识(哪些内容有AI参与生产)正在从自律变为法定义务。落地层面的成色差异很大:规规矩矩的做法是在发布管线里给每篇内容打上生成参与度的元数据标签(纯辅助、部分生成、主要生成),并保留生成过程的可追溯记录;敷衍的做法是给用户一个"本平台可能含有AI生成内容"的全站横幅,等于什么都没说。审计媒体机构的AI合规,就看它的标识粒度是不是到了单篇内容级。
图:媒体AI的双重引擎与注意力天花板
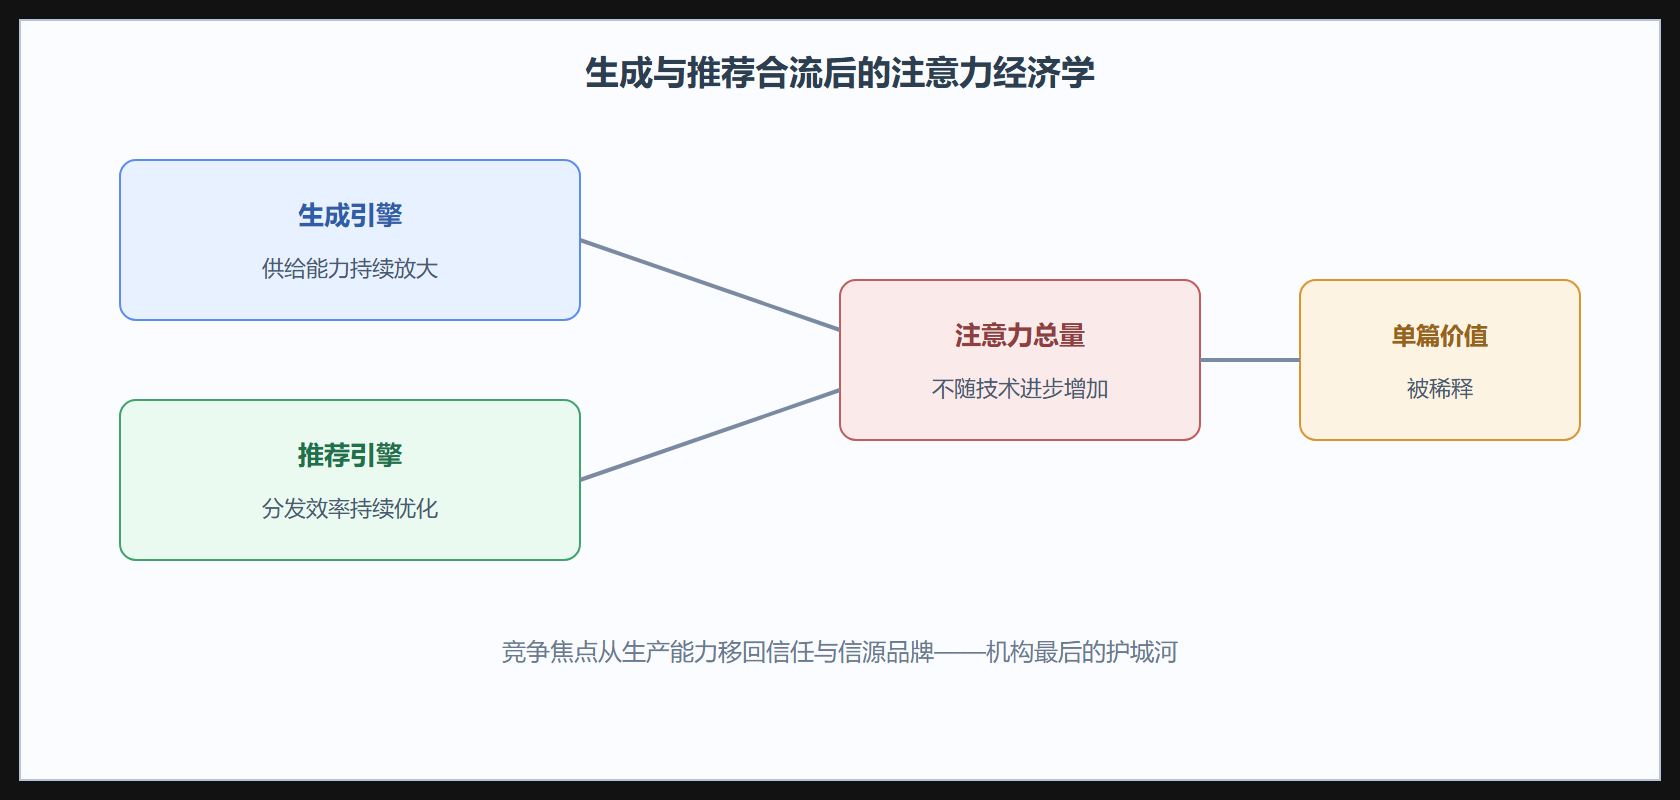
这张图把本节的核心论点画在一页里:两个引擎都在变强,天花板却不动,于是压强全部落在单篇价值上。它也解释了为什么严肃媒体反而可能在生成时代受益——当内容本身不再稀缺,"对内容负责的机构"成了稀缺品,信源品牌的溢价开始回升。审计媒体机构AI战略时,看它的投入是全押在生成产能,还是分了一部分给信源治理与标识合规,大致能判断这家机构对行业结构的理解深度。
结果、解读与变式
背景(夜班减半)、操作(注意力经济学模拟、熵指标)、结果(产能通胀与可度量茧房)完整。解读:媒体AI的成色分两层——机构层看标识合规与推荐多样性指标,行业层看注意力天花板下的价值稀释。误伤对象在这里最抽象也最庞大:公共认知本身,可逆性接近零。变式:短视频平台、网文平台、游戏内容生成(程序化关卡、NPC对话)是同构现场,熵指标与探索率口径均可迁移。下一节把审计台搬到约束最硬的地方:政务大厅。
创作者侧的账
正文主要算了平台侧的账,创作者侧同样有一本。生成工具降低了内容生产的门槛,也压低了内容的单位价格:撰稿、插画、配音的市场单价在生成工具普及后普遍承压,头部创作者靠风格与信源溢价维持,腰部以下被替代最快。审计媒体机构的人才结构时,一个前瞻性问题是:机构里"操作型"内容岗位与"判断型"编辑岗位的比例变化。健康的转型是操作型占比下降、判断型保持或上升;危险的转型是判断型也在流失——那意味着机构把自己的信源能力当成本砍掉了,等注意力通胀兑现时已经无人能守住内容的最后一道质量关。
一个可操作的治理实验
给内容团队的建议来自一个真实做法:每周留出一小时的"无推荐日",编辑人工编排一次首页,对比当天的点击分布与算法日的差异。差异本身不是问题,长期观察差异的走向才是——如果人工日和算法日的重合度逐年上升,说明编辑部的独立判断正在被算法同化,多样性在组织层面流失。这类小实验成本低,却能把抽象的"茧房治理"变成编辑部例会上可以讨论的具体数字。