5.1 自然语言处理应用审计
5.1 自然语言处理应用审计
语言类模式涵盖分词与信息抽取、文本分类、语义检索、摘要生成与大模型对话。本节把它从各行业抽出来横向审计:同一类技术在权利浓度不同的行业里,成色如何被幻觉代价重新定价。
同一个模型,三种命运
把大模型想象成一位知识渊博但不承认自己会犯错的顾问。请它做三件事:给客服工单打分类标签、给新闻稿写导语、给贷款拒件写理由函。第一件事它做得极好——标签错了顶多重派一次,错误代价是几分钱。第二件事做得不错但要人润色——事实错误发出去是公关事故。第三件事几乎不能让它碰——错误理由写进法律文书就是合规事故。同一模型、同样的能力,成色被"错误的行业定价"分成三档。这就是语言模式审计的第一原理:先给错误定价,再谈模型能力。
def hallucination_budget(task, error_price, volume, tol_error_rate): """错误定价决定可用性:预算 = 允许的错误率 x 单价 x 量。""" acceptable_rate = tol_error_rate / (error_price * volume ** 0.5 + 1) return min(acceptable_rate, 0.30) tasks = [ ("工单分类", error_price=0.5, volume=100_000, tol=5000), ("新闻导语", error_price=8000, volume=200, tol=4000), ("拒贷理由", error_price=500_000, volume=50, tol=2000), ] for name, ep, v, tol in tasks: r = hallucination_budget(name, ep, v, tol) tier = ("可全自动" if r > 0.05 else "人机协作必留复核" if r > 0.005 else "只可辅助起草") print("%s: 可容忍错误率约 %.4f -> %s" % (name, r, tier)) # 错误定价每上一个数量级,自动化等级就要降一级。 # 这个粗䊁的公式不是精算,是提醒:定价是审计的第一个动作。
抽取与分类:被低估的老技术
大模型热起来之前,NLP的主力是信息抽取与文本分类,它们至今仍是成色最稳的语言应用:工单路由、舆情分类、合同要素抽取、病历结构化。稳的原因与负荷预测同构——标签回流快、错误代价可控、有朴素基线可比(关键词规则)。审计这类项目时,大模型时代的典型坑是"用大炮打蚊子":一个几百类目的工单分类,微调一个小模型几毫秒返回,换成通用大模型零点几秒、成本翻几十倍,精度未必更高。第1.2节选型阶梯的教训在这里复现:先问问题复杂度,再选武器。
KEYWORDS = {"退款": ["退款", "退货", "退钱"], "物流": ["快递", "发货", "物流", "签收"]} def rule_router(text): """朴素基线:关键词路由。任何模型都要先赢过它。""" for label, kws in KEYWORDS.items(): if any(k in text for k in kws): return label return "其他" samples = ["我的快递三天没动了", "申请退款一直没到账", "账号登录不上"] for s in samples: print(s, "->", rule_router(s)) # 覆盖率也许只有七成,但它是零成本、零延迟、完全可解释的基线。 # 审计任何"智能路由",先问:基线命中率多少,模型增益多少,延迟与成本差多少。
检索增强:语言模式的工程收口
2.3节法律与4.4节政务都指向同一个架构——检索增强:先检索到依据,再生成受限改写。它是当前语言类应用最成体系的工程收口,把开放生成的问题转化为检索质量加改写纪律两个可分别度量的问题。审计检索增强系统有三个固定动作:测检索的召回(漏没漏依据)、测忠实度(回答有没有超出依据的添加)、测拒答率(没依据时它说不说不知道)。第三项最常被忽略,也最能区分成熟团队与演示团队。
图:语言模式的错误定价梯度
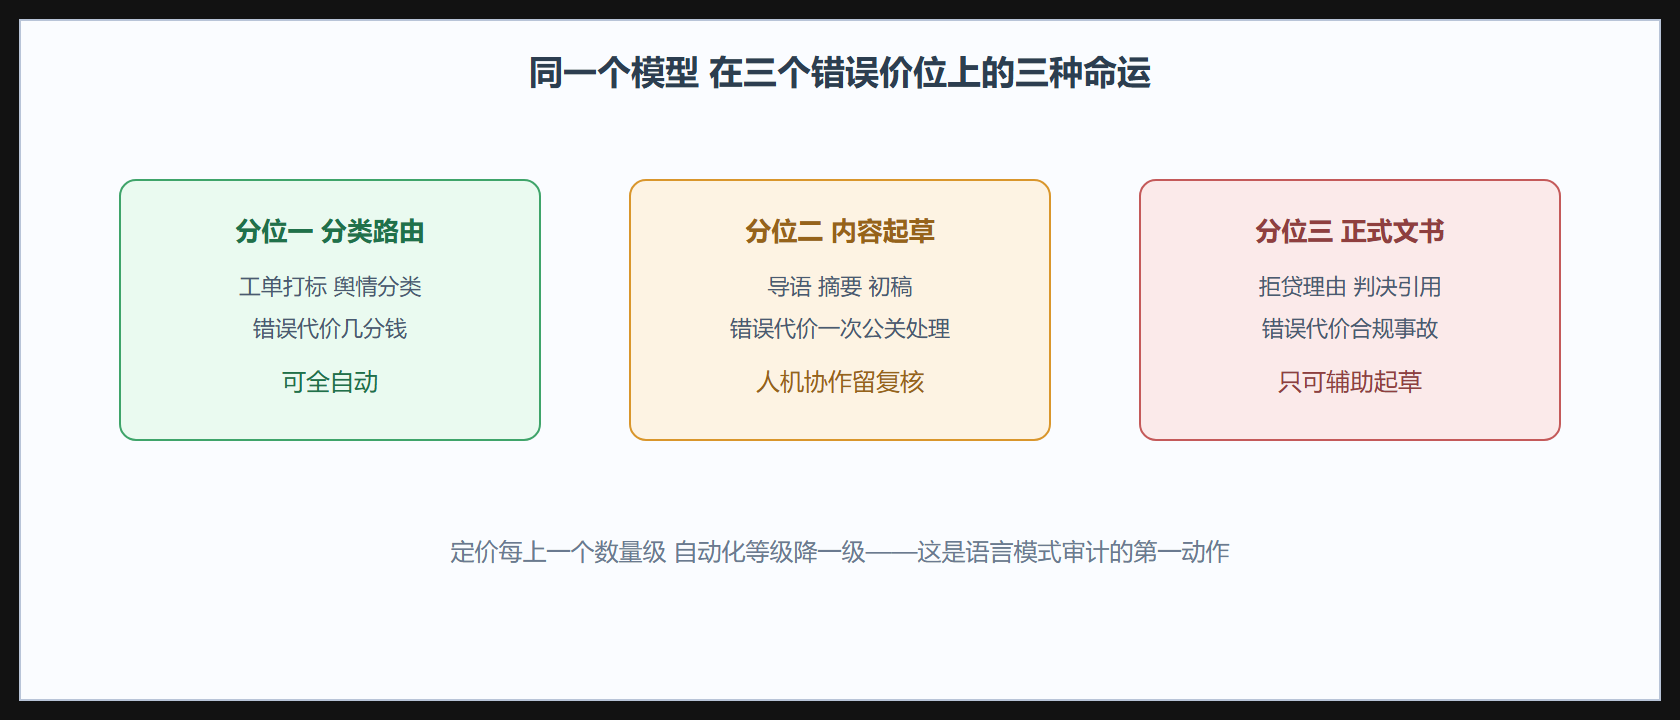
这个梯度也提示了采购谈判的一个实务技巧:让供应商按分位报价,而不是一个笼统的"智能文案平台"。分位一的分类路由应该是按量计费的白菜价,分位三的辅助起草才值服务费。混在一起报价的合同,最后往往按分位三的价钱买了分位一的货。
结果、解读与变式
背景(同一模型三种命运)、操作(错误定价预算、朴素基线)、结果(三档自动化等级与检索增强三测)完整。解读:语言模式的成色规律是"错误定价先行、基线先于模型、拒答先于流畅"。变式:跨行业迁移时最先失效的永远是标签口径——工单分类的类目表换一家企业就要重造,这类项目的技术能复用、类目资产不能。下一节看视觉类模式。
模式内部的一次分化
大模型时代给语言模式带来一次内部分化:理解类任务(分类、抽取、匹配)与生成类任务(写作、对话、代码)在工程路线上分道扬镳。理解类仍然以小模型加领域微调为主流——快、便宜、可控;生成类则被通用大模型接管,靠提示工程与检索增强补齐可靠性。审计语言类项目时先做这个二分:如果它把理解类任务架在通用大模型上,多半是架构懒惰,成本与延迟都会吃亏;如果它声称用小模型做开放生成,则要重点测幻觉——小模型在知识边界外的胡编能力一点不弱,只是不那么流畅、更难被察觉。分化的另一面是融合:分类任务用大模型做少样本标注、再蒸馏给小模型,是当下性价比最高的组合拳,审计时值得把这个管线列为加分项。
多语言与方言的坑
跨行业迁移时语言边界也是技术边界:在英语世界验证成熟的抽取方案,迁到中文要重过一遍分词与实体识别;政务与方言密集的服务场景(例如面向老龄群体的语音客服)还要处理口音与非规范表达。这类适配成本通常被方案书忽略,却常常占项目实际工作量的一半。审计追问一句"目标语料的真实分布测过吗",能拦住大半水土不服。
补一个选型速查的口诀收尾:语言类任务先问三句——错了赔多少、要不要引用、延迟给多少。赔得少就全自动,要引用就上检索增强,延迟卡得死就用小模型。三句问完,架构选型已经完成八成,剩下两成才是模型细节。这个口诀与本章开头的错误定价一脉相承,也是把本节读薄之后的最终形态。