5.2 计算机视觉应用审计
5.2 计算机视觉应用审计
视觉类模式涵盖图像分类、目标检测、实例分割、OCR与行为识别。本节横向审计它在制造质检、医疗影像、工地巡检、农业识别等现场的成色涨落,并提炼决定涨落的关键变量:环境可控性。
光线是最大的算法变量
四个现场摆在一起:电子厂产线相机质检、医院CT读片、工地摄像头安全巡检、田间病虫害识别。同一代检测模型,四个现场的成色排序恰好是"环境可控性"的排序。产线最好——封闭光罩、固定焦距、传送带匀速,成像分布几乎不变;医疗次之——设备标准化程度高但跨院漂移(2.2节);工地再次——昼夜、雨雾、扬尘全在变;田间最差——太阳角度每小时都不同。审计视觉项目的第一个问题永远是"成像环境能锁多死",这比问模型精度重要。
def deployed_accuracy(factors, lab_mAP=0.92): """示意:从实验室精度到现场精度的折损链。""" a = lab_mAP for name, penalty in factors: a *= (1 - penalty) return a sites = { "产线质检": [("光照波动", 0.01), ("遮挡", 0.01)], "工地巡检": [("昼夜光照", 0.06), ("扬尘雨雾", 0.04), ("视角变化", 0.03)], "田间识别": [("日光角度", 0.08), ("风摆遮挡", 0.05), ("机型色偏", 0.03)], } for site, f in sites.items(): print("%s: 实验室 92%% -> 现场约 %.0f%%" % (site, deployed_accuracy(f) * 100)) # 同一个模型,三个现场差出十几个百分点。 # 折损不是模型问题,是部署设计问题——打光、机位、触发时机都归工程管。
视觉项目的两条成本暗线
第一条是标注成本。视觉标注按框计价,一个检测项目起步就要数万张标注图,换一个新场景基本要重新标。审计时把标注费单列,很多"算法便宜了"的项目其实死在标注预算上。第二条是长尾样本的持续收集:缺陷检测里真正值钱的是罕见缺陷样本,它们出现的频率正比于生产事故率——你想要的样本恰好是最不想发生的事件的产物。成熟团队会为长尾建立专门的回流管道(产线拦截图自动入库、人工复核确认),这条管道的有无是视觉项目成色的分水岭。
import random random.seed(82) def rare_defect_flow(months=12, base_rate=0.001, capture_rate=0.3): """示意:罕见缺陷样本的积累速度决定模型对它的检出能力。""" samples = 0 for _ in range(months): caught = 200_000 * base_rate * capture_rate # 月产能 x 缺陷率 x 回流捕获率 samples += int(caught) return samples print("一年回流罕见缺陷样本:", rare_defect_flow(), "张") print("装了回流管道后:", rare_defect_flow(capture_rate=0.85), "张") # 捕获率从三成提到八成半,一年样本量接近三倍。 # 模型对这类缺陷的召回上限,在管道设计阶段就被写死了。
OCR与行为识别的补充
OCR是视觉模式里成色最稳的分支——票据、证照、表单的成像在扫码枪下高度可控,行业沉淀也厚。审计要点只剩版式泛化:换一种新版式的票据,抽取字段的位置全变,系统要有低成本的版式适配流程。行为识别(安全帽、跌倒、手势)则是最容易被演示高估的分支:小目标、遮挡、动作模糊三重困难叠加,现场精度常与演示差距巨大,审计时应要求实拍环境的测试集报告,而非公开数据集成绩。
图:环境可控性阶梯与成色对应
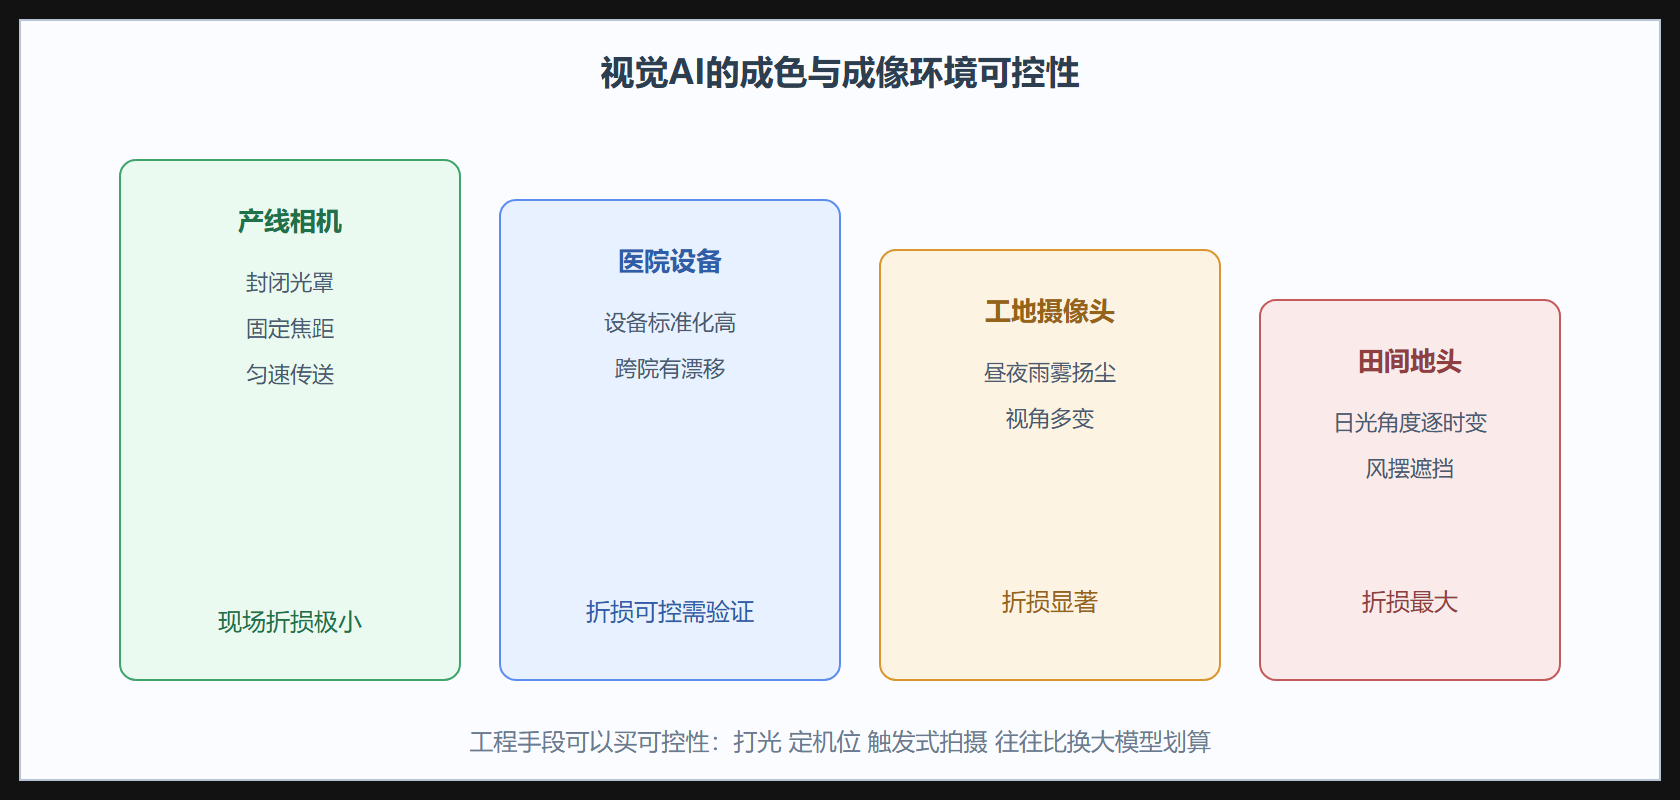
这张阶梯图给出了视觉项目的预算分配原则:先花工程钱把环境可控性买到手,再花算法钱买模型能力。审计中见到的反例几乎都是反着来的——环境裸奔,靠堆模型层数硬扛,结果维护成本失控。阶梯还提示了跨行业迁移的顺序:从左往右迁移是逆水行舟,每挪一格都要重新验一轮折损;从右往左迁移则是顺流而下,田间的模型放到产线几乎必然更好。
结果、解读与变式
背景(光线是最大的算法变量)、操作(折损链、回流管道)、结果(环境可控性排序与两条成本暗线)完整。解读:视觉模式的迁移规律是"环境可控性可以买"——加光罩、定机位、上触发式拍摄的工程投入,往往比换更大的模型收益高。变式:无人零售的货架盘点、加油站的安全合规抓拍、实验室的危险操作识别,都可用环境可控性加回流管道两把尺子直接审。下一节看预测类模式。
从检测到分割再到计数的审计口径
视觉任务链有一条从定性到定量的阶梯:分类(有没有)、检测(在哪)、分割(精确轮廓)、计数与计量(多少、多长、多深)。审计中常见的口径混淆发生在阶梯两端——供应商用检测级别的演示(框出瑕疵)支撑计量级别的承诺(算出瑕疵面积与合格判定)。计量对边界精度敏感得多:分割边缘差几个像素,面积误差就可能到两位数百分比。审计视觉项目的承诺时,先确认它落在阶梯哪一级,再按该级的精度口径要测试报告。桥梁裂缝宽度测量、钢结构焊缝评级这类计量级应用,报告里必须有像素当量的标定说明(一个像素对应多少毫米),否则数字无从谈起。
合成数据的成色
标注贵催生了合成数据:用三维引擎渲染带瑕疵的虚拟工件来扩充训练集。它便宜、标注完美、可控,但成色取决于与真实成像的差距——渲染的瑕疵纹理过于规则、光照过于均匀,模型学到的是渲染器的指纹而非真实缺陷。稳妥用法是合成数据加少量真实数据混合,并单独在纯真实测试集上验收。审计看到训练集里合成占比过半的项目,要求提供"仅真实数据"的测试成绩即可戳破水分。
视觉审计同样可以读薄成三问:光能不能控、样本能不能回流、要不要计量。光不能控先补工程再谈模型,样本不回流就先建管道,要计量就必须查标定。三问的顺序不能乱——它们恰好是从最便宜的问题问到最贵的问题,符合审计的省钱原则。