5.4 推荐系统与个性化服务审计
5.4 推荐系统与个性化服务审计
匹配类模式包括推荐(给人找物)、搜索(给词找物)与个性化定价排序。本节横向审计它的成色:冷启动的行业解法、搜索与推荐的合流、以及匹配系统特有的反馈回路风险。
冷启动的三种行业解法
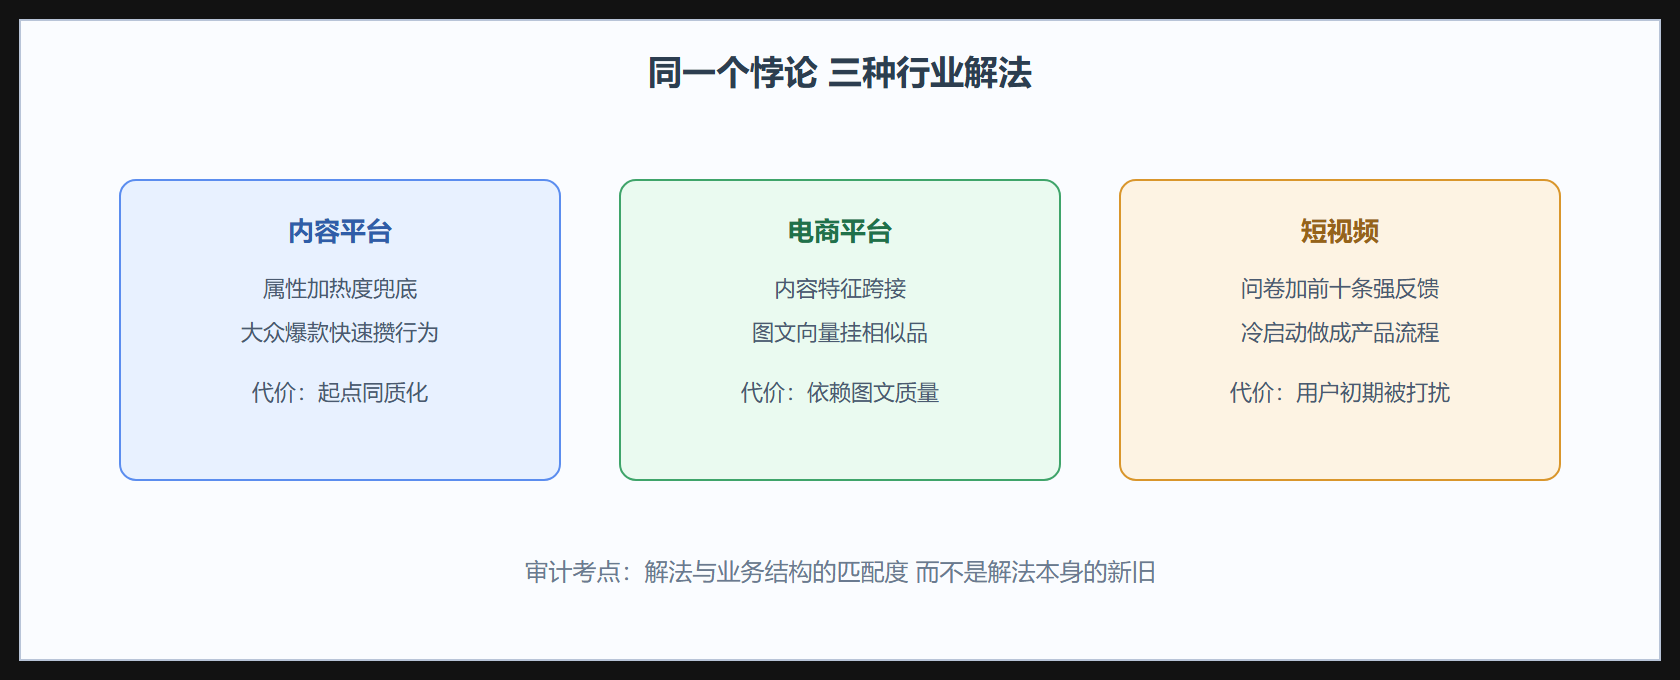
新用户没历史、新商品没交互,匹配系统在最需要工作的时候最没依据——这是冷启动悖论。三个行业的解法值得并排看。内容平台用人口属性加热度兜底(新用户先推大众爆款,快速攒几步行为);电商用商品内容特征跨接(新商品靠图文描述的向量,挂到已有行为的相似商品上);短视频干脆用"兴趣探索问卷加前十条强反馈"把冷启动做成产品流程的一部分。审计匹配系统,冷启动方案是必查项:没有内容特征跨接的电商推荐,新品的流量命运完全押在运气上,这与3.1节的长尾饥饿直接相连。
import math ITEMS = { "复古跑鞋": {"vec": (0.9, 0.2, 0.1), "interactions": 4500}, "真皮乐福": {"vec": (0.8, 0.3, 0.1), "interactions": 3200}, "登山靴": {"vec": (0.3, 0.9, 0.2), "interactions": 2800}, "新款凉拖": {"vec": (0.7, 0.1, 0.5), "interactions": 3}, # 新品,几乎无交互 } USER_TASTE = (0.85, 0.25, 0.1) # 用户偏好向量(示意) def cos(a, b): dot = sum(x * y for x, y in zip(a, b)) return dot / (math.sqrt(sum(x*x for x in a)) * math.sqrt(sum(x*x for x in b))) def hybrid_scores(alpha=0.3): """混合分 = 交互热度 + 内容相似。alpha 是内容侧权重。""" out = {} for name, it in ITEMS.items(): pop = math.log1p(it["interactions"]) / math.log1p(4500) # 热度归一 sim = cos(it["vec"], USER_TASTE) out[name] = (1 - alpha) * pop + alpha * sim return dict(sorted(out.items(), key=lambda kv: -kv[1])) for item, s in hybrid_scores().items(): print("%s: 混合分 %.3f" % (item, s)) # 新款凉拖靠内容相似度挤进了第二梯队——纯热度模型里它永远沉底。 # alpha 的取值就是"给新东西多少机会"的产品决策,应由业务定并定期复核。
搜索与推荐的合流
传统上搜索是"人找物"(明确意图、关键词驱动),推荐是"物找人"(隐式意图、行为驱动)。两条技术栈正在合流:搜索结果页尾部插入推荐流,推荐流里支持关键词过滤,底层共用一套向量索引。合流的审计含义是:评估口径要统一到"满足意图的程度",而不是搜索看点击首位的比率、推荐看人均时长两套不相干的指标。合流也带来合流的风险——搜索的明确意图被推荐的沉浸目标污染,用户搜一样东西却被留在信息流里,短期时长涨、长期信任跌。
匹配系统特有的反馈回路
3.1节提过曝光偏差,这里把它升格为匹配模式的通用审计项。推荐决定用户看到什么,用户行为反过来训练推荐——系统会不断强化自己早期的偶然判断,多样性单调收窄。4.3节的熵指标是监控手段,工程手段是探索机制(留一小部分流量做受控的随机曝光)。审计时核对两件事:探索流量的占比是多少、有没有被业绩压力偷偷关掉。探索流量短期看是亏损,长期看是整个系统的免疫系统——被关掉的系统死于缓慢的多样性衰竭,而且死得无声无息。
def diversity_track(rounds=20, explore=0.10): """示意:探索流量对推荐多样性的维持作用。""" niche = 0.10 # 小众内容初始份额 for _ in range(rounds): feedback_boost = 1.25 if niche > 0.15 else 0.9 # 正反馈:多的更多 niche = niche * feedback_boost * (1 - explore) + explore * 0.12 niche = min(max(niche, 0.0), 1.0) return niche for e in (0.0, 0.10): print("探索率 %.0f%% -> 20轮后小众内容份额 %.1f%%" % (e * 100, diversity_track(explore=e) * 100)) # 无探索时小众份额滑向零,系统只剩头部内容的自说自话。
图:冷启动解法的行业差异
结果、解读与变式
背景(冷启动悖论)、操作(混合分、多样性追踪)、结果(合流口径与探索流量检查)完整。解读:匹配模式的成色规律是"意图满足优先于时长、探索流量是免疫系统、冷启动方案决定生态健康"。变式:招聘的人岗匹配、网约车的供需匹配、课程与学员的匹配都可套用,共同考点仍是冷启动、反馈回路与评估口径三件套。下一节看最后一类模式:执行。
长期价值与短期指标的分裂
匹配模式最深的一个审计主题是时间尺度的分裂:点击、转化这些可优化的短期指标,与用户信任、生命周期价值这些真正值钱的长期指标,相关性并不稳定。极端优化短期指标的推荐(标题党、成瘾性刷播)在长期指标上是负资产。工程上的应对是给长期价值建代理指标(七日留存、回访深度、主动搜索占比),在在线实验里与短期指标并列观测。审计推荐系统的成熟度,看它的实验看板上有几个长期代理指标、有没有人因为长期指标否决过短期的胜利——有过这类否决记录的团队,才算真正理解自己的系统在经营什么。
隐私约束下的匹配
个性化与隐私保护天然紧张,工程上的解法方向是端侧计算与联邦学习:偏好画像留在用户设备,服务端只见加密的梯度或匿名的人群包。这些方案有真实的代价——迭代变慢、调试困难、跨设备一致性差。审计隐私增强的匹配系统时,要区分合规驱动(满足法规下限)与信任驱动(把隐私当产品卖点),前者做到匿名化即可,后者要经得起第三方审计。两种都合法,但混着宣传就是成色问题。