5.3 预测分析与决策优化审计
5.3 预测分析与决策优化审计
预测类模式用历史数据估计未来数值(销量、负荷、产量、故障概率),决策优化则在约束下选择动作。本节横向审计这对搭档的成色:为什么简单基线如此难打败、外部变量何时值得引入、预测到决策的最后一公里断在哪。
打不败的朴素基线
预测领域的第一定律:朴素基线出奇地强。销量预测里"上周同天值加季节修正"能打败一半的深度模型;负荷预测里"去年同期加温度回归"几十年不倒。原因不是模型不行,而是多数业务序列的信噪比就那么高——剩下的"可预测部分"本来就不多。审计预测项目,第一个动作永远是让供应商与朴素基线对比,第二个动作是问赢了基线多少个百分点、这几点换算成3.5节那三笔钱值多少。
import random random.seed(83) def series(n=104): """一年销量:趋势 + 周季节 + 噪声。""" out = [] for t in range(n): trend = 100 + 0.3 * t weekly = 20 * [0, -10, -15, 5, 30, 45, 10][t % 7] out.append(trend + weekly + random.gauss(0, 12)) return out data = series() train, test = data[:-8], data[-8:] def mae(pred, actual): return sum(abs(p - a) for p, a in zip(pred, actual)) / len(actual) naive = [train[-7 + i % 7] + 0.3 * (8 + i) for i in range(8)] # 同星期 + 趋势 oracle = test print("朴素基线 MAE: %.1f | 噪声下限估计: %.1f" % (mae(naive, oracle), sum(abs(a - b) for a, b in zip(test, naive)) / 8 * 0.7)) # 在这样的序列上,复杂模型能从基线手里抢到的改进往往只有百分之几。 # 项目的钱要花在别处:数据清洗、外部变量、决策联动,而不是堆模型层数。
外部变量的引入时机
什么时候值得给模型加输入?审计口径是增量验证:加入外部变量(天气、促销日历、宏观指标)后单独重跑回测,改进显著才保留。常见的反模式是"特征越多越先进"——促销日历对快消品是命脉,对建材销量的影响却微弱到不值得维护数据管道。每个外部特征都是一条要长期养的数据管道,养不起的管道不如不加。
最后一公里:从预测到决策
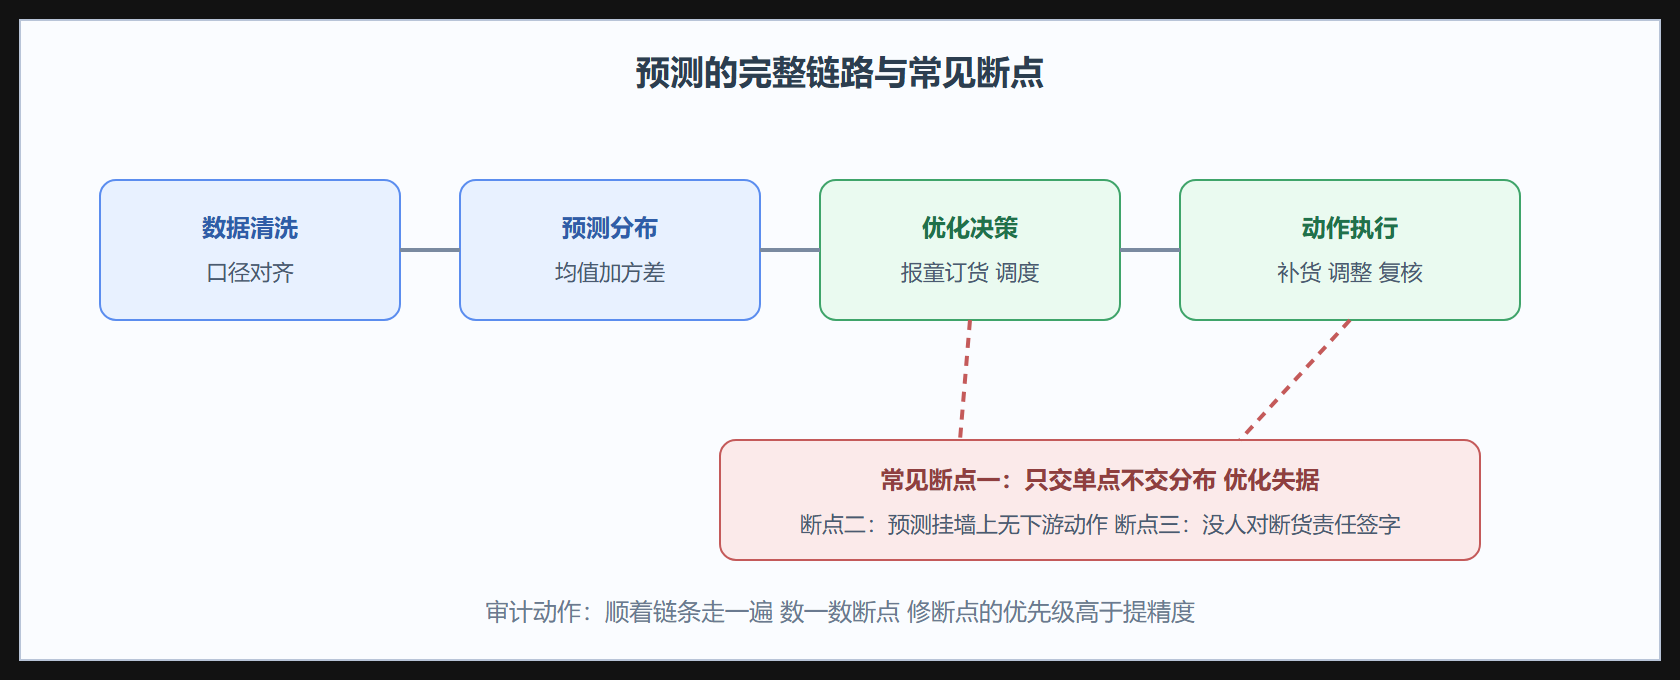
预测类项目最隐蔽的失败在预测之后。模型说"下周销量涨两成",然后呢?补货规则接了吗?补多少、谁审批、断货责任算谁的?没有接到决策动作的预测是挂在墙上的仪表盘。成色好的项目把预测和优化耦合起来:预测给出分布(不是单点),优化器在分布上算期望成本最低的动作。这也解释了预测和优化为什么是搭档而非邻居——单点预测丢掉的方差信息,恰恰是优化最需要的。
def order_decision(mu, sigma, price=10, cost=4, salvage=1, under_cost=2): """报童模型:在需求分布上找期望利润最高的订货量。 mu, sigma: 预测的均值与标准差——分布,而不是单点。""" best_q, best_profit = mu, None import math def expected_profit(q): # 用正态近似离散扫描 profit = 0.0 for d in range(int(mu - 3 * sigma), int(mu + 3 * sigma)): w = math.exp(-((d - mu) ** 2) / (2 * sigma ** 2)) sold = min(q, d) profit += w * (sold * (price - cost) - max(q - d, 0) * (cost - salvage) - max(d - q, 0) * under_cost) return profit for q in range(int(mu - 2 * sigma), int(mu + 2 * sigma)): p = expected_profit(q) if best_profit is None or p > best_profit: best_q, best_profit = q, p return best_q print("预测均值300标准差40 -> 建议订货量:", order_decision(300, 40)) print("预测均值300标准差90 -> 建议订货量:", order_decision(300, 90)) # 不确定性越大,最优订货量越保守。单点预测给不出这个结论—— # 这就是"预测必须交分布、决策必须在分布上做"的含义。
图:预测到决策的最后一公里
结果、解读与变式
背景(打不败的基线)、操作(基线对照、报童决策)、结果(增量验证口径与最后一公里检查)完整。解读:预测模式的成色规律是"基线先于模型、分布先于单点、动作先于精度"。变式:换行业时最先失效的是外部变量的相关结构——天气对饮料和水泥的作用方向都不同,特征清单必须逐行业重建。下一节看匹配类模式:推荐与搜索。
预测团队的组织位置
模式审计之外补一个组织观察:预测团队的汇报位置影响成色。汇报给技术的团队,模型精度漂亮但业务采纳率低;汇报给业务的团队,模型朴素但真被用进补货与排产决策。原因不难理解——预测的价值只有通过决策动作兑现,而动作权限在业务手里。成色好的组织安排是预测团队嵌入业务条线、共享业务考核,模型上线时连带着一份"决策接入清单":哪个系统读这个预测、触发什么动作、谁负责异常覆盖。这份清单的存在与否,比团队的算法竞赛奖牌更能预测项目成败。
回测的三个作弊手法
审计预测项目还要会识别回测作弊。手法一:用未来数据做特征(比如用当月促销强度预测当月销量,而促销计划当月初才确定,看似可得实则泄漏)。手法二:随机切分训练测试集,时间序列必须按时间切分,随机切分让模型"见过未来"。手法三:反复调参直到测试集表现好,等于把测试集当训练集用过了。三招都让报告数字虚高,识别方法分别是审特征时间戳、审切分方式、问调参轮次与测试集使用次数。回测可信度不解决,前面所有精度讨论都是空中楼阁。