3.1 神经网络基础:从感知机到多层网络
3.1 神经网络基础:从感知机到多层网络
本节摘要:人工神经网络的基本单元是模仿生物神经元的人工神经元——接收多个输入,各乘以权重后求和,加偏置,再过一个激活函数输出。本节从生物启发讲到 1957 年的感知机模型,拆解权重、偏置、激活函数三要素的作用,比较 Sigmoid、Tanh、ReLU 的优劣,说明非线性激活为何是网络能力的关键,最后把单个神经元组装成输入层-隐藏层-输出层的前馈网络并走一遍前向传播。
读前必看
阅读完本节,你应当能够:
- 对应生物神经元与人工神经元的部件关系;
- 写出神经元的输出计算式并解释每项含义;
- 论证"没有非线性激活则深层网络退化为线性模型";
- 比较三种常用激活函数的优缺点;
- 数出给定任务的输入层与输出层节点数;
- 手推一个两层网络的前向传播数值例子。
一、从生物神经元到数学模型
人脑约有数百亿神经元。一个生物神经元有四件套:树突接收其他神经元传来的电信号,细胞体把所有输入整合,当总信号强度超过阈值时神经元被"激活",轴突把电脉冲送出去,突触连接两个神经元且传递强度可变——学习在生物学上就发生突触强度的改变上。
1957 年 Rosenblatt 提出的感知机把这个结构翻译成了数学:输入对应树突,权重对应突触强度,加权求和加阈值判断对应细胞体的激活条件,输出对应轴突。生物与人工的对应关系一图看清:
图:人工神经元解剖标注图
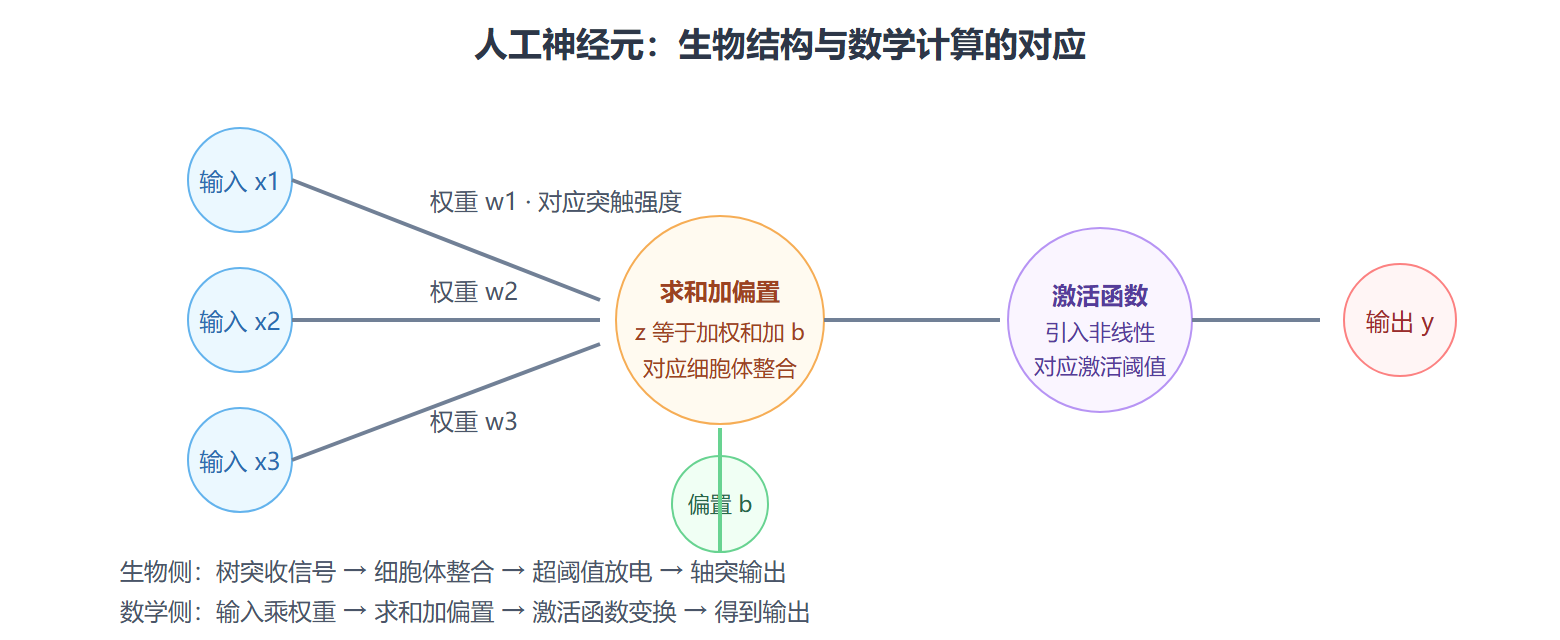
计算式为:先算加权和加偏置 z,再过激活函数 f 得输出 y。用文字表达:z 等于所有"输入乘权重"之和再加 b;y 等于 f 作用在 z 上的结果。
二、三要素各干什么
权重是输入的重要性系数,训练的全部内容就是不断调整这些数。偏置是一个可学习的常数项,作用是平移激活的门槛——没有偏置时,神经元只能在"信号加权和为零"的位置开关,有了偏置它可以自由选择激活基准线。激活函数决定神经元"发不发火、发多强"。
激活函数为什么必须是非线性的?这是本节最重要的一件事:如果激活是线性的,那么无论叠多少层,整个网络都可以合并成一个单一的线性变换。两层线性函数的复合还是线性函数——层数白叠了。正因为引入了非线性,多层网络才能逼近任意复杂的函数关系(万能近似定理的存在基础)。早期感知机用阶跃函数(输出只有 0 和 1),不可导、无法用梯度训练,这正是它在 1969 年被指出连异或问题都解决不了的症结之一;现代网络全部改用连续可导的激活函数。
| 激活函数 | 输出范围 | 优点 | 缺点 | 典型位置 |
|---|---|---|---|---|
| Sigmoid | 0 到 1 | 可当概率、平滑 | 两端梯度趋零(梯度消失)、计算含指数 | 二分类输出层 |
| Tanh | -1 到 1 | 零中心、比 Sigmoid 收敛快 | 同样有梯度消失 | 旧式循环网络 |
| ReLU | 0 到正无穷 | 计算极简、正区间梯度恒为 1、缓解梯度消失 | 负区间输出恒零(死亡 ReLU) | 隐藏层默认选择 |
隐藏层的默认选择是 ReLU 及其变种(Leaky ReLU 让负区间保留微小斜率,缓解死亡问题);输出层按任务定:二分类用 Sigmoid,多分类用 Softmax,回归用线性输出。
三、从神经元到网络
单个神经元能力有限,力量来自组织成层。前馈网络三种层:
- 输入层:节点数等于特征数,只传递数据不做计算;
- 隐藏层:一或多层,负责特征提取与变换;层数(深度)与每层节点数(宽度)是关键超参数;
- 输出层:节点数由任务决定——回归 1 个、二分类 1 个、多分类等于类别数。
"全连接"指相邻两层每个节点都与对方全部节点相连,信息单向从输入流向输出、没有回路——故称前馈网络,也叫多层感知机(MLP)。
四、手推一次前向传播
概念演示(权重值随便设的):
输入 x 等于 1.0 与 0.5 两维 第一层权重 0.4 与 -0.2,偏置 0.1 z1 等于 0.4乘1.0 加 -0.2乘0.5 加 0.1 等于 0.4 a1 等于 ReLU 作用 0.4 等于 0.4 第二层权重 0.7,偏置 -0.1 z2 等于 0.7乘0.4 加 -0.1 等于 0.18 输出层 Sigmoid 作用 0.18 约等于 0.545
对任意深度的网络,前向传播就是"算一层、传一层"的重复:每层先做加权求和加偏置,再过激活函数,把结果作为下一层的输入。推理阶段(模型上线预测时)跑的就是这个过程,一次前向传播即得预测结果。
💡 关键直觉:把每层看作一次"坐标变换加弯折"——线性部分负责旋转拉伸空间,激活函数负责把空间折弯。层叠得越多,能折出的形状越复杂,这就是深度网络表达力的来源。
⚠️ 常见坑:隐藏层用 Sigmoid 叠很多层。每过一层梯度大约缩小四分之一,十层之后梯度近乎归零,前面的层根本学不动——这正是 ReLU 成为主流隐藏层激活的历史原因。
五、参数量、初始化与容量直觉
算一算参数量。 一个 400 输入、两个 300 节点隐藏层、10 输出的全连接网络:第一层 400 乘 300 加 300 约十二万参数,第二层 300 乘 300 加 300 约九万,输出层 300 乘 10 加 10 约三千,合计约二十一万。感受这个数量级的意义:训练数据若只有一万条,每条样本要约束二十一个参数——过拟合几乎是宿命。深度网络的"参数饥饿"是它需要大数据的根本原因。
初始化为什么重要。 全零初始化会让同层所有神经元收到完全相同的梯度、学出完全相同的参数(对称性问题,等于每层只有一个神经元)。实践用小的随机值初始化(如 Xavier、He 初始化——按层的输入维度缩放随机幅度,保持信号方差在网络中大致不变)。初始化不当的典型症状:训练初期损失就不动,或很快发散成无效值。
容量与深度的取舍直觉。 表达力随深度指数增长(每多一层是在复合一次非线性变换),但训练难度、数据需求、过拟合风险同步上升。起步建议:先用两三个隐藏层的浅网验证数据里有可学的信号,确认有效后再逐步加深观察验证集表现——"由浅入深"比"一步到位"省时省卡。
常见问题
隐藏层节点数有公式吗? 没有可靠公式,只有经验范围:介于输入维度与输出维度之间起步,或从较小值开始倍增试验。节点数是典型的超参数,交给验证集去裁决——网格上试几个值的时间,远少于纠结理论值的时间。
神经网络能处理类别特征吗? 能但需要转换。类别先做嵌入映射成稠密向量(高基数类别如商品编号的标准做法),低基数类别可独热后接全连接层。直接把类别编号当数值喂入是错误——编号之间没有大小与距离含义,网络会学到虚假的序关系。
为什么我的小网络学不动(损失不降)? 按顺序排查五项:学习率是否过大或过小、特征是否做了缩放(未缩放时梯度被大量纲特征主导)、标签是否正确对齐、激活函数选择、输出层与损失函数是否匹配(如回归误用了分类损失)。五项查完,九成"学不动"能定位。
核心回顾
- 生物对应:树突-输入、突触-权重、细胞体-求和整合、轴突-输出;
- 计算式:输出等于激活函数作用于"加权和加偏置",偏置平移激活门槛;
- 非线性是命门:线性激活下任意深度的网络等价于单层线性模型;
- 激活选择:隐藏层默认 ReLU 系,输出层按任务选 Sigmoid/Softmax/线性;
- 层结构:输入层只传递、隐藏层做变换、输出层节点数由任务决定;
- 前向传播:逐层"求和加偏置过激活",推理就是一次前向传播。
网络搭好了还不会任何事——下一节先看"深"能带来什么,再学怎么把参数训出来。