3.2 深度神经网络架构:层类型与经典架构
3.2 深度神经网络架构:层类型与经典架构
本节摘要:当隐藏层达到多个,网络就称为深度神经网络,"深"的价值在于学习数据的层次化抽象表示——浅层学边缘与词频,深层学物体部件与语义。本节覆盖六种核心层类型(全连接、卷积、池化、循环、归一化、Dropout)的设计动机与代价,以及三种架构模式(残差连接、Inception 模块、注意力机制),并按时间线串起 LeNet 到 Transformer 的经典架构谱系。架构设计的本质是把数据的先验结构(局部性、时序性)刻进网络,从而用更少参数学到更好的表示。
学习目标
阅读完本节,你应当能够:
- 解释"深度"带来的层次化表示学习与"深"的代价;
- 说出卷积层的参数共享与局部感受野为何适配图像;
- 说明池化层的作用与"无参数"特性;
- 解释标准 RNN 的梯度消失问题与 LSTM 门控的应对;
- 描述残差连接缓解梯度消失的机制;
- 按任务类型(图像/序列/表格)推荐架构起点。
一、为什么要深
深度不是炫技。以图像为例:第一层卷积学到的是边缘、色块这类基础特征;第二层把边缘组合成角点、纹理;再往上层组合出眼睛、轮子等物体部件;顶层组合出"猫""汽车"的整语义。每一层都在前一层的基础上做一次抽象,层次化分工让深层网络用相对少的参数捕获复杂的模式——浅而宽的网络理论上也能逼近同样的函数,但所需参数量往往大到不可训练。
图:CNN 经典架构演化时间线
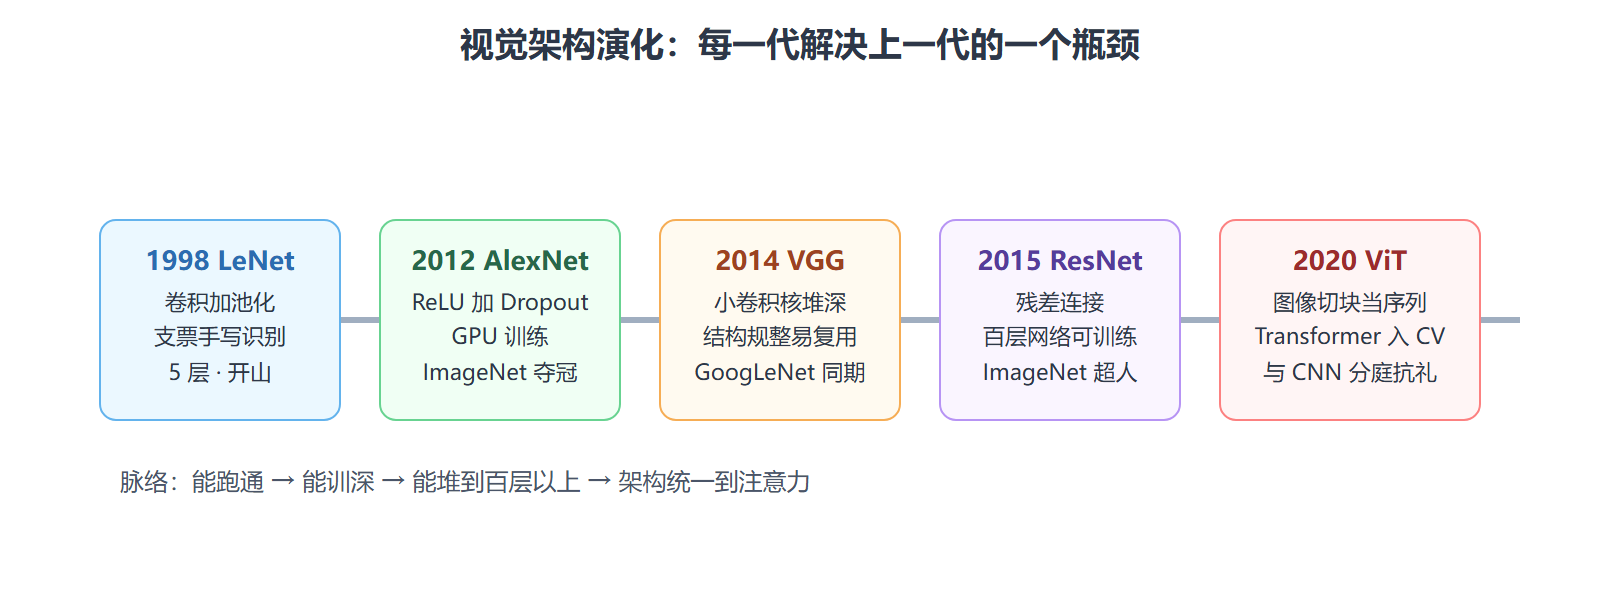
但深也有代价:参数与计算量暴涨、训练梯度在层间传递中衰减(梯度消失)、小数据上极易过拟合。后续所有架构创新几乎都是在回答"怎么把深度的红利兑现而压住它的账单"。
二、六种核心层类型
全连接层:相邻层两两相连,参数量等于两层节点数相乘,是参数大户。主要用于网络末端做特征整合与分类输出;放在图像前端则完全无视空间结构,参数浪费严重。
卷积层:为网格数据(图像)而生。一个小卷积核(如 3 乘 3)在输入上滑动,每个位置做局部加权求和。两大设计:局部感受野——每次只看一小块,匹配"局部像素才相关"的图像先验;参数共享——同一个核扫全图,一个边缘检测器在左上角和右下角都好用,参数量骤降且自带一定平移鲁棒性。
池化层:对局部区域下采样(取最大值或平均值),缩小特征图尺寸、减少计算,并让特征对位置小幅偏移不敏感。它没有任何可学习参数,只是固定规则的下采样。
循环层:为序列数据而生。网络维护一个隐藏状态,每个时间步的输出既依赖当前输入也依赖上一步的隐藏状态——这就是"记忆"。标准 RNN 的问题是长序列上梯度消失/爆炸:误差往回传几十步就衰减殆尽,网络记不住远处的信息。LSTM 引入输入门、遗忘门、输出门三套门控,学会"什么该记、什么该忘、什么该说",能捕捉长距离依赖;GRU 是它的简化版,两个门,参数更少、训练更快。
归一化层:对激活值做规范化(如批量归一化把每批数据拉回零均值单位方差),稳定数值分布,允许更大学习率、加速收敛,附带轻微正则化效果。
Dropout 层:训练时随机把一部分神经元的输出置零,迫使网络不依赖任何单个神经元,等于隐式训练了指数级多个子网络;测试时全部激活并按比例缩放输出。仅训练期生效。
| 层类型 | 可学参数 | 针对的结构先验 | 主要代价 |
|---|---|---|---|
| 全连接 | 极多 | 无(通用整合) | 参数爆炸、过拟合 |
| 卷积 | 少(核共享) | 空间局部性 | 不擅全局长程关系 |
| 池化 | 无 | 平移不变 | 丢失位置精度 |
| 循环 | 中 | 时序性 | 串行慢、梯度消失 |
| 归一化 | 少(缩放平移) | 分布稳定 | 批量小时不稳 |
| Dropout | 无 | 防协同适配 | 训练时间变长 |
三、三种架构模式
残差连接:让输入跨越若干层直接加到输出上——网络学习的目标从"完整输出"变成"输出减输入的残差"。当多层变换学不到东西时,捷径让它们退化为恒等映射,梯度可以沿捷径直达浅层,百层乃至千层网络因此可训练。ResNet 是其在视觉的代表。
Inception 模块:同一层并行使用 1 乘 1、3 乘 3、5 乘 5 卷积与池化,再把结果在深度维拼接——让网络自己决定该看多大的感受野,并用 1 乘 1 卷积先降维省算力。
注意力机制:让网络动态地对输入不同位置分配权重,3.4 节专门展开。
一个卷积网络的典型组装(概念流):
💡 关键直觉:架构设计是在"刻先验"。卷积把"局部相关"刻进网络,循环把"先后有序"刻进网络,注意力把"关系可变"留给网络自己学。数据量越小,越应该选先验强的架构——它替你省下了本需要海量数据才能学到的结构。
⚠️ 常见坑:盲目加深。在几千张图片的小数据集上直接上 50 层残差网络,结果几乎必然是过拟合加上训练缓慢——先用十几层的小网络或迁移学习(拿大数据集上预训练的模型微调)才是正确姿势。
四、感受野、填充与步幅:卷积的三个旋钮
卷积层有三个可调参数,理解它们就理解了特征图尺寸的来源。卷积核尺寸决定单次观察的窗口大小(3 乘 3 是主流默认,两层 3 乘 3 堆叠的感受野等于一层 5 乘 5,但参数更少且多一次非线性,这是 VGG 用小核堆深的思想);步幅决定窗口每次滑动几格,步幅为 2 时输出尺寸约减半,卷积自己就能做降采样;填充在输入边缘补零,控制输出尺寸是否保持不变——补一圈零的 3 乘 3 卷积配步幅 1,输入输出同尺寸,网络设计时尺寸计算简单。
深层卷积网络的感受野随层数增长:浅层只看到几个像素的边缘,到二三十层时单个神经元的感受野已覆盖大半张图——层次化抽象之所以可能,正是因为"看得越来越大"与"抽象越来越高"同步发生。
通道维度的含义。 卷积网络的每个中间层不是一张图而是一叠图(通道):第一层的 64 个卷积核产出 64 张特征图,各自响应一种模式(某个方向的边缘、某种色块过渡)。层数越深通道数通常越大(空间分辨率换语义丰富度),"宽与高的空间信息逐步压缩、通道里的语义信息逐步膨胀"是卷积网络的整体数据流形。
常见问题
网络越深越好吗? 不。给定数据量存在一个"甜蜜深度":太浅欠拟合,太深则训练困难且过拟合,实验发现几十层网络常比更深的表现更好——直到残差连接把更深的网络变得可训练。工程决策以验证集表现为准,深度本身不是目的。
什么时候用预训练模型? 只要能找到任务相近的公开预训练模型就用。视觉任务从 ImageNet 预训练起步几乎是默认动作;NLP 直接用预训练语言模型微调。例外是数据形态特殊的领域(如某些医学影像、光谱数据),通用预训练的特征迁移价值有限,需要领域内预训练或从头训练。
归一化层放哪里、用哪种? 主流位置在线性变换与激活函数之间。批归一化依赖较大批量,训练与推理行为不一致(推理用移动平均统计量);层归一化按样本归一化、与批量无关,是 Transformer 系的标准选择。小批量场景选层归一化更稳。
本节速览
- 深度的红利:层次化表示学习,浅层学边缘词频、深层学部件语义;
- 卷积两支柱:局部感受野加参数共享,参数量小且适配图像;
- 池化零参数:只降采样不改深度,提供平移鲁棒性;
- 循环与门控:隐藏状态带来记忆,LSTM 用三门解决长程梯度消失;
- 残差连接:学残差而非学整体,捷径通路让百层网络可训练;
- 架构即先验:数据结构决定架构选择,小数据更要强先验或迁移学习。
架构再好也只是骨架,下一节讲让骨架学会本领的训练算法:损失、梯度下降与反向传播。