4.1 强化学习:试错中学习决策
4.1 强化学习:试错中学习决策
本节摘要:强化学习让智能体通过与环境交互、依据奖励信号学习最优行为策略,形式化框架是马尔可夫决策过程(MDP),由状态、动作、转移概率、奖励函数与折扣因子五要素定义。本节拆解智能体-环境循环、价值函数与 Q 函数、探索与利用的权衡,以及基于价值(Q-Learning、DQN)、基于策略(策略梯度)、Actor-Critic 三族算法,最后谈强化学习的样本效率与奖励设计两大现实挑战。
先说结论
阅读完本节,你应当能够:
- 画出智能体与环境的交互循环并标出状态、动作、奖励;
- 说出 MDP 五要素与马尔可夫性的含义;
- 解释折扣因子取值偏向对智能体行为的影响;
- 用探索-利用困境解释 ε-贪婪策略;
- 区分基于价值、基于策略、Actor-Critic 三族算法;
- 列举强化学习落地的两大工程挑战。
一、第三种学习信号
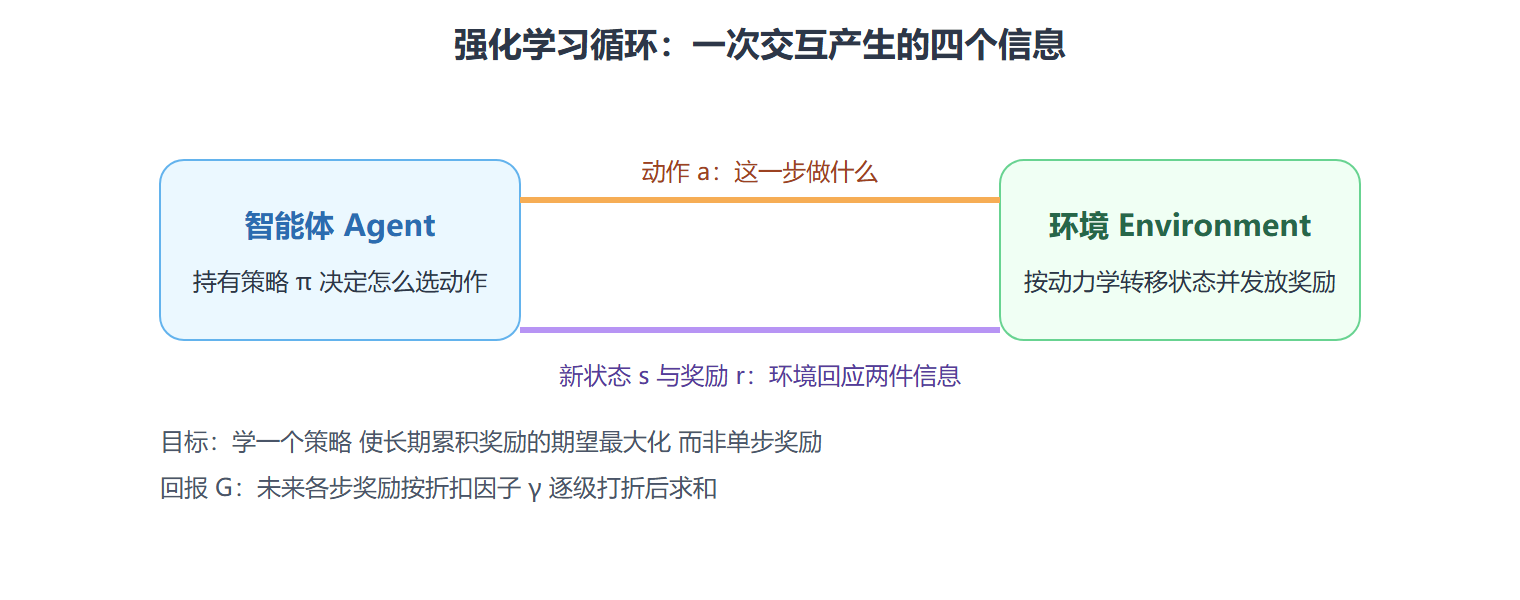
监督学习有标准答案,无监督学习没有信号只有结构,强化学习只有延迟而稀疏的奖惩。智能体在状态 s 下选动作 a,环境反馈奖励 r 并跳到新状态。没有谁告诉你"这步棋下对了",只有下完整局后的输赢——信号不仅延迟,而且稀疏。这种设定最接近真实世界的决策问题:下棋、开车、定价、调度。
交互循环收集到的经验四元组(状态、动作、奖励、新状态)是学习的全部原料。
图:强化学习交互循环要素标注
二、MDP:把决策问题写成数学
马尔可夫决策过程用五元组定义一个强化学习问题:
- S:状态集合;
- A:动作集合;
- P:转移概率——在状态 s 执行 a 后跳到 s 的概率。核心是马尔可夫性:下一状态只依赖当前状态与动作,与更早的历史无关;
- R:奖励函数;
- γ:折扣因子,取 0 到 1 之间。
折扣因子决定智能体的"远见":接近 0 时只顾眼前奖励(明天的快乐几乎不算数),接近 1 时重视长期回报(愿意为远期收益牺牲当下)。回报 G 的定义就是各步奖励按 γ 的幂次逐级打折后求和。金融上的类比最直观:γ 就是利率的倒数视角,明年的 100 元今天值多少,取决于你怎么折现。
两个核心评估量:状态价值函数 V 给"处于状态 s 并继续按当前策略走"打分;动作价值函数 Q 给"在状态 s 执行动作 a 再按策略走"打分。Q 函数特别有用——只要知道每个动作的 Q 值,最优动作就是取最大的那个。
三、探索与利用:强化学习独有的困境
你常去一家熟悉的餐馆(利用已知,稳拿 80 分体验),还是试新开的那家(探索未知,可能 95 也可能 50)?只利用会锁死在次优选择,只探索则永远吃不到好处的红利。经典折衷是 ε-贪婪:以小概率 ε 随机选动作(探索),以 1 减 ε 的概率选当前 Q 值最高的动作(利用),训练过程中 ε 逐步衰减——早期多探、后期多敛。
四、三族算法
基于价值:学 Q 函数,策略由"取 Q 最大的动作"隐式导出。经典 Q-Learning 是离策略的时序差分算法:用下一状态的最大 Q 值更新当前 Q 值,即使实际执行的动作并非最优。当状态空间巨大(如图像输入)时表格存不下 Q 函数,DQN 用深度网络近似 Q 函数,并引入两项稳定化技术——经验回放(把交互存进缓冲池随机抽样训练,打破样本相关性)与目标网络(用一个更新缓慢的副本网络计算目标值,防止追自己尾巴式的震荡)。
基于策略:跳过价值函数,直接学策略 π(输出各动作的概率分布),沿"期望回报对策略参数的梯度"方向优化,基础形式是 REINFORCE。优点是天然支持连续动作空间,缺点是方差大、样本效率低。
Actor-Critic:两者结合——Actor 学策略管行动,Critic 学价值函数管打分,Critic 的评估降低策略梯度的方差。A2C、A3C、DDPG、PPO 都属于这一族,其中 PPO 以实现简单、稳定可靠成为当前最常用的默认选择。
另一条正交的划分是有模型与无模型:前者先学环境的转移模型再规划,后者直接从经验学策略或价值,跳过建模。多数成功应用(含 AlphaGo 的策略网络部分)属无模型路线。
| 算法族 | 学什么 | 代表 | 优势场景 |
|---|---|---|---|
| 基于价值 | Q 函数 | Q-Learning、DQN | 离散动作 |
| 基于策略 | 策略函数 | REINFORCE | 连续动作 |
| Actor-Critic | 策略加价值 | PPO、A3C | 通用、当前主流 |
| 基于模型 | 环境模型 | MCTS 类 | 环境可精确模拟 |
应用版图:游戏(AlphaGo 击败围棋世界冠军、Atari)、机器人控制与路径规划、自动驾驶决策、推荐系统的长期参与度优化、数据中心能耗调度、金融组合管理。
💡 关键直觉:奖励函数是强化学习的"宪法"——智能体不会做你想要的事,只会做你奖励的事。奖励设计漏了一个约束,智能体就会钻空子,这是奖励黑客现象的根源。
⚠️ 常见坑:把仿真器里学到的策略直接搬到现实。仿真与现实的物理差异(摩擦、延迟、传感噪声)会让策略表现骤降,通常需要域随机化或在真实环境少量微调来弥合。
五、DQN 两大技术与落地检查清单
DQN 把 Q-Learning 搬上深度网络时遇到"训练发散"的难题,两项技术解决它,值得细看因为思想被广泛复用。经验回放:把每步交互存进大缓冲池,训练时随机抽一批——打破连续样本间的强相关(相邻状态几乎相同,直接顺序训练等于反复学同一样本),且让每条经验被多次利用,样本效率大增。目标网络:训练目标(下一状态的最大 Q 值)若由正在更新的网络自己算,就是"追着自己的影子跑",目标不停晃动导致震荡;用一个更新缓慢的副本网络来算目标,靶子稳定,训练才收敛。
上强化学习前的检查清单:
- 环境可以模拟或交互成本可接受吗(每条经验的价钱);
- 奖励能否密集给出(稀疏奖励需要专门的信用分配技巧);
- 状态观测是否含决策所需信息(马尔可夫性够不够);
- 失败的代价是什么(真实世界里试错有没有安全网);
- 有没有更简单的监督或规则基线可以先试。
五问有三问答不好,先解决问题再谈算法——强化学习的工程失败极少因为算法不够新,多半因为这些问题没过关。
常见问题
AlphaGo 是纯强化学习吗? 不是。它组合了监督学习(先模仿人类棋谱学策略网络)、强化学习(自我对弈提升)、以及基于模型的搜索(蒙特卡洛树搜索在推理时做规划)。顶层成果几乎都是多技术的编排,而非单一算法的胜利。
什么时候强化学习不如监督学习? 当"最优动作"有历史数据可以模仿时。推荐、风控这类有大量人类决策记录的任务,先用监督(或模仿)学习起步,只有当需要超越历史水平、优化长期累积目标时,强化学习才带来增量价值。
折扣因子取多少合适? 无硬规定。常见 0.9 到 0.999。判断依据是任务的信用传播长度:一步动作的影响延续几百步的任务(围棋)取接近 1;影响很快消散的任务(短期定价)可以取小。极端值都有病:趋近 0 目标短视,趋近 1 训练方差大增。
温故知新
- 第三种信号:延迟而稀疏的奖励,学习目标是长期累积回报最大化;
- MDP 五要素:状态、动作、转移概率、奖励、折扣因子;马尔可夫性即历史无关;
- 折扣因子即远见:趋零短视、趋一长远,取值直接塑造行为风格;
- 探索利用困境:ε-贪婪以小概率随机探索,随训练衰减;
- 三族算法:价值法学 Q 隐式出策略、策略法学分布直接出动作、Actor-Critic 双角色互补,PPO 为常用默认;
- 两大挑战:样本效率低、奖励设计难,是落地的主要瓶颈。
会决策之外,AI 还要学会创造。下一节看生成模型如何学习数据的分布并造出新样本。