4.2 生成模型与自编码器:GAN与VAE
4.2 生成模型与自编码器:GAN 与 VAE
本节摘要:判别模型学习"给定输入预测标签"的条件概率,生成模型学习数据本身的分布,从而能采样生成全新样本。本节先讲自编码器——编码器压缩、解码器重构、以重构误差为损失的学习表示工具,及其潜在空间无约束导致无法直接生成的局限;再讲变分自编码器 VAE 如何用概率化编码加 KL 散度约束把潜在空间"整形"成可采样的正态分布;最后讲生成对抗网络 GAN 的生成器-判别器博弈、训练不稳定与模式崩溃问题,并对比两条路线的生成特性。
核心问题
阅读完本节,你应当能够:
- 区分判别模型与生成模型的学习目标;
- 画出自编码器的结构并说出它的四个用途;
- 解释标准自编码器不能直接当生成模型的原因;
- 说明 VAE 的损失由哪两项构成、各自的作用;
- 描述 GAN 两个网络的对抗训练过程与模式崩溃;
- 按需求在 GAN 与 VAE 之间做选择。
一、学分布与学映射是两回事
分类器学的是"给一张图,输出它是猫的概率"——条件概率,判别模型。生成模型学的是"猫的照片整体长什么样"——数据分布本身。学到分布后能做两件事:采样生成新样本(画一只从没见过但很真的猫)、评估概率(这个样本在分布下概率多低,可做异常检测)。判别模型只回答"是什么",生成模型回答"从哪来",后者的知识更深也更难学。
二、自编码器:学会压缩
自编码器是最朴素的"理解数据"结构,两部分:
- 编码器:把高维输入压缩成低维潜在向量(瓶颈结构强迫它保留最重要的信息);
- 解码器:从潜在向量重建原始输入。
训练目标只有一个:让重建结果尽量像输入(最小化重建误差,如均方误差)。注意整个过程不需要任何标签——输入自己当自己的标签,属于自监督/无监督学习。
四大用途:降维(编码器输出即压缩表示)、特征学习(潜在向量给下游模型当特征)、去噪(训练时输入加噪声、目标用干净原像,学会滤噪)、异常检测(正常样本重建得好,异常样本重建误差大——工业质检的常用套路)。
但标准自编码器不是生成模型:它对潜在空间没有任何约束,相似输入可能被映射到相距很远的点,潜在空间中大片区域解码出来是无意义的乱码。随机挑一个潜在向量喂给解码器,大概率得到噪声——"会压缩"不等于"知道数据的分布"。
三、VAE:把潜在空间整形
变分自编码器的关键改动:编码器不再输出一个确定的点,而是输出一个概率分布的参数(通常是均值与方差,假设为高斯分布)。解码时从该分布采样一个向量再解码。
损失函数相应变成两项之和:
- 重建损失:与普通自编码器一样,保证信息保真;
- KL 散度项:约束每个样本的潜在分布都靠近预设先验——标准正态分布。
KL 项的效果是把整个潜在空间"整形"成连续、规整、无空洞的形态:任意从标准正态分布采样的向量,解码出来都是有意义的样本。生成流程因此极其简单:从先验采样、过解码器、得到新样本。
采样操作本身不可导,训练用的是重参数化技巧:不直接从分布采样,而是"均值加噪声乘标准差"的等价形式,把随机性移出到参数之外,梯度得以回传。
四、GAN:造假者与鉴定师的博弈
生成对抗网络走完全不同的路:两个网络对抗。生成器收随机噪声,伪造样本;判别器收真样本与假样本,判断真假。训练是极小极大博弈:生成器努力骗过判别器,判别器努力识破生成器,互相拉扯中双方的辨识与伪造能力螺旋上升。理想收敛点:生成样本分布与真实分布重合,判别器无从分辨。
图:GAN 与 VAE 生成路线对比
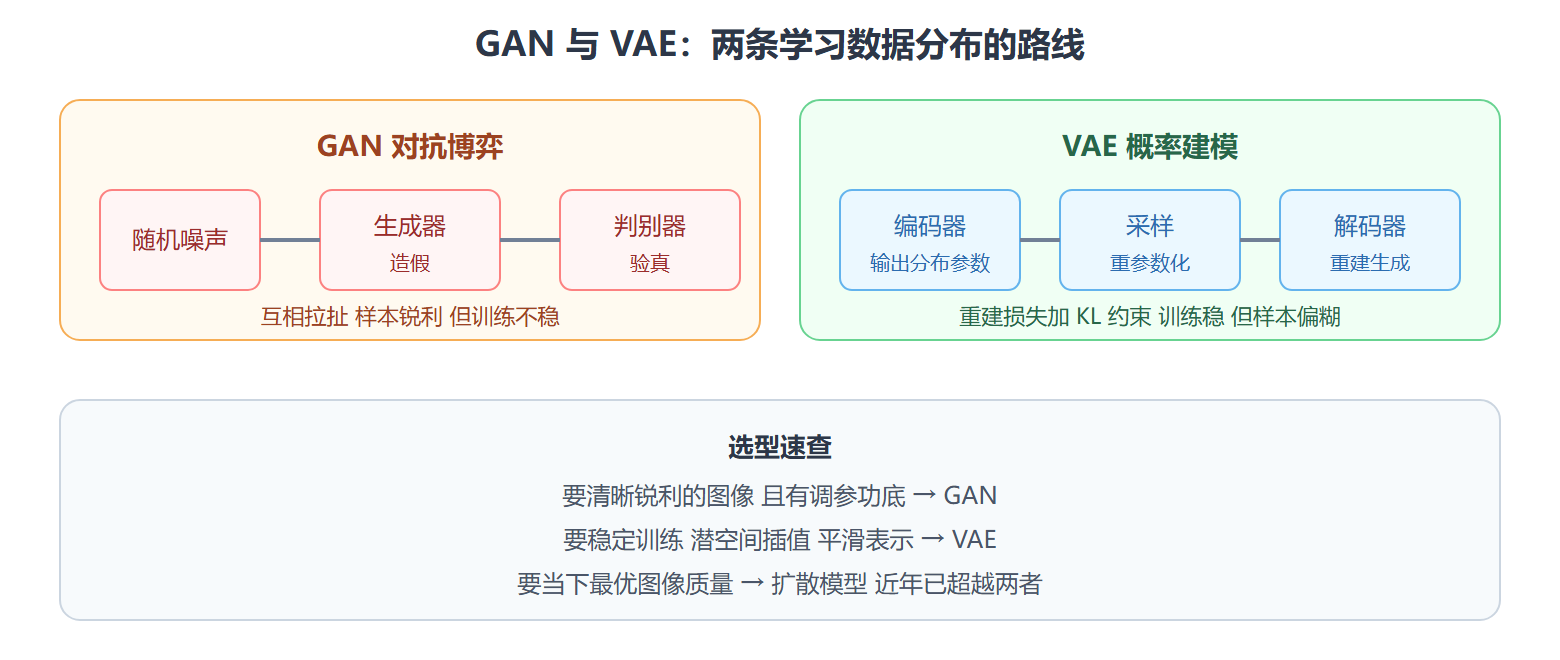
GAN 的两大顽疾:训练不稳定(两个网络的平衡很脆弱,判别器太强生成器学不动,反之亦然)与模式崩溃(生成器发现某几种样本能稳定骗过判别器后,就只生成那几类,多样性坍缩——问它要猫,它给你一千张几乎相同的橘猫)。
| 维度 | 自编码器 | VAE | GAN |
|---|---|---|---|
| 学习目标 | 重构误差 | 重建加 KL 散度 | 对抗博弈 |
| 潜在空间 | 无约束 | 规整可采样 | 隐式无显式分布 |
| 训练稳定性 | 稳 | 稳 | 不稳、需技巧 |
| 生成质量 | 不能直接生成 | 偏模糊 | 锐利逼真 |
| 多样性 | — | 好 | 可能模式崩溃 |
💡 关键直觉:把自编码器当异常检测器时,记得先用"只有正常样本"的数据训练。混入异常样本等于教它重建异常,上线后异常样本也被重建得很好,检测失效。
⚠️ 常见坑:GAN 训练里判别器损失降为零就以为赢了。恰恰相反——判别器完胜意味着生成器什么都学不到;健康的对抗训练中双方损失应当此消彼长、都不归零。
五、扩散模型一瞥与生成模型的评估
扩散模型:从"去噪"学分布。 当下图像生成的主流路线思路很反直觉:给训练图像逐步加噪声直到变成纯噪声,训练一个网络学会每一步"减去一点噪声"。生成时从纯噪声出发反复去噪,图像逐渐浮现。相比 GAN 它训练稳定(单一网络、普通损失,没有博弈平衡问题)、多样性好(没有模式崩溃),代价是生成速度慢(需要几十上百步迭代)与每步计算成本。Stable Diffusion 等系统先用自编码器把图像压到潜在空间再做扩散,大幅降低算力门槛——三种生成思想(自编码、去噪、采样)在同一系统里各司其职。
生成质量怎么评。 人眼评估最直接但不可扩展,两类量化指标通行:一类比较生成样本与真实样本的分布距离(如 inception 分数、FID 分数——分数越低生成分布与真实分布越接近);一类考察覆盖度与精度(生成是否既多样又不越界)。注意指标只能作横向比较的参考,与人类审美判断存在偏差,最终拍板仍需人工抽样。
生成模型的商业落点。 四类最成熟的用途:内容创作辅助(配图、设计草稿)、数据增强(扩充训练集,对类别不均衡尤其有用)、风格迁移与图像编辑、以及异常检测的"反面应用"(用正常数据训练生成模型,无法很好地重建或建模的样本即异常)。
常见问题
VAE 生成的图像为什么发糊? 高斯假设加重建损失的联合效果:每个像素位置的概率分布被建模为高斯,最优解趋向输出分布的均值——多个可能清晰结果平均起来就是模糊。缓解办法包括换更锐利的重建损失、增大潜在维度,或干脆转向 GAN 与扩散路线。
GAN 训练有什么实操心法? 三条经验:判别器别训练得过强(可以控制判别器每轮更新次数)、生成器与判别器的学习率宜小、批量与数据多样性尽量大。再加一条诊断习惯:定期固定噪声向量生成样本——同一噪声的输出演化能直观显示训练是否在进步、是否开始趋同。
用生成数据训练模型可行吗? 谨慎可行。扩充类别不均衡的辅助数据通常有正收益;但生成数据继承生成模型的偏差与盲区,比例过高会让下游模型学到"生成器的世界观"。安全做法是生成数据只占少数、并与真实数据混合评估。
要点速记
- 分野:判别学条件概率,生成学数据分布,后者能采样造新样本;
- 自编码器:编码压缩解码重构,无标签自监督;用途覆盖降维、特征、去噪、异常检测;
- 生成局限:标准自编码器潜在空间无约束,随机采样解码出乱码;
- VAE 两项损失:重建保真加 KL 整形,重参数化让采样可导;
- GAN 博弈:造假者与鉴定师互促,样本锐利但训练不稳、易模式崩溃;
- 路线选择:稳与可插值选 VAE,锐利与多样性选 GAN,图像质量天花板看扩散模型。
原理齐备,下一节看这些技术在语言与视觉两大领域的落地全景。