5.1 数据准备与特征工程
5.1 数据准备与特征工程
本节摘要:数据准备把原始杂乱数据变成干净可训练的形态(探索、清洗、分割、平衡),特征工程把原始字段变成更有信息量的模型输入(创建、转换、编码、缩放、选择)。两者合计通常占据项目一半以上时间,却也是性价比最高的性能来源——一个精心构造的特征常常胜过换三个模型。本节按流水线顺序拆解全套技术,并给出每一步的决策依据与常见错误。
本节导读
阅读完本节,你应当能够:
- 执行一套完整的数据探索流程并说出要找的三类东西;
- 按缺失原因选择删除或填充策略;
- 用统计方法识别异常值并决定处置方式;
- 区分独热编码与标签编码的适用场景;
- 说明标准化与归一化的差异与选择;
- 列举三类特征选择方法及各自的成本。
一、探索先行:改数据之前先懂数据
任何清洗动作之前先做探索性数据分析(EDA):算描述统计(均值、中位数、标准差、极值)看分布范围;画直方图、箱线图、散点图看形态与关系;查缺失比例与可疑取值。要找三类东西:分布问题(偏态、多峰、量纲悬殊)、质量问题(缺失、异常、格式混乱)、关系线索(哪些特征与目标相关、特征之间是否高度冗余)。探索的产出直接决定后面的清洗与特征策略。
二、清洗:处理缺失、异常与不一致
缺失值处理先问原因再动手:比例高且随机缺失的列可以删;数值型常用均值(分布对称时)或中位数(有偏时)填充,分类型用众数;时间序列用前后向填充;要求更高时用其他特征训练模型来预测填充值——成本递增,按需取用。
异常值先用 Z 分数(偏离均值超过三个标准差)或四分位距法(超出上下四分位 1.5 倍 IQR)识别,再判断性质:录入错误(身高 3 米)删或改;真实极端事件(双十一销量)必须保留——它恰恰是模型该学的规律。处置手段从轻到重:保留、对数转换压缩、分位数封顶、删除。
一致性:日期格式统一、单位统一、类别拼写归一("北京"与"北京市")。
三、分割与平衡
清洗后切分训练、验证、测试三集(常见 70 比 15 比 15 或 80 比 10 比 10),纪律在 1.2 节已立:测试集只在最后用一次。切分要在任何"从数据拟合"的处理(缩放、编码、填充)之后应用于训练集、再套用到其余——顺序反了就是泄漏。
类别不平衡(欺诈 1% 对正常 99%)会训练出偏袒多数类的模型。两条矫正路线:过采样增加少数类(简单复制易过拟合,SMOTE 在少数类样本间插值合成新样本更常用);欠采样删减多数类(丢信息,适合多数类样本极多时)。也可不动数据、改为在损失函数中给少数类更高权重。
四、特征工程:从字段到信号
图:特征工程流水线分层透视
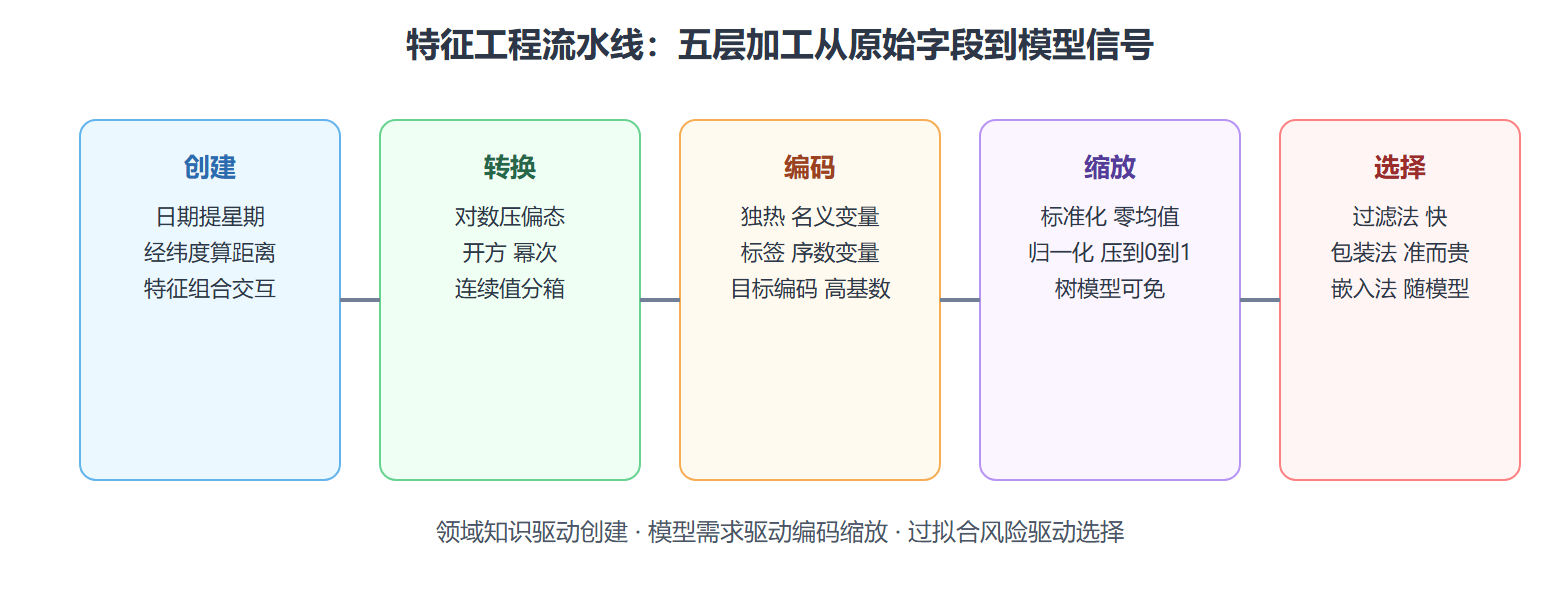
创建最依赖领域知识:电商里"下单时间距上次访问的间隔"可能比原始时间戳有用十倍;金融里"负债收入比"比收入、负债两个原始字段更能刻画风险。
编码的选型规则:名义变量(颜色、城市,类别无顺序)用独热——N 个类别展开成 N 个 0/1 列;序数变量(学历、满意度等级)用标签编码保序;树模型对标签编码不敏感可直接用;类别数极多时独热会爆炸,改用目标编码(但要防泄漏,编码统计只在训练集上算)。
缩放两条路的选择可对照下表:
| 方法 | 变换结果 | 适合的数据 | 弱点 |
|---|---|---|---|
| 标准化 | 零均值单位方差 | 近似正态、有异常值 | 无固定边界 |
| 归一化 | 压缩到 0 到 1 | 需要固定范围 | 对异常值极敏感 |
| 对数变换 | 压缩右偏分布 | 收入、销量类长尾 | 零与负值需先平移 |
具体而言:标准化(减均值除标准差,结果零均值单位方差)适合近似正态或有异常值的特征;归一化(Min-Max 压到 0 到 1)适合需要固定范围的场景,但对异常值极敏感。需要缩放的是距离类与梯度类模型(线性、SVM、KNN、神经网络);树模型按阈值分裂、天然对尺度免疫。
选择三流派:过滤法用统计检验(相关系数、卡方、互信息)独立于模型快速筛,便宜但片面;包装法(如递归特征消除)反复训练模型评估子集,准但昂贵;嵌入法在训练中顺带完成——L1 正则把不重要系数压为零、树模型输出特征重要度。工程上常"过滤法粗筛加嵌入法精选"两段走。
原始字段 300 个 → 过滤法去掉零方差与低相关 → 剩 120 个 → 嵌入法按树模型重要度取前 40 → 与 8 个人工构造业务特征合并 → 最终 48 维输入
💡 关键直觉:模型改进的边际收益递减,特征改进的边际收益稳定。训练卡住时,花一天理解业务再造两个特征,常比调三天参数更有效。
⚠️ 常见坑:把目标编码或缺失值填充的统计量算在全量数据上。所有"从数据学统计量"的步骤都必须只看训练集,再应用到验证与测试集,否则评估指标虚高、上线现形。
五、特征工程的整体流程与验证
把五层加工串成一张流程图,并强调其中的验证环节:
每一步都要验证收益。 特征工程最大的陷阱是"感觉有用"的幻觉:辛苦造了二十个特征,可能只有三个真正带来提升。纪律是用同一个基线模型做对照——每批新特征只改输入、其余不动,指标若无改善就丢弃。特征也遵循收益递减:头五个好特征贡献九成收益,后面五十个可能加起来不到一个点。
时间特征是表格数据的富矿。 交易时间戳本身几乎无信息,但衍生出的"距上次消费天数""是否发薪日后三天""该用户历史同时段活跃度"往往进入重要度前列。凡是与"行为节律"相关的业务(电商、出行、内容),时间衍生特征都是第一优先级的尝试方向。
特征工程与深度学习的关系。 特征工程是给传统模型"喂饭"——模型没有能力自己消化原始字段,必须人先嚼碎。深度学习在图像文本上省去了这一步,但表格数据的深度模型依然受益于人工特征(把业务知识编码成输入永远不亏)。两代技术不是替代关系,而是"特征自动化"程度不同。
常见问题
怎么知道一个特征该不该删? 三个信号满足其一即可考虑删除:与目标的相关性接近零且业务上无理由保留、与其他特征高度冗余(相关系数零点九以上留一个即可)、加入后验证指标不升反降。特征贵精不贵多,每个特征都要能说出"它为什么应该有用"。
类别有几千个取值怎么编码? 高基数类别的三个方案:目标编码(用该类别的历史目标均值替代类别值,需防泄漏并做平滑)、频率编码(用出现次数替代)、嵌入编码(训练中学习类别向量)。树模型下目标编码常最有效;线性模型下嵌入更稳。
分箱会不会丢信息? 会,这是分箱的代价。换来的好处是能刻画非线性(每个箱独立权重)与抗异常值。适合与线性模型搭配挽救表达力;树模型自己会找切分点,人工分箱基本多余。
本节速览
- 探索先行:改数据前先弄清分布、质量、关系三件事;
- 缺失看原因:删除、简单填充、模型填充成本递增按需取用;
- 异常先判性质:错误删、真极端留,别把信号当噪声;
- 编码看变量类型:名义独热、序数标签、高基数目标编码防泄漏;
- 缩放看模型:距离与梯度类必须缩放,树模型免疫;
- 选择两段走:过滤粗筛加嵌入精选,兼顾成本与精度;
- 顺序纪律:先分割、统计量只从训练集拟合,是防泄漏的生命线。
数据与特征决定了上限,下一节讲怎么可靠地测出模型离上限有多远。