5.2 模型评估与选择
5.2 模型评估与选择
本节摘要:模型评估回答"模型在没见过的数据上表现如何",核心工具是以混淆矩阵为基础的指标族(准确率、精确率、召回率、F1、AUC 与回归侧的 MSE、MAE、R 方)与 K 折交叉验证;模型选择则要在性能之外综合考虑复杂度、速度、可解释性与业务对齐。本节重点讲清指标之间的取舍逻辑——精确率与召回率的跷跷板关系必须由业务成本决定,而非算法决定。
本节导航
阅读完本节,你应当能够:
- 画出混淆矩阵并手工推导四项基础指标;
- 按业务代价在精确率与召回率之间做取舍;
- 说明 AUC 为何对类别不均衡不敏感;
- 描述 K 折交叉验证的完整流程;
- 在网格、随机、贝叶斯三种调参法中选择;
- 复述测试集"只能用一次"的纪律及其理由。
一、先有纪律,再有指标
三条铁律在动手算指标之前:训练集调参数、验证集调超参数与选模型、测试集只在最终做一次评估。测试集一旦参与了任何决策(哪怕只是"看了结果决定再调一轮"),它的"未知数据"属性就被污染,指标随之虚高。用完想再迭代?只能重新收集或重新划分新的测试数据。
二、混淆矩阵:一切分类指标的母体
对二分类问题,预测与真实交叉出四个格子:
| 真实为正 | 真实为负 | |
|---|---|---|
| 预测为正 | 真正例 TP | 假正例 FP |
| 预测为负 | 假负例 FN | 真负例 TN |
四个格子衍生四项核心指标:
- 准确率 等于对的总数除以总数。类别均衡时可用;欺诈占 1% 时,全预测正常即得 99% 准确率——毫无意义;
- 精确率 等于预测为正里真为正的比例。问的是"我说的阳性有多干净";
- 召回率 等于真实为正里被抓到的比例。问的是"该抓的抓全了吗";
- F1 是精确率与召回率的调和平均,两者都低时被重罚,需要单一指标平衡两者时用。
图:混淆矩阵与指标可视化
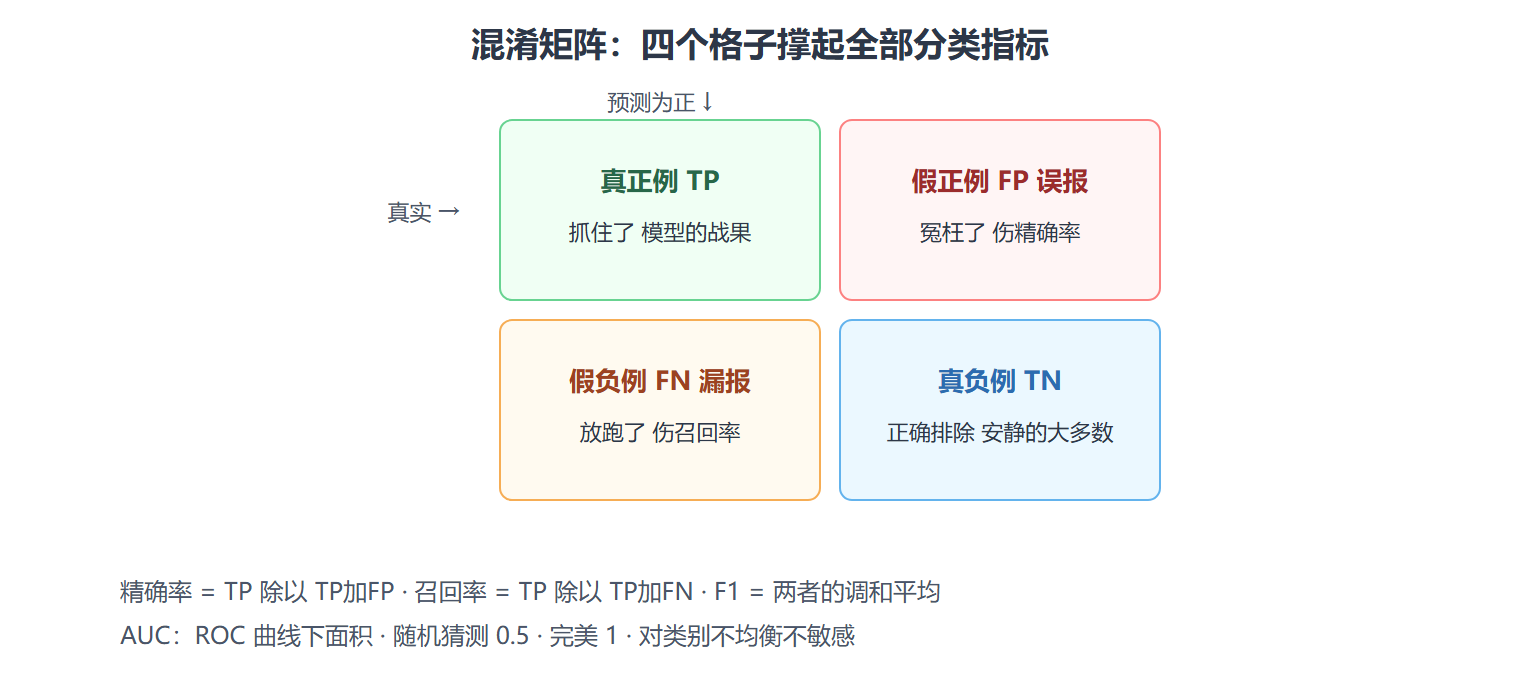
精确率与召回率是跷跷板:调高判定阈值,抓得更准(精确率升)但漏得更多(召回率降);调低反之。压哪头必须由业务代价决定:癌症筛查宁可误报(多做个复查)不可漏报,重召回;垃圾邮件拦截宁可放过(进收件箱看一眼)不可误杀(丢工作邮件),重精确率。ROC 曲线描绘阈值从严到松过程中真阳性率与假阳性率的轨迹,AUC 是曲线下面积——它衡量模型整体的区分能力,且因为考察的是排序而非固定阈值,对类别不均衡天然稳健。
三、回归与聚类指标
回归侧四件套:均方误差 MSE(平方放大大误差,对异常敏感)、均方根误差 RMSE(开方后与目标同量纲、可解释)、平均绝对误差 MAE(绝对值、对异常鲁棒)、R 方(模型解释方差的比例,越接近 1 越好,小于 1 的模型还不如直接用均值预测)。
聚类没有真值,靠内部指标:轮廓系数同时度量簇内紧凑与簇间分离,取值负一到一,越接近一越好;簇内平方和等指标需配合使用(其随簇数单调下降,不能单看)。
四、交叉验证:小数据的可靠解法
单次切分结果受随机划分影响大。K 折交叉验证把数据切成 K 份(常用 5 或 10),轮流用其中一份做验证、其余 K 减 1 份做训练,重复 K 次取平均——每个样本都当过一次验证样本,评估更稳定,也更能反映泛化能力。
五、超参数调优三法
- 网格搜索:枚举预设的所有组合,完备但计算量随维度组合爆炸;
- 随机搜索:随机采样组合,同等预算下常比网格更高效——因为重要超参数往往只有一两个,随机更容易在关键维度上探索到好值;
- 贝叶斯优化:用概率模型拟合"超参数到性能"的响应面,智能挑下一个尝试点,样本效率最高,适合单次评估昂贵的场景(如大模型)。
调优始终在交叉验证框架内进行;最终胜出配置再到测试集上考一次。
六、选择不只看分数
| 考量维度 | 问题 | 典型取舍 |
|---|---|---|
| 性能差距 | A 比 B 高两个点,统计显著吗 | 差距小于交叉验证波动则视为打平 |
| 训练与预测成本 | 能否按时训完、上线后延迟达标吗 | 大模型常输给小模型因为延迟预算 |
| 可解释性 | 监管或客户要求解释吗 | 金融医疗倾向简单模型 |
| 维护复杂度 | 团队养得动吗 | 复杂集成的运维成本常被低估 |
| 业务对齐 | 指标方向与业务目标一致吗 | 优化点击率可能伤害留存 |
💡 关键直觉:报告指标时永远带上交叉验证的方差。只报一个点估计("准确率 93%")而不报波动区间,等于把测量误差伪装成了模型能力。
⚠️ 常见坑:按精确率选了模型,上线后业务方抱怨漏报。指标选择必须在建模前与业务方白纸黑字对齐——漏报与误报的相对代价是多少,这个数字决定一切。
七、常见误用与场景化指标选择
阈值不是默认的。 分类模型输出的是概率分数,默认以 0.5 为界只是约定。业务上最优阈值应由代价矩阵决定:把漏报代价与误报代价代入,选择使总代价最小的切分点——反欺诈场景算出来的最优阈值可能是 0.2 而不是 0.5。上线前做一次阈值优化,是零成本换取真实收益的动作。
指标也要看置信区间。 一万条测试样本上 93% 准确率的九五百分比置信区间大约有正负 1.6 个百分点——两个模型差 0.5 个点的"胜利"在这个样本量下毫无统计意义。判断两模型差异是否真实,可以比较交叉验证各折的结果分布,或做显著性检验;分不清时按"更简单模型优先"裁决。
按场景选主指标速查:
| 场景 | 主指标 | 理由 |
|---|---|---|
| 疾病筛查 | 召回率 | 漏诊代价远高于误诊复查 |
| 垃圾邮件拦截 | 精确率 | 误杀正常邮件代价高 |
| 信贷违约预测 | AUC 加坏账率 | 看排序能力与业务结果 |
| 销量预测 | MAE 或加权 MAE | 与库存成本直接挂钩 |
| 推荐排序 | 命中率加多样性 | 业务目标复合 |
常见问题
训练、验证、测试的比例必须七比一点五比一点五吗? 不必,数据量大时可以给测试集留更小比例(百万级数据留百分之一也有上万条);数据量小时改用交叉验证替代固定验证集。原则只有一条:测试集要足够大到指标稳定,且全程不可触碰。
交叉验证的 K 选几? 常用 5 或 10。K 大评估偏差小但方差大、计算贵;K 小反之。类别不均衡或数据极小时可考虑分层 K 折(每折类别比例一致)保证每折可学。
线上指标和离线指标对不上怎么办? 先查三件事:离线测试集与线上数据分布是否一致(采样偏差)、特征在线上是否被同样计算(离线特征口径与实时口径常有微妙差异)、线上是否有干预(运营策略改变了模型看到的数据)。三者排查完仍对不上,才考虑模型本身的问题。
重点提炼
- 三集纪律:训练调参、验证调超参、测试只考一次,测试集碰过就报废;
- 混淆矩阵是母体:四格推出准确率、精确率、召回率、F1;
- 不均衡弃准确率:改看精确率、召回率、F1 与 AUC;
- 精确召回跷跷板:由业务代价定方向,算法无权决定;
- 交叉验证:K 折平均抗划分随机性,小数据必备;
- 调参三法:网格完备、随机高效、贝叶斯省样本;
- 选择是多目标:性能、成本、解释性、维护度一起算账。
选定了模型,下一节把它送进生产环境并守住它的长期表现。