5.4 AI伦理、可解释性与安全性
5.4 AI 伦理、可解释性与安全性
本节摘要:负责任的 AI 由三根支柱构成——伦理关注公平、隐私与问责,可解释性(XAI)用 LIME、SHAP 等方法揭开黑盒决策的依据,安全性防御对抗样本、数据投毒与模型窃取等恶意攻击。三者相互依存:可解释性是发现偏见与漏洞的前提,安全是公平得以兑现的底座,伦理原则则定义前两者的努力方向。本节从技术视角拆解每根支柱的核心问题、代表方法与工程对策。
学习目标
阅读完本节,你应当能够:
- 说出偏见进入 AI 系统的三条途径与公平性干预的三个阶段;
- 解释差分隐私与联邦学习各自的保护思路;
- 区分透明模型与黑盒解释两类可解释性路线;
- 描述 LIME 与 SHAP 的工作机制差异;
- 解释对抗样本的成因与对抗训练的防御逻辑;
- 说明伦理、可解释性、安全性三者互相支撑的关系。
一、伦理:算法的道德罗盘
偏见与公平是最受关注的伦理议题。偏见从三条途径潜入系统:数据偏见——训练数据没有代表性或本身沉淀了历史不公(用过去十年的招聘记录训练筛选模型,历史上的性别倾向会被原样学会甚至放大);算法偏见——建模选择无意放大某些特征的作用;互动偏见——系统从带偏的用户行为中持续学习并固化偏见。公平性干预可分三段:训练前的数据预处理(重加权、重采样)、训练中在损失函数加入公平性约束、训练后对输出做校准。麻烦在于"公平"本身有多种数学定义(统计平等、机会均等、个体公平),它们在数学上常常互不兼容——选哪种公平本质是价值选择,不是技术选择。
隐私:技术应对有三件套。差分隐私在数据或统计输出中加入精心设计的噪声,使得任何单一个体的存在与否对结果影响微乎其微;联邦学习让模型留在用户设备本地训练,只上传参数更新、原始数据不出域;安全多方计算允许多方在不泄露各自数据的前提下协同完成计算。
问责:AI 出错谁负责——开发者、部署者、使用者还是数据方?黑盒模型让原因追溯困难,问责链必须在设计阶段就明确。
二、可解释性:揭开黑盒
为什么必须解释:建立信任(用户与监管需要依据)、调试改进(理解错误才能修数据与模型)、合规要求(金融信贷、医疗诊断等场景法规强制解释权)、偏见检测(看模型用了什么特征才能发现歧视)。
两条路线:用透明模型(线性回归、决策树,其决策过程自身可读)或解释黑盒。后者两员主将:
- LIME(局部可解释、模型无关):在待解释样本的邻域扰动生成一批新样本,用一个简单线性模型去拟合黑盒在这些点上的输出——"在这个样本附近,黑盒的行为近似于这条规则";
- SHAP(基于博弈论 Shapley 值):把预测看作合作博弈的收益,把每个特征当玩家,公平地计算各自边际贡献——理论坚实、可给出全局与局部一致的特征归因。
| 维度 | LIME | SHAP |
|---|---|---|
| 思路 | 邻域局部线性近似 | 博弈论特征贡献分配 |
| 理论保证 | 弱(依赖扰动方式) | 强(公理化基础) |
| 计算成本 | 较低 | 较高(有近似加速实现) |
| 输出 | 单样本局部解释 | 局部加全局一致 |
模型特定方法也常用:卷积网络的特征可视化直接展示各层"看到了什么";注意力权重可作参考线索(但如 3.4 节提醒的,权重不是严格解释)。
固有权衡:解释性与性能常常此消彼长——复杂模型更准但更难解释。XAI 的意义正是在不牺牲性能的前提下给复杂模型配上解释通道;此外"解释的质量"本身也需评估,一个误导性的解释比没有解释更危险。
三、安全性:对抗与防御
对抗样本:在输入上加人眼无法察觉的微小扰动,就能让模型彻底改判——熊猫照片加一层噪声被高置信度认成长臂猿。成因在于模型的决策边界过于贴近数据流形,微扰即可跨过。防御手段:对抗训练(把对抗样本混进训练集,强迫模型对扰动鲁棒,当前最有效)、输入检测过滤、防御性蒸馏(效果有限)。自动驾驶的停车标志识别是对抗风险最刺眼的场景。
数据投毒:攻击者在训练数据中注入恶意样本,让模型学到后门——正常输入表现正常,特定触发出现时输出攻击者指定的结果。防线在数据入口:来源验证、异常样本清洗、训练管线权限管控。
模型窃取与推断攻击:攻击者反复查询线上模型接口,重构出功能相近的副本(窃取知识产权);或从输出概率反推某条记录是否在训练集里(成员推断,泄露隐私)。对策:限制查询频率与返回精度、模型加密部署、输出加噪。
图:负责任 AI 三支柱关系图
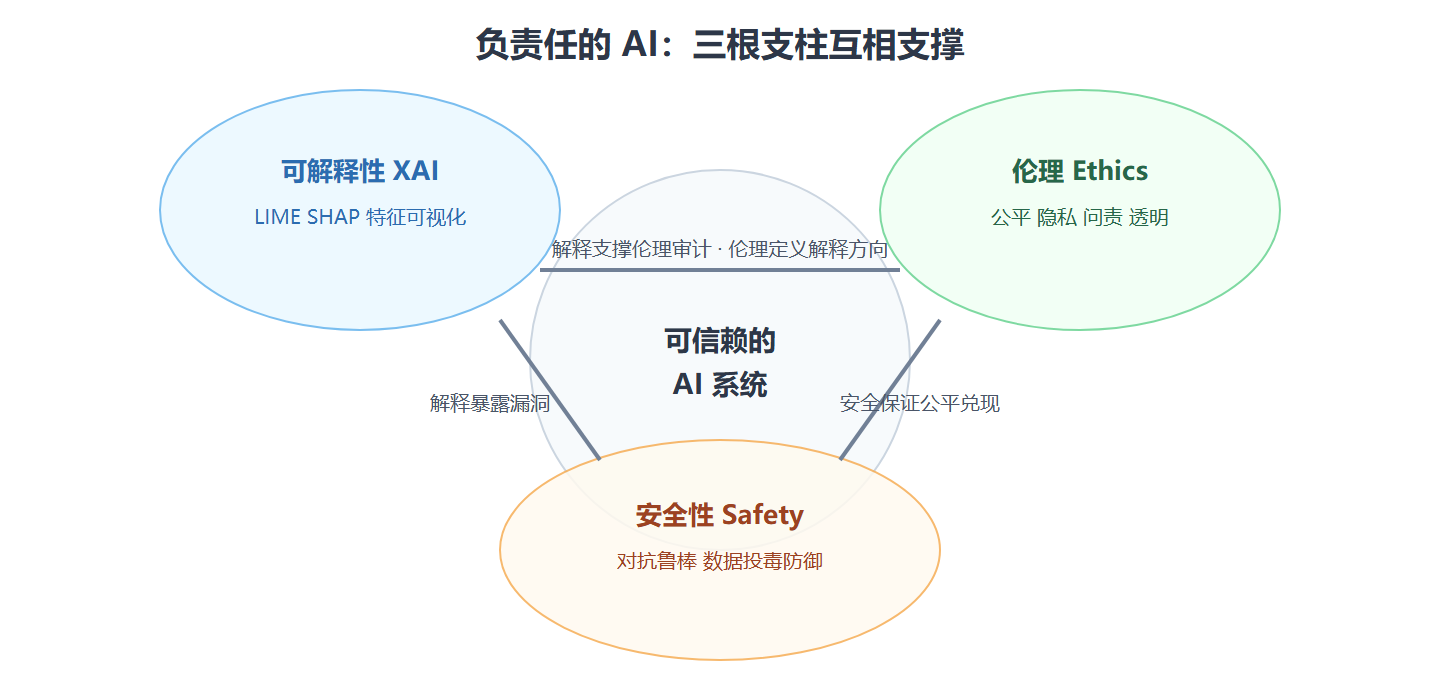
三支柱的逻辑关系:可解释性服务于伦理与安全(发现偏见与漏洞的前提)、安全性是伦理的前提(被攻破的系统谈不上公平与隐私)、伦理指导前两者的方向(公平、问责、透明的原则定义了什么值得解释、什么必须设防)。现实约束是权衡:性能、可解释性、安全性、开发成本很难同时拉满,按应用场景排优先级——医疗诊断把可解释性放前排,反欺诈把鲁棒性放前排。
💡 关键直觉:伦理不是上线前的合规检查表,而是设计约束。数据收集阶段就问"样本覆盖了哪些群体、漏了谁",比事后给有偏模型打补丁便宜一个数量级。
⚠️ 常见坑:把 SHAP 值当因果结论汇报。特征归因回答"模型依据什么做判断",不回答"现实中什么导致结果"——用归因图指导决策干预,可能完全无效甚至有害。
四、合规图景与伦理落地清单
主要法域的监管框架正在把前述技术议题变成硬性义务:自动化决策需要向个人提供解释、高风险场景(信贷、招聘、医疗)要做影响评估、数据收集要有明确合法性基础。对工程团队而言,合规不是法务一个部门的事——它直接翻译为技术需求:能导出每笔决策的解释、能复现任何历史版本的模型行为、能证明训练数据的来源合规。这些能力都无法事后补建,必须从第一次训练就埋进管线。
伦理落地检查清单(立项与上线各过一遍):
- 训练数据对目标人群的覆盖是否有系统性缺口;
- 敏感属性(或其代理变量)是否被不当使用;
- 是否定义了可操作的公平性指标并写进验收标准;
- 隐私保护手段(最小化收集、脱敏、联邦或差分)是否与数据敏感度匹配;
- 决策解释能否以业务语言呈现给受影响方;
- 对抗鲁棒性是否按威胁模型做过测试;
- 出错时的责任链与补救流程是否明确到人。
公平性监控的特殊性。 上线后的公平审计不是一次性的:模型在不同群体上的表现差异会随用户构成变化而漂移,需要与性能监控并列一条"分群体指标"曲线,差异超阈即触发复核。这里有个真实的两难——分群体监控本身需要感知群体属性,与隐私最小化原则存在张力,工程上的折衷是聚合统计、不落个体明细。
常见问题
解释和准确率只能二选一吗? 不是非黑即白。多数实践用"分层解释":对外给出简化解释(主要影响因素),对内保留完整的 SHAP 明细用于调试与审计。此外解释技术本身在进步,高准确率加可接受解释的组合范围正在扩大。
小团队没有伦理专员,怎么起步? 从上文的检查清单做起——它不需要专职人员,需要的是把七个问题在评审会上问出来。真正的风险不是没有专家,而是没有人问这些问题。
对抗攻击离普通业务远吗? 比想象中近。任何对外暴露预测接口的业务(风控、内容审核、反爬)都可能被探测与利用,程度不同而已。起步动作很朴素:限流、监控异常查询模式、对输入做合法性校验——这些常规 Web 安全措施就挡掉了大部分现实威胁。
要点串联
- 偏见三入口:数据、算法、互动,干预分训练前中后三段;多种公平定义互不兼容,选择即价值判断;
- 隐私三件套:差分隐私加噪声、联邦学习数据不出域、多方计算协同不解密;
- 解释两路线:透明模型自带可读性;黑盒靠 LIME 局部近似与 SHAP 博弈归因;
- 对抗样本:微扰跨过决策边界致误判,对抗训练是最有效防御;
- 投毒与窃取:污染训练植入后门、查询接口重构模型,防线分别在数据入口与服务出口;
- 三支柱互相咬合:解释是审计前提、安全是公平底座、伦理定方向;
- 工程现实:各目标难以兼得,按场景排优先级而非追求全优。
至此,从机器学习概念到神经网络原理、再到工程实践与伦理边界的主线全部走完。带着这些原理去读任何新模型,你都该先问三个问题:它的数据从哪来、它靠什么泛化、它失败时谁来负责。