5.3 模型部署与监控
5.3 模型部署与监控
本节摘要:部署把训练好的模型变成生产环境里可持续提供预测的服务,监控则在上线后持续追踪技术健康、数据分布与业务效果,两者的衔接构成 MLOps 闭环。本节比较在线、批量、边缘三种部署形态,介绍蓝绿与金丝雀两类发布策略,重点拆解数据漂移与概念漂移这两种"模型变质"的成因与发现方式,最后给出监控指标体系与触发再训练的运维闭环。
读前必看(上)
阅读完本节,你应当能够:
- 按延迟、隐私与流量特征选择部署形态;
- 说明蓝绿部署与金丝雀发布的差异与适用场景;
- 区分数据漂移与概念漂移并各举一例;
- 列出模型上线后应监控的四类指标;
- 设计一个"监控告警到再训练"的闭环流程。
一、部署:三种形态各管一段
在线预测:模型作为常驻服务,通过接口实时响应单条或小批量请求,要求低延迟高吞吐,适合风控审批、搜索排序。批量预测:定时对大批数据离线跑一遍,无实时要求,适合信用评分月报、用户分群标签。边缘部署:模型压缩后装进手机、摄像头、车载设备,省带宽、保隐私、降延迟,但要面对算力与模型体积的严格约束,通常需要量化、剪枝与专用推理引擎。
| 形态 | 延迟要求 | 典型场景 | 主要挑战 |
|---|---|---|---|
| 在线服务 | 毫秒到百毫秒 | 实时风控、推荐 | 高并发、稳定性 |
| 批量离线 | 小时级 | 月度评分、报表 | 调度与数据管道 |
| 边缘端侧 | 本地即时 | 质检相机、手机 | 模型压缩、硬件适配 |
发布新版本时的两条安全路径:蓝绿部署同时运行新旧两套环境,流量一次性从旧切到新,出问题立即切回——回滚最快,但要双倍资源;金丝雀发布先把新版本放给一小部分流量,观察指标正常再逐步放大——风险释放最平缓,是模型类服务的常用选择。
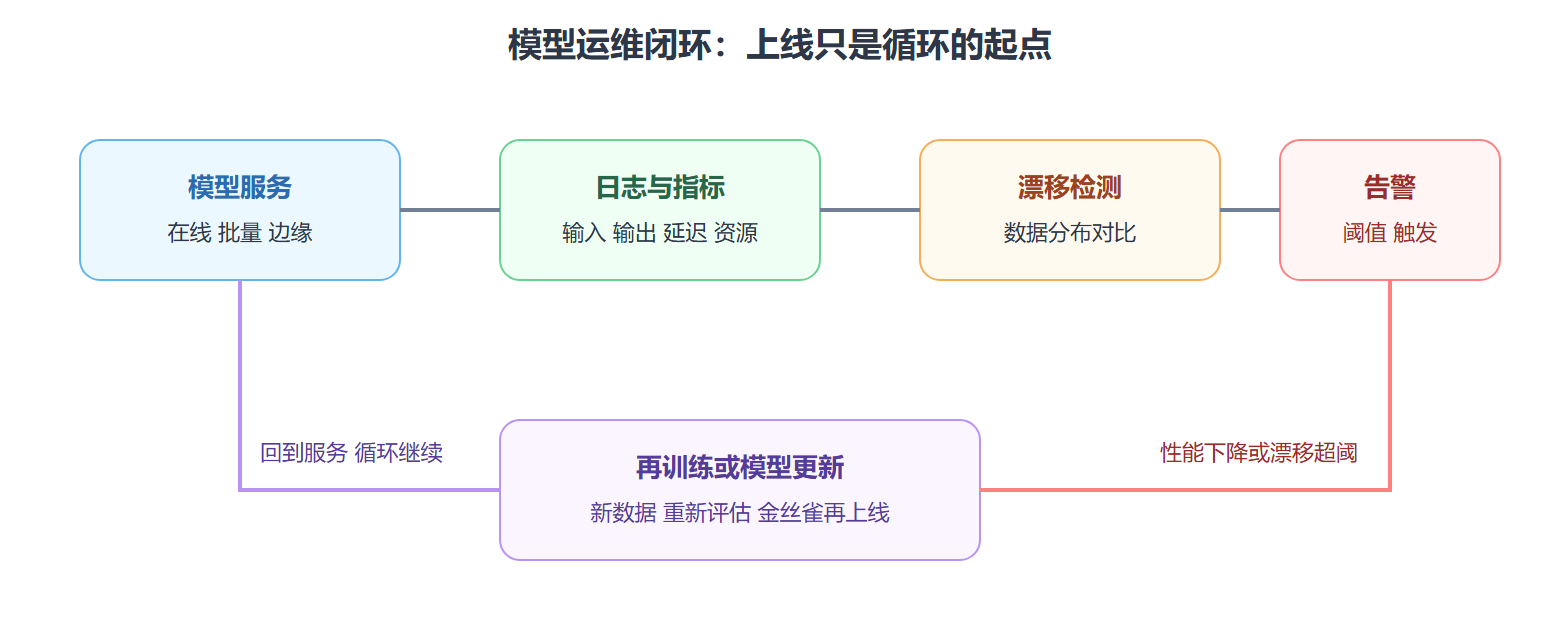
图:部署-监控-再训练运维闭环
二、监控:四类指标一个都不能少
技术健康:延迟(单请求耗时)、吞吐(每秒请求数)、错误率(超时、崩溃、格式错误)、资源占用(CPU、内存、GPU)。这是运维的基础盘,异常最先在这里露头。
数据质量:输入特征的均值、方差、分位数、缺失率、类别构成是否与训练时一致;格式合法性检查。输入分布变了,模型再好也白搭。
模型效果:有真实标签回流时直接算线上准确率、召回率等指标(注意标签常滞后——欺诈是否成立可能要几周后才知道);标签未到时先监控预测分布本身(预测概率的构成若系统性偏移,往往预示问题)。
业务指标:点击率、转化率、坏账率——模型价值的最终裁判,但滞后最长,需要与前三类配合定位因果。
三、漂移:模型变质的两种方式
数据漂移:输入分布本身变了,输入与输出的关系没变。例:训练时用户以一线城市为主,产品下沉后三四线用户涌入——特征分布整体平移,模型在新区域的表现可能骤降。
概念漂移:输入分布没变,但输入与目标的关系变了。例:疫情改变消费习惯,同样的"收入加浏览历史"对应的购买意愿完全不同——旧规律失效。
发现方式:数据漂移可用统计检验对比训练与线上分布(如 KS 检验),可自动化监测;概念漂移更隐蔽,通常只能通过线上性能指标下滑间接发现,等标签回流后确诊。应对共同手段都是用新数据再训练,区别在于概念漂移往往还需要重新审视特征与标签定义是否仍然成立。
四、MLOps:把闭环自动化
MLOps 把 DevOps 的自动化理念搬到机器学习:部署走自动化流水线(新模型版本自动测试、自动灰度);监控不只是看板,而是触发器——漂移或性能告警自动拉起再训练任务、重跑评估、按策略重新发布;监控数据回流为下一轮训练提供样本。数据-模型-部署-监控四个环节首尾相接成环,模型从"交付物"变成"持续运营的服务"。
一个最小闭环的要素清单(概念流程):
1 日志:输入快照 + 预测结果 + 延迟 2 指标:技术健康 · 输入分布 · 预测分布 · 延迟标签的线上效果 3 检测:分布对比统计量 + 效果阈值 4 告警:分级通知 + 自动建单 5 动作:人工核查 → 再训练 → 离线评估 → 金丝雀上线
💡 关键直觉:上线第一天就把监控建好,别等出事再补。漂移是缓慢发生的,没有基线快照(训练时输入分布的画像),等发现效果下滑时已经无从对比——基线必须在模型还健康时拍下。
⚠️ 常见坑:只监控技术指标不看数据分布。服务延迟完美、错误率为零,但输入早已漂移千里——系统"健康地输出着过期模型的结果",这类问题技术告警完全发现不了。
五、部署工程要点与监控指标全景
部署的技术链路可以用一张时序图理清各角色协作:
训练与推理的一致性陷阱。 线上效果莫名变差时,头号嫌疑是"离线特征与在线特征算得不一样":离线用批处理口径、在线用流式口径,一个时间窗的起止差异就足以让特征值错开。工程对策是特征共享——离线训练与在线服务调用同一套特征定义与实现,从根上消灭两套口径。
模型版本与回滚。 每个上线的模型版本要绑定三样东西:训练数据快照版本、代码与超参数配置、评估报告。三者齐备才谈得上可复现。保留上一版本的运行能力(蓝绿的另一层意义),出问题三十秒内切回——回滚速度就是事故时长。
监控指标全景分层:
| 层级 | 指标举例 | 异常含义 |
|---|---|---|
| 基础设施 | CPU 内存 错误率 | 服务本身故障 |
| 服务性能 | 延迟 吞吐 超时率 | 容量或代码问题 |
| 数据质量 | 特征分布 缺失率 格式合法率 | 上游管道异常 |
| 模型行为 | 预测分布 分数均值 | 输入漂移或模型退化 |
| 业务效果 | 转化率 坏账率 客诉量 | 最终价值受损 |
排查自下而上:底层正常才往上层追,多数事故停在前两层,而最危险的正是只盯前两层、放过后三层。
常见问题
多久再训练一次? 按数据变化的节奏定,不按日历。变化快的场景(新闻推荐、价格)按天甚至按小时;变化慢的场景(人口属性建模)按季度。更好的答案是事件驱动——漂移检测超阈值才触发,比定时重训既省钱又及时。
冷启动的新模型怎么安全上线? 影子模式先跑:新模型与旧模型并行接收流量但只记录不返回,对比一段时间分歧样本,确认无异常后再按金丝雀逐步放量。代价是双份算力,换来零风险的验证期。
模型监控谁负责? 明确写到岗位职责里。常见断档是"算法团队以为平台在盯、平台以为指标正常没人看"——上线评审时把监控面板的负责人、告警的响应人、再训练的触发人一一落实到人名,这一页纸比任何工具都防事故。
本章回顾
- 三种形态:在线重并发、批量重调度、边缘重压缩,按延迟与隐私选型;
- 发布策略:蓝绿回滚最快、金丝雀风险释放最平缓;
- 四类监控:技术健康、数据质量、模型效果、业务指标,层层递进;
- 两种漂移:数据漂移是输入分布变了、概念漂移是规律变了,前者可自动检测、后者靠效果回溯;
- 再训练闭环:监控告警触发、新数据训练、离线评估、灰度上线,四步缺一不可;
- MLOps 本质:把模型当持续运营的服务,而非一次性交付物。
系统跑起来了,最后一节面对更根本的问题:它公平吗、可解释吗、安全吗。