1.1 最小流水线总览
1.1 最小流水线总览
本节摘要:ARIMA(p,d,q) 是对差分后的平稳序列同时做自回归和滑动平均。动手时不要从公式展开,而从 Box-Jenkins 四步走:识别、估计、诊断、预测。本节给出一条示意序列上的最小路径,标明本章停在「给出候选阶」,拟合和滚动预测在第 2 章完成。
学习目标
阅读完本节,你应当能够:
- 用自己的话解释 p、d、q 各自对应流水线的哪一步。
- 画出识别阶段的循环:不平稳就差分,残差不白就回到定阶。
- 在示意数字上口述一遍「先差分再定阶」的顺序,并说出为什么不能对调。
一、先把三个字母钉在工序上
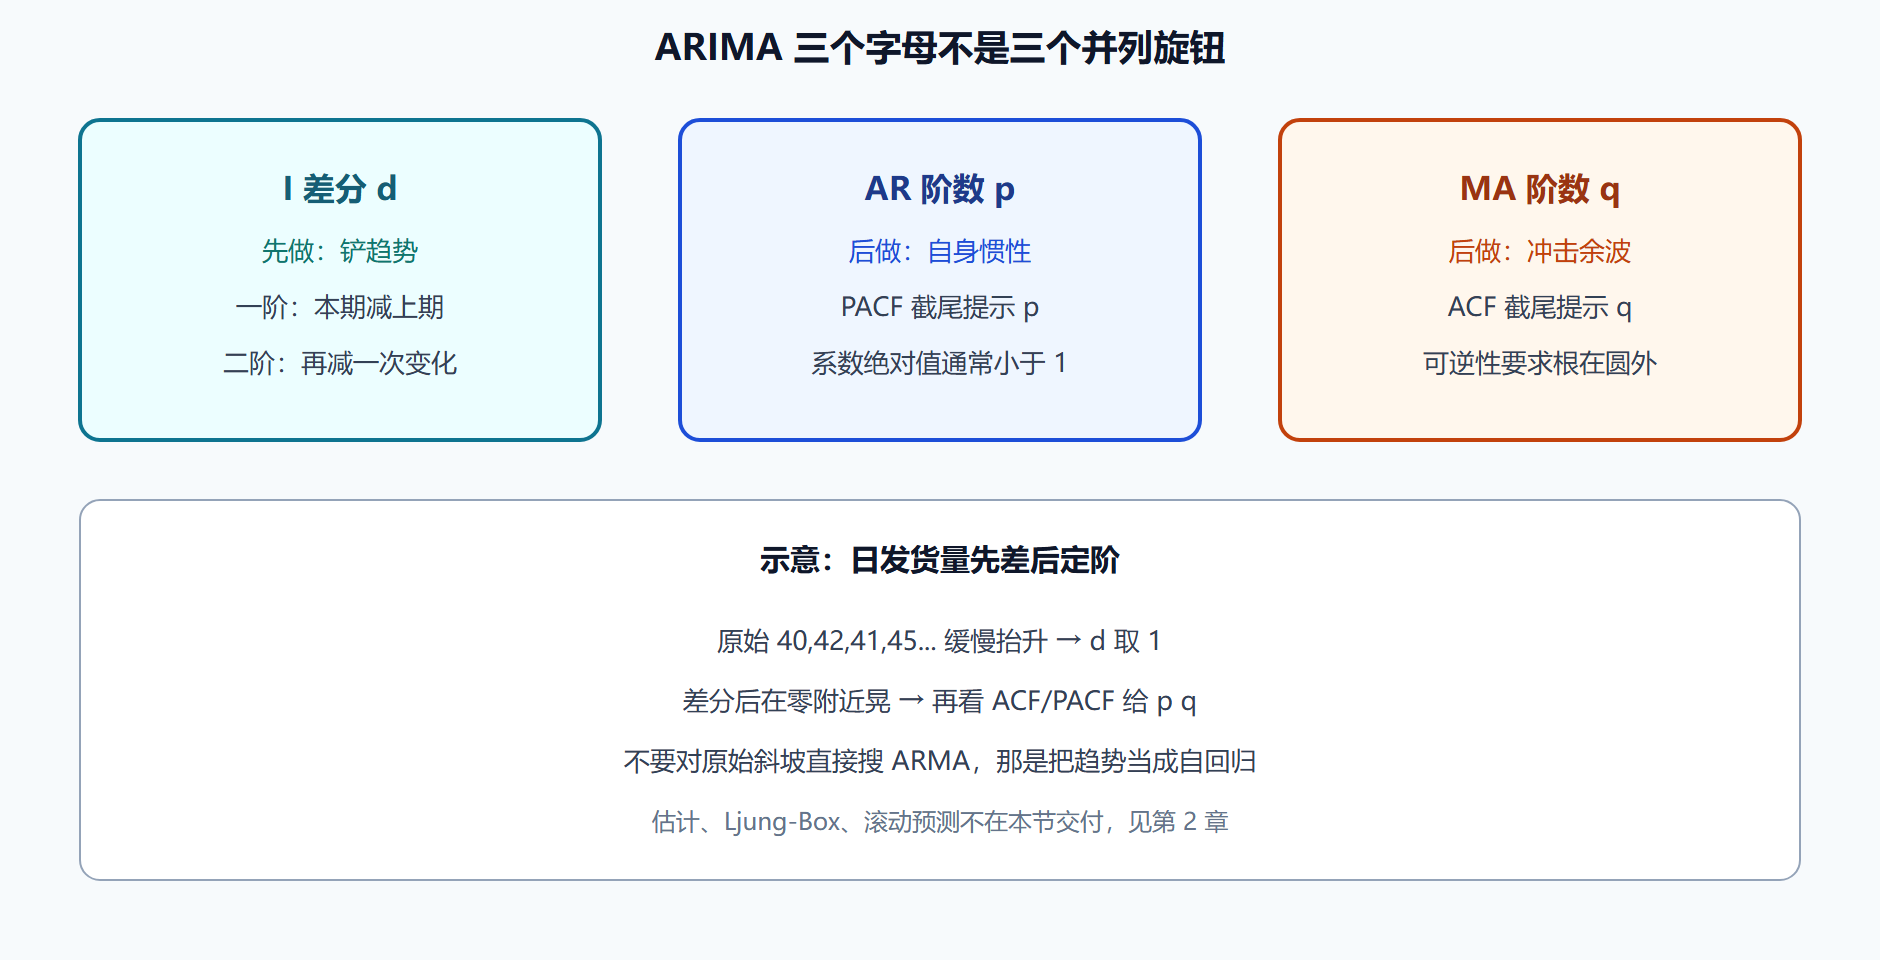
ARIMA 的全称是 Autoregressive Integrated Moving Average。拆开看:AR 是用过去的观测解释现在,MA 是用过去的冲击解释现在,I 不是「积分课」,在时间序列里它几乎总是「差分了几次」。模型记作 ARIMA(p, d, q):
- p:自回归阶数,当前值要回看几个自身滞后。
- d:差分次数,把趋势铲平要减几次相邻值。
- q:滑动平均阶数,当前值要回看几个过去误差。
对原始序列做 d 次差分之后,得到的序列被当成 ARMA(p, q)。这句话决定了动手顺序:先定 d,再在平稳序列上定 p 和 q。很多人一上来就把自动定阶函数对着原始带趋势序列猛跑,搜出来的 p、q 其实在拟合那条斜坡,而不是拟合平稳后的相关结构。
拿一条示意日发货量(单位:件,纯教学数字,不是某仓真实记录):
日序 1 2 3 4 5 6 7 8 9 10 11 12 件数 40 42 41 45 44 48 47 51 50 54 53 57
肉眼能看出缓慢抬升。一阶差分后变成大约:+2, -1, +4, -1, +4, … 均值附近晃,这才是 AR 和 MA 该说话的地方。若你坚持在原始序列上读 ACF,会看到相关系数衰减极慢——那是趋势造成的「假长记忆」,不是真的需要 AR(20)。
💡 关键直觉:d 回答「地板斜不斜」,p 和 q 回答「平地上的涟漪怎么传」。先铲地,再看涟漪。
二、Box-Jenkins 四步,动手只先走识别
经典建模不把「拟合一个函数」当成单次回归,而当成可循环的工序。原文把四步写得很清楚,这里按能跑的顺序重排措辞:
- 识别:看图,判断趋势和季节影子;用单位根检验或 ACF 慢衰减判断是否平稳;不平稳就差分直到平稳;再读平稳序列的 ACF/PACF,给出 p、q 候选。
- 估计:对每个候选用最大似然等方法估 φ 和 θ。
- 诊断:残差应接近白噪声——均值近零、方差稳定、彼此不相关。残差 ACF 再冒峰,或 Ljung-Box 拒绝白噪声,就回到识别。
- 预测:诊断过关才往未来推。单步和多步、固定原点和滚动原点,规则不同,第 2 章展开。
识别阶段有两处循环。第一处在定 d:差分一次,再检验,仍不平稳再差,通常到二阶该停。第二处在诊断失败后:不是把 p 盲目加到 8,而是先问「是不是漏了季节、是不是过差分、是不是方差在涨」。
图 三个字母对应的工序而不是三个旋钮一起拧
三、最小路径在示意序列上长什么样
把上面 12 个点只当作「手感训练」。真实工作里样本量要大得多:日数据至少数月,月数据最好数年,否则季节阶和信息准则都会发抖。最小路径可以写成概念步骤(接口名用常见统计库,不指定保存位置):
步骤 A 画折线:横轴日序,纵轴件数,问有没有斜坡、有没有七八天一循环 步骤 B 若有缺口,先按 1.3 的规则补,不要让检验吃进空值 步骤 C 对原始序列做 ADF;p 值若明显高于 0.05,倾向有单位根 步骤 D 一阶差分后再做 ADF;若拒绝单位根,d 记为 1 步骤 E 对差分序列画 ACF/PACF,按截尾拖尾列出两三个候选 步骤 F 把候选交给第 2 章估计,不要在这里用训练集 R 方宣布胜者
和指数平滑、朴素「用昨天预测明天」比,ARIMA 的成本是工序长、对平稳性苛刻;换来的是:参数可解释、诊断有统计量、预测区间有模型依据。和深度学习时序模型比,ARIMA 在短样本、弱非线性、需要向非算法同事讲清楚「为什么是这个数」时更合适当基线。原文也写过局限:线性假设、复杂异方差吃力、标准 ARIMA 不直接吃季节、对异常值敏感、读图有主观性。这些局限不是劝你放弃,而是提醒你:流水线要有出口——诊断失败就改阶或改 SARIMA,而不是加层数硬扛。
| 做法 | 适用 | 代价 |
|---|---|---|
| 朴素:明天等于今天 | 近乎随机游走、只要有个数 | 有趋势时系统性落后 |
| 只平滑、不定阶 | 季节明显、要快 | 说不清滞后结构 |
| 手工 Box-Jenkins | 要可复核、样本不算极短 | 读图主观、耗时 |
| 自动搜 p q 再诊断 | 候选多、当助手 | 仍要人看残差和季节 |
⚠️ 常见坑:把自动定阶的输出当成完工。函数最小化的是信息准则,不是「残差已白」也不是「持出样本误差最小」。没有诊断和滚动预测,那只是识别阶段的半成品。
信息准则原文给过形式:AIC 约等于负两倍对数似然再加 2 倍参数个数,BIC 把 2 换成样本量的对数,惩罚更狠。本节只要你记住:AIC/BIC 属于估计之后的比较,不属于本章的定 d。先把序列变成平稳的,再让准则在平稳世界里打架。
四、局限要挂在流水线出口上,而不是当附录空话
原文把 ARIMA 的局限写得很具体,动手时要把它们映射成「失败了去哪」。线性假设意味着促销与温度的交互、门限切换,不会被 p、q 自动学会;出口是加外生项或换方法,不是把阶加到 5。复杂异方差(波动成串)让高斯区间失效,出口是变换、分段或异方差模型,点预测仍可能留着 ARIMA。标准 ARIMA 不直接吃季节,出口是第 4 章的 SARIMA,而不是 MA(12)。异常值敏感,出口是第 1.3 节的定性,而不是让似然去「消化」错字。读图主观,出口是短名单加准则加残差,而不是一个人把 ACF 看到天黑。
把局限挂在出口上,流水线才有刹车。没有刹车的教程会变成:诊断失败就加阶,加阶后 AIC 更好,持出更差,然后责怪「ARIMA 过时」。过时的不是方法,是没有出口的用法。最小路径要求你在识别结束时只带走候选和一张「若失败则……」的便条,便条内容来自上述局限。第 2 章会把便条用起来。
再强调样本量。12 个示意点能让你看见斜坡,不能让你估 φ。日频至少覆盖数个星期循环,月频至少覆盖数年,否则季节影子和信息准则都会发抖。短样本更该先打朴素规则,而不是上完整 Box-Jenkins。这不是泄气,是避免把噪声当成阶。
五、动手对照:十二条示意点上你该留下什么
把 40,42,41,45,44,48,47,51,50,54,53,57 只当作手感。你应在笔记里留下:折线有缓慢抬升;一阶差分后在零附近晃;d 的候选是 1 而不是 0;p、q 尚未宣布唯一值。十二条不够估系数,所以本节禁止输出「最佳模型」。若有人用这十二条跑自动定阶并得到一个很大的 p,那是把趋势当成自回归,正好用来当反例。
问题:能不能跳过识别直接搜网格?
能当助手,不能当完工。网格不知道季节 m,也不知道过差分。搜完仍要看图、看残差。第 1 章的交付是候选加失败出口,不是一个元组。
问题:I 为什么叫积分却在做减法?
差分的逆是累加。预报时要把差分预测加回水平,这才是 Integrated 的实感。识别阶段你只做减法;第 2 章才做加回去。
六、场景推演(示意,非真实序列)
某仓要把「下周每天件数」交给拣货排班。你手头只有按日对齐的示意序列,没有促销日历,也没有天气。正确的第一周工作不是打开自动定阶,而是:画折线确认缓慢抬升;检查有没有周日空行;对原始序列做单位根对照;一阶差分后再看 ACF 是否还粘着。识别结束时笔记里只有 d=1 和三四个 (p,q),没有「最佳模型」字样。第二周才估计、验残差、用最后三周滚动一步去打「明天等于今天」。若滚动输了,流程的出口是承认近随机游走,而不是把第 1 章的候选写进报表。十二条教学点只用来在白板上演示差分,不能拿去交差给排班。把「识别交付候选、估计交付残差、滚动交付误差」三句话贴在仓控室,比贴 ARIMA 三个字母有用。局限也要同时贴上:线性吃不了大促交互,标准 ARIMA 吃不了星期,异常值会劫持检验。失败时按出口走,不要怪方法过时。
七、口令卡与计算备忘
口令:先 d 后 p、q;本章只交候选。计算备忘:一阶差分损失 1 个点,12 个示意点差分后剩 11 个,不够估 ARMA,只能看趋势是否被铲平。Box-Jenkins 四步里识别含两处循环,定 d 的再检验是本章的,诊断失败回定阶是第 2 章的,不要混成一次网格搜索。AIC 公式里的 2k 不属于本章,把它提前当定 d 工具等于跨尺度比较似然。局限映射成出口:线性失败加外生或换方法,季节失败去 SARIMA,尖点失败回预处理,读图主观用短名单约束。把这张口令卡和 1.1 的流程图对着贴,识别阶段就不会提前宣布最佳模型。自动定阶可以扩容,但扩容结果仍要经过图与单位根,否则只是把趋势搜进了 p。
八、原文要点补全
原文把经典方法放在 ARIMA 之前当基础与基准:朴素、简单平均、移动平均、分解、指数平滑、回归,都可能在特定形态上更省事。最小流水线不是宣称 ARIMA 必胜,而是先走通 Box-Jenkins,再用这些方法当第 4 章的对照桌。简单平均假设水平稳定,对有斜坡的发货量会系统性落后;窗口移动平均平滑的是 y 本身,和 MA(q) 加权冲击不是一回事,识别阶段不要把平滑线当已经做完 MA。分解能看见趋势与季节,但不能代替单位根检验,也不要在识别阶段用分解剩余项去定 p、q。指数平滑的 α、β、γ 是状态更新权重,和 φ、θ 语言不同,第 2 章才比较谁值班。把「基准先上桌」写进最小路径的出口,识别结束才不会误以为流水线必须以复杂阶交差。回归把时间或滞后当自变量时,仍要问残差是否白,否则只是换了一套伪回归。
要点速记
- 三个字母有顺序:先 d 后 p、q;I 在实务里就是差分次数。
- ARIMA 等于差分后的 ARMA:斜坡还在,ACF 会慢衰减,定阶全部失真。
- Box-Jenkins 是循环:识别 → 估计 → 诊断,残差不白就回去,不是一次回归。
- 本章交付候选阶:不要用拟合优度提前宣布最佳模型。
- 示意数字只练手感:12 个点能看趋势,不够当真拟合。
- 局限要挂在出口上:线性、季节、异常值、读图主观,对应第 2 章诊断和第 4 章 SARIMA。
- 自动定阶是助手:仍要人看图、看残差、看滚动误差。
下一节我们先把「时间序列」从普通表格里揪出来:顺序为什么不能打乱,以及趋势和季节在图上长什么样。